Cours - Systèmes de recommandation
Supports complémentaires :
[Diapositives du cours : 2 par page] [Diapositives du cours : 1 par page]
Ce chapitre est consacré aux systèmes de recommandation (SRec), une application importante et omniprésente de la fouille de données massives. Nous présentons d’abord les principes généraux et la problématique commune aux différentes approches. Nous examinons ensuite les méthodes basées sur la similarité de contenu, les méthodes de filtrage collaboratif par similarité puis par factorisation matricielle, et enfin les méthodes basées sur les graphes. Ces dernières prolongent naturellement les chapitres précédents sur les graphes et réseaux sociaux.
Problématique et terminologie
Un système de recommandation propose à un utilisateur des articles (items) susceptibles de l’intéresser, en exploitant des données comportementales ou des descriptions des articles. Les SRec sont présents dans de nombreux domaines : e-commerce (Amazon, « les clients ayant acheté ceci ont aussi acheté cela »), streaming vidéo (Netflix, YouTube), musique (Spotify), réseaux sociaux (suggestions de contacts), presse numérique.
Dans ces différentes applications, chaque utilisateur peut choisir et/ou noter un ou plusieurs articles. Les données disponibles concernant les choix passés (ou les notes) sont représentées sous la forme d’une matrice d’utilités où chaque ligne correspond à un utilisateur et chaque colonne à un article.
\[\begin{split}\begin{array}{c|cccccccc} & A1 & A2 & A3 & A4 & A5 & A6 & A7 & \ldots\\ \hline U1 & 9 & & & & & & 2 & \\ U2 & 2 & & 8 & & & & 7 & \\ U3 & & & & & 4 & & & \\ \ldots & & & & & & & & \end{array}\end{split}\]
Un élément \(x_{ij}\) de cette matrice représente la note (explicite) ou l’interaction (implicite : achat, clic, durée d’écoute) de l’utilisateur \(i\) avec l’article \(j\). Cette matrice est très creuse : un utilisateur n’interagit qu’avec une infime fraction des articles disponibles.
L’objectif général d’une méthode de recommandation est de prédire les valeurs manquantes de la matrice, c’est à dire les choix que ferait chaque utilisateur s’il devait se prononcer sur chaque article ou les notes qu’il donnerait s’il devait évaluer tous les articles. Naturellement, lorsque la matrice contient des notes, ce sont en général les valeurs élevées prédites qui intéressent car elles correspondent (si la prédiction est fiable) à des articles que l’utilisateur apprécierait et que le SRec pourrait donc utilement lui proposer. Il est également possible de chercher à prédire directement l’ordre de préférence d’un utilisateur pour les articles qu’il n’a pas encore notés, sans passer par la prédiction intermédiaire des notes.
On distingue trois grandes familles de méthodes :
Recommandation par similarité de contenu (content-based filtering) : on exploite les descriptions des articles pour construire un profil de l’utilisateur et proposer les articles les plus similaires à ce profil. Ne nécessite pas l’accès aux choix faits par d’autres utilisateurs.
Filtrage collaboratif (collaborative filtering) : on exploite la matrice d’utilités pour déduire les préférences d’un utilisateur à partir de celles des utilisateurs similaires (ou des articles similaires). Ne nécessite pas de description des articles.
Méthodes hybrides : combinaisons des deux approches précédentes et, plus récemment, de méthodes basées sur les graphes et l’apprentissage profond. La plupart des SRec emploient aujourd’hui des méthodes hybrides.
Le démarrage à froid (cold start) est une difficulté commune à toutes ces méthodes : lorsqu’un nouvel utilisateur ou un nouvel article apparaît, il n’y a pas encore d’historique d’interaction pour calibrer les recommandations et des approches spécifiques sont nécessaires. Pour un nouvel utilisateur il est possible d’exploiter son profil démographique, de lui demander explicitement des préférences initiales ou simplement de lui recommander les articles les plus populaires. Pour un nouvel article il est envisageable d’exploiter sa description ou de déterminer quel article plus ancien il est censé remplacer.
Recommandation par similarité de contenu
La description d’un article peut inclure des variables de natures diverses : variables ensemble (acteurs d’un film, mots d’une description textuelle), variables nominales (genre musical, langue), variables quantitatives (durée du film, budget). Ces variables sont concaténées dans un vecteur de description. Les variables de type ensemble peuvent bénéficier d’une pondération TF-IDF (fréquence dans l’item / fréquence inverse dans la collection, voir le cours sur la fouille de texte). Des méthodes de réduction de dimension (ACP, plongements de mots) sont souvent appliquées pour réduire la dimension de ces vecteurs et le bruit présent.
Le profil d’un utilisateur est construit comme la moyenne pondérée (par les notes) des descriptions des articles qu’il a choisis ou notés. Il est représenté dans le même espace que les descriptions des articles, ce qui permet une recherche par similarité directe : les articles les plus similaires au profil de l’utilisateur lui sont proposés.
La recommandation peut également être faite en mode push : une jointure par similarité entre l’ensemble des profils utilisateurs et l’ensemble des descriptions d’articles produit un ensemble de paires <article, utilisateur> potentiellement pertinentes, exploitables pour une campagne de courriels même quand les utilisateurs ne sont pas connectés.
Des critères pragmatiques complémentaires peuvent améliorer l’expérience, par exemple tenir compte de la disponibilité des articles ou réduire la redondance des propositions (ne pas suggérer plusieurs articles très similaires entre eux).
La recommandation étant réalisée à partir des caractéristiques des articles, il est facile d’identifier des articles de substitution lorsque l’article envisagé n’est plus disponible. En revanche, il est difficile d’extrapoler d’un domaine à un autre. Par exemple, connaître les lectures préférées d’un utilisateur donne peu d’indications sur ses goûts musicaux.
Recommandation par filtrage collaboratif
Méthodes basées sur la similarité (memory-based)
La matrice d’utilités est normalisée : pour chaque utilisateur (ligne), la moyenne des notes présentes est soustraite afin d’équilibrer les niveaux d’exigence. Les profils utilisateurs (lignes) et les profils articles (colonnes) sont comparés par corrélation de Pearson ou par d’autres mesures de similarité entre vecteurs creux.
Deux variantes sont employées :
User-based : (i) identifier les \(k\) utilisateurs les plus similaires à l’utilisateur cible \(u\), (ii) proposer à \(u\) les articles (qu’il n’a pas encore consultés) les mieux notés par ces « voisins ». La prédiction de la note que \(u\) donnerait à un article \(a\) est typiquement une moyenne pondérée par les similarités entre utilisateurs :
Item-based : (i) identifier les articles les plus similaires aux articles déjà bien notés par \(u\), (ii) proposer à \(u\) ces articles. Comme le nombre d’utilisateurs dépasse souvent le nombre d’articles, les profils articles ont une dimension plus élevée : la malédiction de la dimension se manifeste avec plus de force pour les profils articles que pour les profils utilisateurs.
Les similarités n’étant pas liées aux caractéristiques intrinsèques des articles ou des utilisateurs, les prédictions dans un domaine peuvent être faites à partir de données concernant d’autres domaines (l’hypothèse d’une cohérence relative inter-domaines est sous-jacente). En revanche, l’ignorance des caractéristiques des articles rend difficile la substitution d’articles manquants.
Ces méthodes sont simples et interprétables, mais coûteuses en calcul à grande échelle car il faut maintenir et interroger une matrice de similarités entre utilisateurs ou entre articles.


Filtrage collaboratif par factorisation matricielle
Les méthodes de filtrage collaboratif basées sur un modèle (model-based) sont plus récentes que celles basées sur la similarités. Un modèle permettant la prise de décisions de recommandation est obtenu à partir du contenu actuel de la matrice d’utilités. La factorisation matricielle est une des approches de modélisation les plus connues.
Le principe des méthodes de factorisation matricielle est de chercher des facteurs latents, en nombre réduit \(m\) (typiquement quelques dizaines à quelques centaines), qui « expliquent » le contenu de la matrice d’utilités. Chaque utilisateur et chaque article sont représentés par un vecteur de dimension \(m\) dans cet espace latent. La note prédite est le produit scalaire de ces deux vecteurs. Dans le vecteur qui décrit un article les composantes correspondent aux valeurs prises par les facteurs latents respectifs pour cet article. Dans le vecteur qui décrit un utilisateur les composantes correspondent aux contributions des facteurs latents respectifs à la note que l’utilisateur donnerait à un article. Les facteurs latents sont déterminés par l’algorithme de factorisation et sont rarement interprétables.
SVD et approximation de rang réduit
Une première idée est d’utiliser la décomposition en valeurs singulières (SVD) :
où \(\Sigma\) est diagonale (\(m \times m\)), les colonnes de \(\mathbf{A}^T\) sont les représentations des articles, les lignes de \(\mathbf{U}\) celles des utilisateurs.
Cette approche souffre d’un problème fondamental : la SVD exige une matrice complète, or les valeurs absentes de la matrice d’utilités sont manquantes (et non égales à une note moyenne). Substituer les valeurs manquantes par une note moyenne biaise fortement la décomposition.
Factorisation matricielle régularisée
La factorisation régularisée [KBV09] résout ce problème en optimisant uniquement sur les valeurs présentes dans la matrice, avec une régularisation pour éviter le sur-apprentissage :
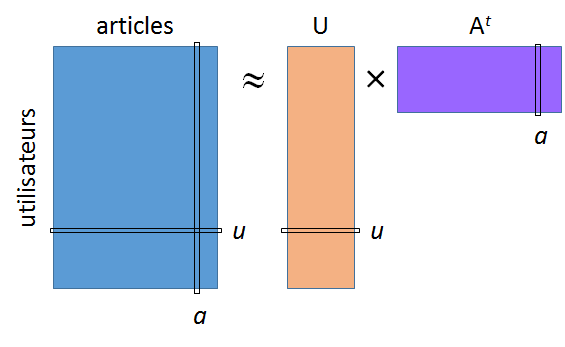
Fig. 111 Factorisation matricielle régularisée
Les matrices \(\mathbf{U}\) et \(\mathbf{A}^T\) ont \(m\) colonnes et respectivement \(m\) lignes.
Après optimisation, la prédiction de la note de l’utilisateur \(k\) pour l’article \(l\) est simplement :
Des extensions importantes peuvent être ajoutées [KBV09] :
Biais par utilisateur et par article : Le problème d’optimisation devient
\(\min_{\mathbf{u}_i, \mathbf{a}_j, b_{\mathbf{u}}, b_{\mathbf{a}}} \sum_{\textrm{Present}(i,j)} (x_{ij} - \mu - b_{\mathbf{u}_i} - b_{\mathbf{a}_j} - \mathbf{u}_i^T \cdot \mathbf{a}_j)^2 + \lambda\left[\sum_i(\left\|\mathbf{u}_i\right\|^2 + b_{\mathbf{u}_i}^2) + \sum_j(\left\|\mathbf{a}_j\right\|^2 + b_{\mathbf{a}_j}^2)\right]\)
où \(\mu\) est la moyenne globale des notes présentes, \(b_{\mathbf{u}_i}\) le biais pour l’utilisateur \(i\) et \(b_{\mathbf{a}_j}\) le biais pour l’article \(j\). Ces biais sont appris conjointement avec les facteurs latents.
Niveaux de confiance : Le problème d’optimisation est dans ce cas
\(\min_{\mathbf{u}_i, \mathbf{a}_j, b_{\mathbf{u}}, b_{\mathbf{a}}} \sum_{\textrm{Present}(i,j)} c_{ij} (x_{ij} - \mu - b_{\mathbf{u}_i} - b_{\mathbf{a}_j} - \mathbf{u}_i^T \cdot \mathbf{a}_j)^2 + \lambda\left[\sum_i(\left\|\mathbf{u}_i\right\|^2 + b_{\mathbf{u}_i}^2) + \sum_j(\left\|\mathbf{a}_j\right\|^2 + b_{\mathbf{a}_j}^2)\right]\)
où \(c_{ij}\) est la confiance dans la note donnée par l’utilisateur \(i\) à l’article \(j\) ou, plus généralement, une pondération (dont la signification n’est pas nécessairement celle de degré de confiance) de cette note. Les \(c_{ij}\) sont des données d’entrée de l’algorithme et non obtenus par l’optimisation.
Algorithme ALS pour la factorisation régularisée
L’optimisation mise en œuvre dans Spark emploie une modification de la régularisation suivant [ZWS08] :
où \(n_i\) est le nombre de notes données par l’utilisateur \(i\) et \(n_j\) le nombre de notes reçues par l’article \(j\).
Ce problème d’optimisation est résolu dans Spark par l’algorithme ALS (Alternating Least Squares). Il s’appuye sur l’observation que la fonction de coût (14) (comme d’ailleurs (13)) n’est pas convexe en \((\mathbf{u}_i, \mathbf{a}_j)\) conjointement, mais elle est convexe séparément pour chacun quand l’autre est fixé. On alterne donc :
Phase A : avec \(\mathbf{U}\) fixée, pour tout \(j\) trouver \(\mathbf{a}_j\) qui minimise \(\|\mathbf{x}_j - \mathbf{U} \mathbf{a}_j\|^2 + \lambda n_j \|\mathbf{a}_j\|^2\) (\(\mathbf{x}_j\) est la colonne \(j\) de \(\mathbf{X}\), \(\mathbf{a}_j\) la colonne \(j\) de \(\mathbf{A}^T\)), on obtient \(\mathbf{a}_j = (\mathbf{U}^T \mathbf{U} + \lambda n_j \mathbf{I})^{-1} \mathbf{U}^T \mathbf{x}_j\) ;
Phase U : avec \(\mathbf{A}\) fixée, pour tout \(i\) trouver \(\mathbf{u}_i\) qui minimise \(\|\mathbf{x}_i - \mathbf{u}_i \mathbf{A}^T\|^2 + \lambda n_i \|\mathbf{u}^T_j\|^2\) (\(\mathbf{x}_i\) est la ligne \(i\) de \(\mathbf{X}\), \(\mathbf{u}_i\) la ligne \(i\) de \(\mathbf{U}\)), on obtient \(\mathbf{u}^T_i = (\mathbf{A}^T \mathbf{A} + \lambda n_i \mathbf{I})^{-1} \mathbf{A}^T \mathbf{x}^T_i\).
Chaque phase est parallélisable : les systèmes linéaires pour les différents articles (ou utilisateurs) sont indépendants.
ALS converge vers un minimum local (et non nécessairement global), il est donc utile de faire plusieurs essais avec des initialisations différentes. La qualité de la solution dépend du rang \(m\), du paramètre de régularisation \(\lambda\) et du nombre d’itérations.
Le réglage des valeurs de ces hyper-paramètres est fait par une recherche en grille avec validation croisée sur la matrice d’utilités : on masque une fraction des notes présentes (cette fraction devient un ensemble de test), on entraîne le modèle sur le reste et on mesure l’erreur de prédiction sur les notes masquées.
Recommandation basée sur les graphes
Les méthodes présentées jusqu’ici ne capturent que les interactions directes utilisateur–article. Les méthodes basées sur les graphes exploitent la structure relationnelle de second ordre (et au-delà) : l’influence des amis des amis, la propagation de préférences dans un réseau, la structure communautaire.
Modélisation par graphe biparti
Le point de départ est le graphe biparti utilisateurs–articles \(G = (U \cup A, E)\), où \(U\) est l’ensemble des utilisateurs, \(A\) l’ensemble des articles, et une arête \((u, a) \in E\) indique une interaction (note, achat, clic) entre l’utilisateur \(u\) et l’article \(a\). Le poids de l’arête encode la force de l’interaction (note, nombre de clics, etc.).
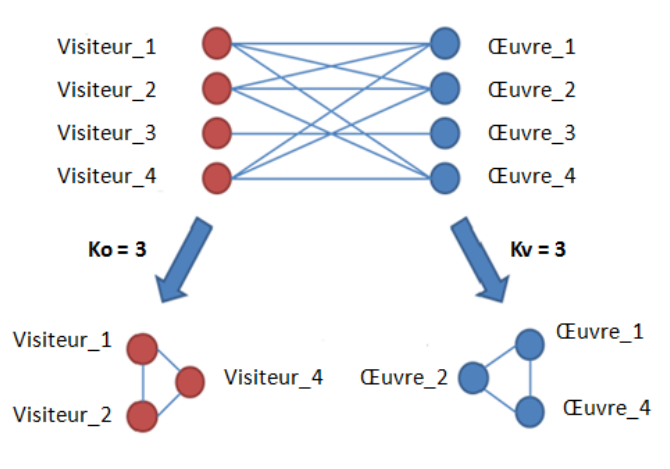
Fig. 112 Graphe biparti utilisateurs–articles (ici, visiteurs d’un musée vs œuvres exposées)
Ce graphe encode la même information que la matrice d’utilités, mais sa structure permet d’appliquer directement les algorithmes de graphes pour la recommandation.
PageRank personnalisé (PPR)
Le PageRank personnalisé (Personalized PageRank, PPR) depuis un nœud source \(u\) mesure la proximité structurelle de chaque nœud du graphe par rapport à \(u\) (cf. cours graphes et réseaux sociaux). Les articles ayant le plus fort score \(\text{PPR}_u\) sont ceux vers lesquels le marcheur aléatoire, partant de \(u\), revient le plus souvent, c’est-à-dire ceux connectés à \(u\) par de nombreux chemins courts via des utilisateurs similaires. On définit ici la similarité entre nœuds par le coefficient de Jaccard des voisinages dans le graphe : cardinal de l’intersection des voisinages divisé par le cardinal de l’union.
Par rapport au filtrage collaboratif classique, PPR a l’avantage d’exploiter les chemins de longueur supérieure à 2 (amis des amis) et non seulement les voisins directs.
Projections du graphe biparti
Nous pouvons projeter le graphe biparti sur l’un des deux ensembles de nœuds :
Projection utilisateur-utilisateur : une arête est posée entre \(u\) et \(v\) si les deux utilisateurs ont interagi avec au moins un article commun (ou \(K\) articles communs, voir Fig. 112), avec un poids proportionnel au nombre d’articles communs (ou à un indice de Jaccard entre leurs voisinages). Sur ce graphe projeté on détecte des communautés d’utilisateurs aux goûts similaires.
Projection article-article : une arête est posée entre \(a\) et \(b\) si les deux articles ont été choisis par au moins un utilisateur commun (ou \(K\) utilisateurs communs). Ce graphe permet de définir des relations de similarité entre articles sans accès à leurs descriptions.
Dans les deux cas, la détection de communautés (Louvain, propagation d’étiquettes) sur les graphes projetés produit des segments d’utilisateurs ou des groupes d’articles similaires. La recommandation consiste alors à proposer à l’utilisateur \(u\) des articles (qu’il n’a pas encore consultés) populaires dans sa communauté, ou des articles issus des communautés des articles qu’il a appréciés.
Graphes enrichis par des métadonnées
Le graphe biparti de base peut être enrichi avec des nœuds et arêtes supplémentaires provenant de sources hétérogènes :
Relations sociales : si on dispose du graphe de suivi ou d’amitié entre utilisateurs (réseau social), on l’ajoute au graphe biparti. La recommandation sociale (social recommendation) exploite alors le principe d’homophilie : les amis ont souvent des goûts similaires.
Connaissances sur les articles : les articles peuvent être reliés à des entités (genres, acteurs, réalisateurs, étiquettes) par des arêtes typées. Ce graphe de connaissance (knowledge graph) enrichit les représentations et permet des recommandations explicables, par exemple « nous vous proposons ce film car il est réalisé par X, que vous appréciez ».
Séquences temporelles : dans certains contextes (e-commerce, streaming) l’ordre des interactions est important. Le graphe peut intégrer des arêtes orientées entre sessions consécutives d’un même utilisateur.
Le graphe résultant est hétérogène, c’est à dire comporte plusieurs types de nœuds et d’arêtes.
Plongements de graphes pour la recommandation
Les méthodes de plongement de graphe (graph embedding) généralisent les techniques de plongement de mots (comme Word2Vec) aux graphes : on apprend un vecteur dense pour chaque nœud tel que les nœuds structurellement proches dans le graphe possèdent des vecteurs proches dans l’espace latent.
Node2Vec [GL16] est une méthode classique : on génère des marches aléatoires biaisées sur le graphe (favorisant l’exploration locale ou distante selon les valeurs des hyperparamètres), puis on applique Word2Vec sur ces séquences de nœuds. Les vecteurs résultants sont employés pour calculer des similarités entre utilisateurs ou entre articles.
LightGCN [HDWT20] est une architecture de réseau de neurones convolutifs sur graphe (Graph Convolutional Network), simplifiée et optimisée pour la recommandation : chaque couche propage les représentations des voisins et les représentations finales sont des combinaisons linéaires de celles obtenues dans toutes les couches. LightGCN dépasse systématiquement les méthodes de factorisation matricielle classiques sur les benchmarks standard.
Pour les graphes hétérogènes mentionnés dans la sous-section précédente, des algorithmes comme metapath2vec [DCS17] ou HAN (Heterogeneous Graph Attention Network, [WJS19]) sont employés pour apprendre des représentations vectorielles des nœuds.
En pratique
Pour un prototypage rapide sur un graphe de taille modérée, PPR est immédiatement
disponible via GraphFrames (pageRank avec sourceId). Pour un système
de production sur des millions d’utilisateurs et d’articles, les méthodes de
plongement de graphe offrent le meilleur rapport qualité/coût de l’état de l’art.
Comparaison des approches
Méthode |
Données requises |
Cold start |
Passage à l’échelle |
Explicabilité |
|---|---|---|---|---|
Similarité de contenu |
Descriptions des articles |
Utilisateur OK, article difficile |
Bon |
Bonne |
CF mémoire (user/item) |
Matrice d’utilités |
Difficile |
Moyen |
Modérée |
CF factorisation (ALS) |
Matrice d’utilités |
Difficile |
Excellent (Spark) |
Faible |
Graphe + PPR |
Graphe biparti |
Difficile |
Bon |
Bonne (chemins) |
Plongement de graphe |
Graphe enrichi |
Article OK |
Excellent |
Faible |
Évaluation des systèmes de recommandation
Les métriques employées pour évaluer les performances des SRec sur un ensemble de test \(\mathcal{T}\) sont :
RMSE (Root Mean Square Error) : \(\sqrt{\frac{1}{|\mathcal{T}|}\sum_{(i,j)\in \mathcal{T}}(x_{ij}-\hat{x}_{ij})^2}\) pour mesurer l’écart entre notes prédites et notes constatées ; est très sensible aux grandes erreurs (à cause des carrés).
MAE (Mean Absolute Error) : \(\frac{1}{|\mathcal{T}|}\sum_{(i,j)\in \mathcal{T}}|x_{ij}-\hat{x}_{ij}|\) est plus robuste.
Précision@k et Rappel@k : quelle fraction est pertinente parmi les \(k\) articles recommandés, respectivement quelle fraction des articles pertinents a été recommandée.
NDCG@k (Normalized Discounted Cumulative Gain) : tient compte de l’ordre des recommandations, car un article pertinent en tête de liste est plus précieux qu’en fin de liste.
La RMSE et la MAE sont adaptées aux notes explicites, alors que la précision, le rappel et NDCG sont préférables pour évaluer la qualité du classement dans les contextes de feedback implicite.
Références
Beel, J., Gipp, B., Langer, S., Breitinger, C. Research-paper recommender systems: a literature survey. International Journal on Digital Libraries, 2015.
Bobadilla, J., Ortega, F., Hernando, A., Gutiérrez, A. Recommender systems survey. Knowledge-Based Systems, 46:109–132, 2013.
Grover, A. and Leskovec, J. node2vec: Scalable Feature Learning for Networks. KDD 2016.
He, X., Deng, K., Wang, X., Li, Y., Zhang, Y., Wang, M. LightGCN: Simplifying and Powering Graph Convolution Network for Recommendation. SIGIR 2020.
Koren, Y., Bell, R., Volinsky, C. Matrix factorization techniques for recommender systems. Computer, 42(8):30–37, 2009.
Paterek, A. Improving regularized singular value decomposition for collaborative filtering. KDD Cup Workshop, SIGKDD 2007.
Poullot, S., Crucianu, M., Buisson, O. Scalable Mining of Large Video Databases Using Copy Detection. ACM Multimedia 2008.
Zhang, S., Yao, L., Sun, A. Deep learning based recommender system: A survey and new perspectives. CoRR, abs/1707.07435, 2017.
Zhou, Y., Wilkinson, D., Schreiber, R., Pan, R. Large-scale parallel collaborative filtering for the netflix prize. AAIM 2008.coursSystemesRecommandation
Yuxiao Dong, Nitesh V. Chawla, and Ananthram Swami. Metapath2vec: Scalable Representation Learning for Heterogeneous Networks. In Proc. KDD’17. ACM, New York, NY, USA, 135–144. https://doi.org/10.1145/3097983.3098036
Xiao Wang, Houye Ji, Chuan Shi, Bai Wang, Yanfang Ye, Peng Cui, and Philip S Yu. Heterogeneous Graph Attention Network. In WWW “19. ACM, New York, NY, USA, 2022–2032. https://doi.org/10.1145/3308558.3313562