Cours - Approches sans distribution
Supports complémentaires :
[Diapositives du cours : 2 par page] [Diapositives du cours : 1 par page]
Cette séance couvre les approches permettant de traiter de grands volumes de données sans recourir à une plateforme distribuée (cluster). Deux familles de méthodes sont présentées : d’abord la réduction du volume de données (réduction du nombre d’observations par échantillonnage, réduction du nombre de variables par des méthodes factorielles), ensuite le calcul plus efficace sur une seule machine grâce aux bibliothèques Python Polars et Dask.
Ces approches ne remplacent pas le calcul distribué pour des volumes de données réellement massifs, mais elles permettent souvent de repousser significativement les limites d’une architecture centralisée et donc d’éviter la complexité opérationnelle d’un cluster dans de nombreux cas pratiques.
Réduction du volume de données
Réduire le volume de données consiste à travailler sur un sous-ensemble représentatif des données originales, soit en diminuant le nombre d’observations (échantillonnage), soit en réduisant le nombre de variables (réduction de dimension). Les résultats obtenus sont en général des approximations de ceux que l’on obtiendrait sur les données complètes. Cette approche présente un risque majeur lorsque les données ont une faible densité en information : un échantillon trop petit ou un espace de représentation trop restreint peuvent rendre les régularités recherchées indétectables ou les résultats insuffisants.
Calculs sur un échantillon
L’échantillonnage vise à inférer des propriétés concernant toute la « population » de \(N\) données à partir d’un sous-ensemble (échantillon) de seulement \(n \ll N\) données. Une présentation détaillée peut être trouvée par exemple dans [Til01].
Les méthodes non aléatoires (choix d’expert, volontariat, etc.) répondent souvent à des considérations pragmatiques, mais il est difficile d’y qualifier la représentativité de l’échantillon. Les méthodes aléatoires offrent des garanties statistiques ; les trois principales sont les suivantes.
L’échantillonnage simple consiste à faire des tirages indépendants, habituellement sans remise, chaque observation ayant la même probabilité d’être sélectionnée : \(p_s = \frac{n}{N}\).
L’échantillonnage stratifié considère que l’ensemble de données est constitué de sous-ensembles (strates) présentant une certaine homogénéité interne. Un échantillonnage simple est appliqué dans chaque strate. Par rapport à un échantillonnage simple global, cette approche augmente la précision pour une même valeur de \(n\) ou conserve la précision avec un \(n\) plus faible. Il est possible de moduler la représentation des strates en choisissant un taux de sélection \(p_s\) différent dans chacune.
Exemple :
Pour une étude des pratiques des clients du commerce en ligne, on considère qu’il y a une certaine homogénéité à l’intérieur de chaque tranche de revenus. Les effectifs des différentes tranches de revenus étant très déséquilibrés, un échantillonnage simple global ne conserverait pas bien la proportion relative de chaque tranche. Un échantillonnage stratifié (1 strate = 1 tranche de revenus) avec le même taux de sélection dans chaque strate règle ce problème.
L’échantillonnage en grappes s’applique lorsque les données sont naturellement organisées en sous-ensembles (grappes) tels que les différences intra-grappe sont plus fortes que les différences inter-grappe. On sélectionne alors aléatoirement des grappes et on retient toutes les observations de chaque grappe sélectionnée.
Exemple :
Pour une étude des pratiques sportives des élèves de troisième dans des zones urbaines, on considère qu’il y a autant de diversité à l’intérieur d’un même collège qu’entre collèges. Plutôt que d’interroger quelques élèves dans chaque collège (échantillonnage simple), on sélectionne quelques collèges et on interroge tous leurs élèves de troisième ; cette solution est bien plus facile à mettre en œuvre car on contacte seulement un échantillon de collèges.
Quelle que soit la méthode, la taille de l’échantillon doit être suffisante pour que les régularités recherchées s’y manifestent. Nous remarquerons que l’échantillonnage en grappes facilite le recueil de données mais ne présente pas d’intérêt particulier lorsque toutes les données sont déjà disponibles et nous souhaitons simplement réduire leur volume. Nous utiliserons l’échantillonnage simple ou l’échantillonnage stratifié pour répondre à cet objectif.


Réduction de dimension
Considérons \(N\) observations définies dans \(\mathbb{R}^m\). Une réduction de dimension consiste à obtenir une représentation des données dans \(\mathbb{R}^k\), avec \(k \ll m\). Cette diminution du nombre de variables peut répondre à plusieurs objectifs : réduire le volume de données à traiter tout en conservant l’information utile ; améliorer le rapport signal/bruit ; faciliter la visualisation ; atténuer la malédiction de la dimension (voir la séance sur la réduction de complexité).
Deux grandes approches existent :
La sélection de variables (feature selection, voir la synthèse de [TAL14]) consiste à
choisir un sous-ensemble de \(k\) variables parmi les \(m\) initiales. Les variables sélectionnées conservent leur signification originale, ce qui facilite l’interprétation des modèles. En revanche, la recherche du meilleur sous-ensemble de taille \(k\) est combinatoire (\(C_m^k\) possibilités) et requiert des heuristiques : tri des variables par un critère de pertinence individuel (par exemple, le test du \(\chi^2\)), ou construction incrémentale/décrémentale.
La transformation de variables (feature extraction) construit de nouvelles variables
comme combinaisons des variables initiales. Cette approche est en général plus puissante que la sélection mais les nouvelles variables sont rarement interprétables directement.
Les nouvelles variables sont obtenues par des méthodes qui peuvent être (voir les figures suivantes) - linéaires : trouver un sous-espace linéaire de dimension \(k\) dans
\(\mathbb{R}^m\) (méthodes factorielles classiques : ACP, AFD, ACM) ;
non linéaires : trouver une variété (manifold) de dimension \(k\) dans \(\mathbb{R}^m\) (Isomap, t-SNE, UMAP, autoencodeurs, etc.).
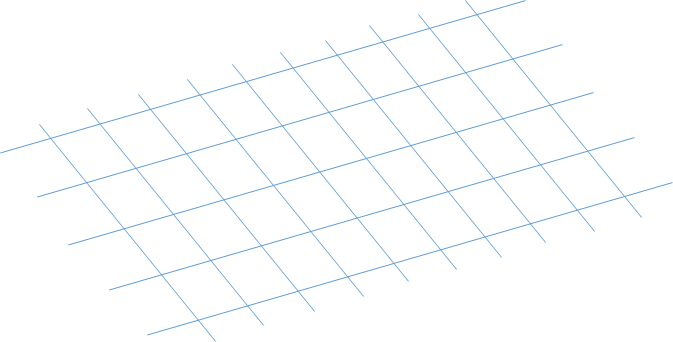
Fig. 3 Sous-espace bidimensionnel linéaire dans l’espace tridimensionnel
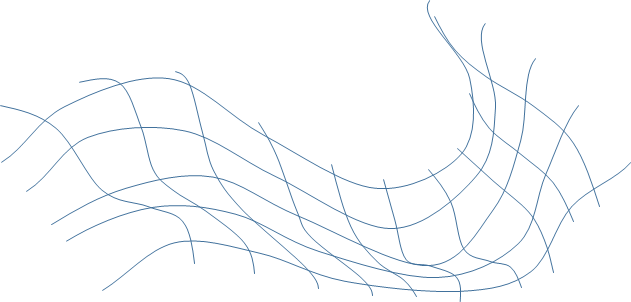
Fig. 4 Sous-espace bidimensionnel non linéaire dans l’espace tridimensionnel
Nous rappelons ci-dessous les trois méthodes factorielles linéaires les plus utilisées. Pour des présentations détaillées, voir [CABB04], [Sap11] et le support de l’UE RCP208.
Analyse en composantes principales (ACP)
L’ACP est une méthode exploratoire : à partir de \(N\) observations décrites par \(m\) variables quantitatives, elle cherche \(k < m\) nouvelles variables — les composantes principales — obtenues comme combinaisons linéaires des variables initiales, en conservant le maximum de variance.
Dans l’analyse de données massives, l’ACP est principalement utilisée pour :
condenser la représentation des données tout en conservant leur organisation globale ;
visualiser en faible dimension l’organisation prépondérante des données ;
éliminer des sous-espaces de faible variance (souvent assimilés à du bruit) avant l’application de méthodes décisionnelles.
Variantes. Selon le pré-traitement appliqué à la matrice de données \(\mathbf{R}\) :
ACP centrée : centrage préalable des variables (moyenne nulle). Employée quand les variables sont directement comparables (même nature, intervalles proches).
ACP normée (la plus courante) : centrage et réduction préalables (moyenne nulle, écart-type unitaire). Employée quand les variables sont de nature différente ou ont des intervalles de variation très différents.
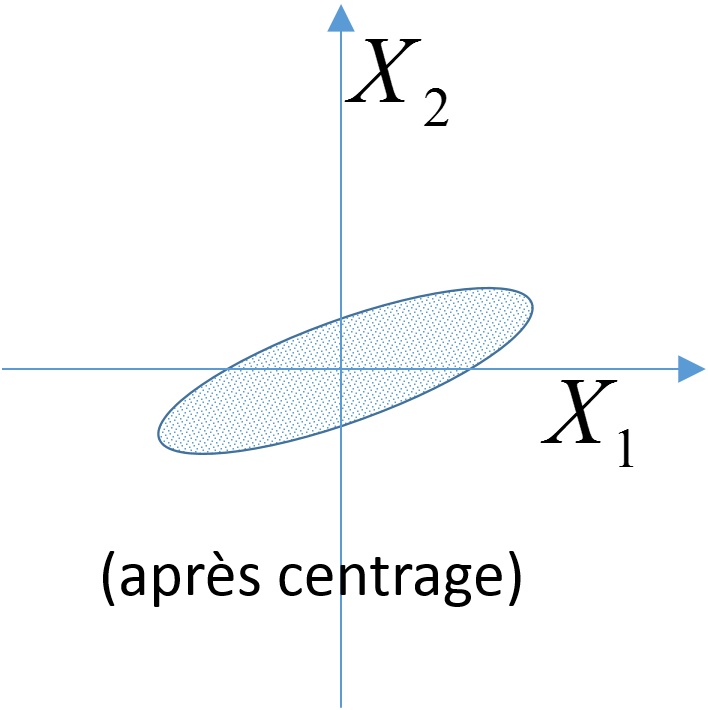
Fig. 5 ACP centrée¶ |
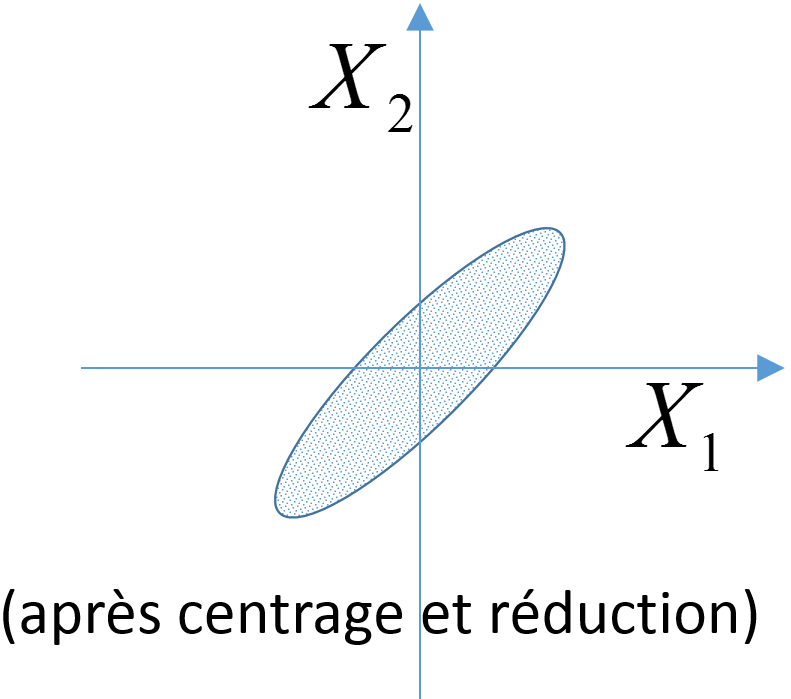
Fig. 6 ACP normée¶ |
Calcul. Pour l’analyse du nuage des observations, on cherche les \(k\) vecteurs propres \(\mathbf{u}_{\alpha}\) associés aux \(k\) plus grandes valeurs propres \(\lambda_{\alpha}\) de la matrice \(\mathbf{X}^T \mathbf{X}\) :
Pour l’ACP centrée, \(\mathbf{X}^T \mathbf{X}\) est la matrice des covariances empiriques ; pour l’ACP normée, c’est la matrice des corrélations empiriques. Comme en général \(N \gg m\), on travaille sur \(\mathbf{X}^T \mathbf{X}\) de dimension \(m \times m\) plutôt que sur \(\mathbf{X}\mathbf{X}^T\) de dimension \(N \times N\).
Pour obtenir toutes les valeurs propres, la complexité est \(O(m^3)\). Pour obtenir seulement les \(k\) plus grandes (cas courant en données massives), un algorithme itératif de complexité \(O(Nmk)\) est employé ; si les données sont creuses (chaque variable est non nulle pour au plus \(p \ll N\) observations), la complexité tombe à \(O(pmk)\).
Exemples. La figure suivante montre la projection de \(N = 5500\) descripteurs visuels (données textures, \(m = 40\) variables, 11 classes) sur les deux premières composantes principales. L’ACP ne tient pas compte des classes, mais les couleurs permettent de voir dans quelle mesure la projection sur les directions de variance maximale sépare les classes.
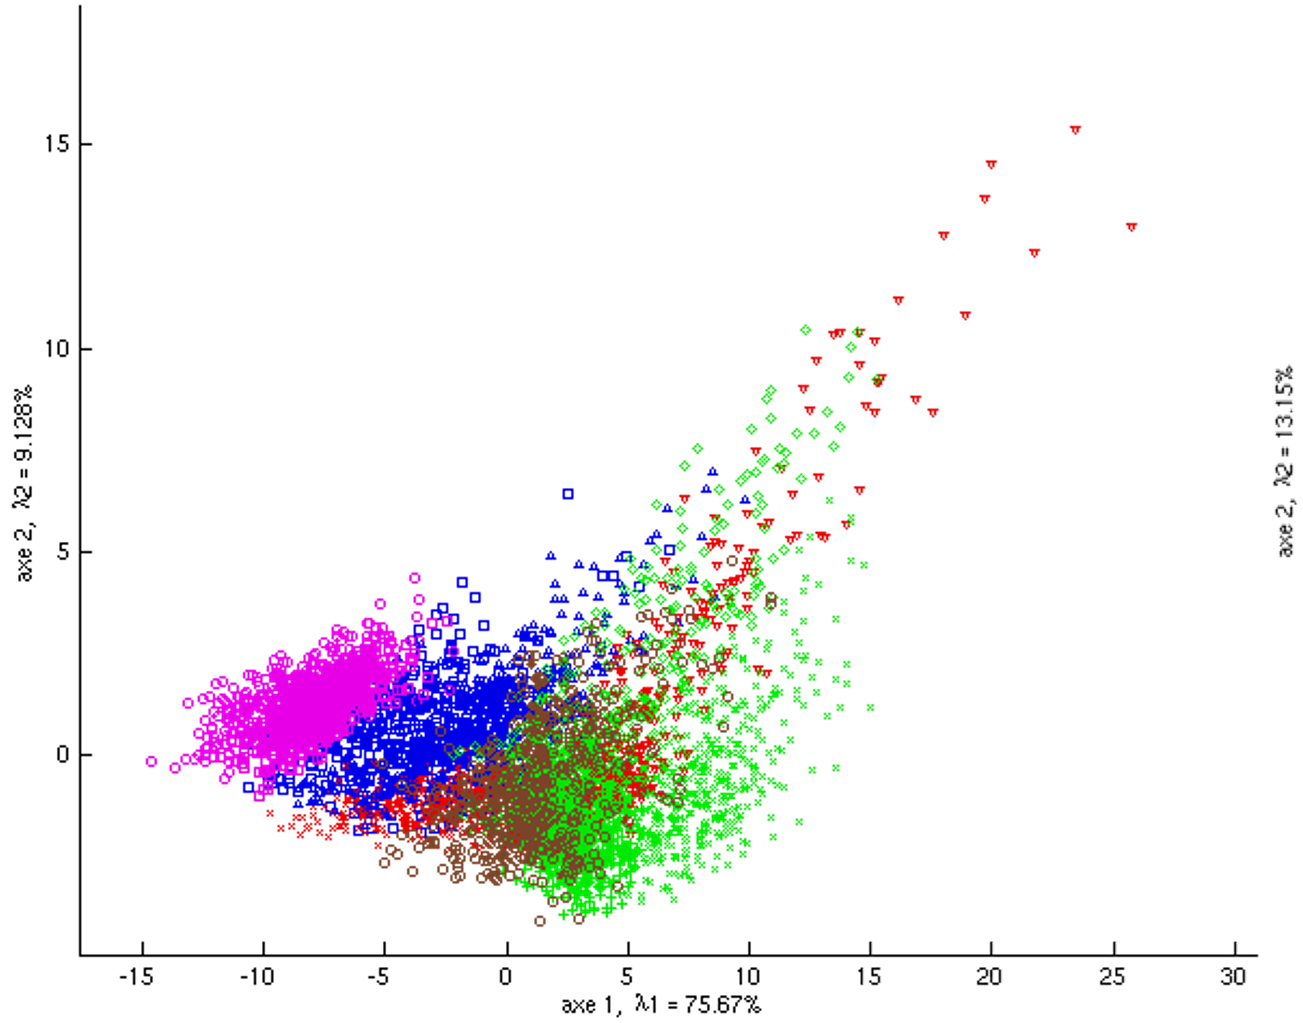
Fig. 7 Exemple ACP : projection des observations sur le premier plan factoriel (données textures [1])
La figure suivante montre la projection des variables sur le premier plan factoriel pour un jeu de données sur les mammifères (\(N = 62\) espèces, \(m = 10\) variables : poids, durée de vie, sommeil, indices de prédation, etc.). L’ACP étant normée, les variables proches du cercle unité sont bien représentées par ce plan. On y distingue trois groupes : le groupe « sommeil », le groupe « danger » et le groupe « corps, cerveau, vie, gestation » (CCVG), avec une forte anti-corrélation entre « sommeil » et « danger ».
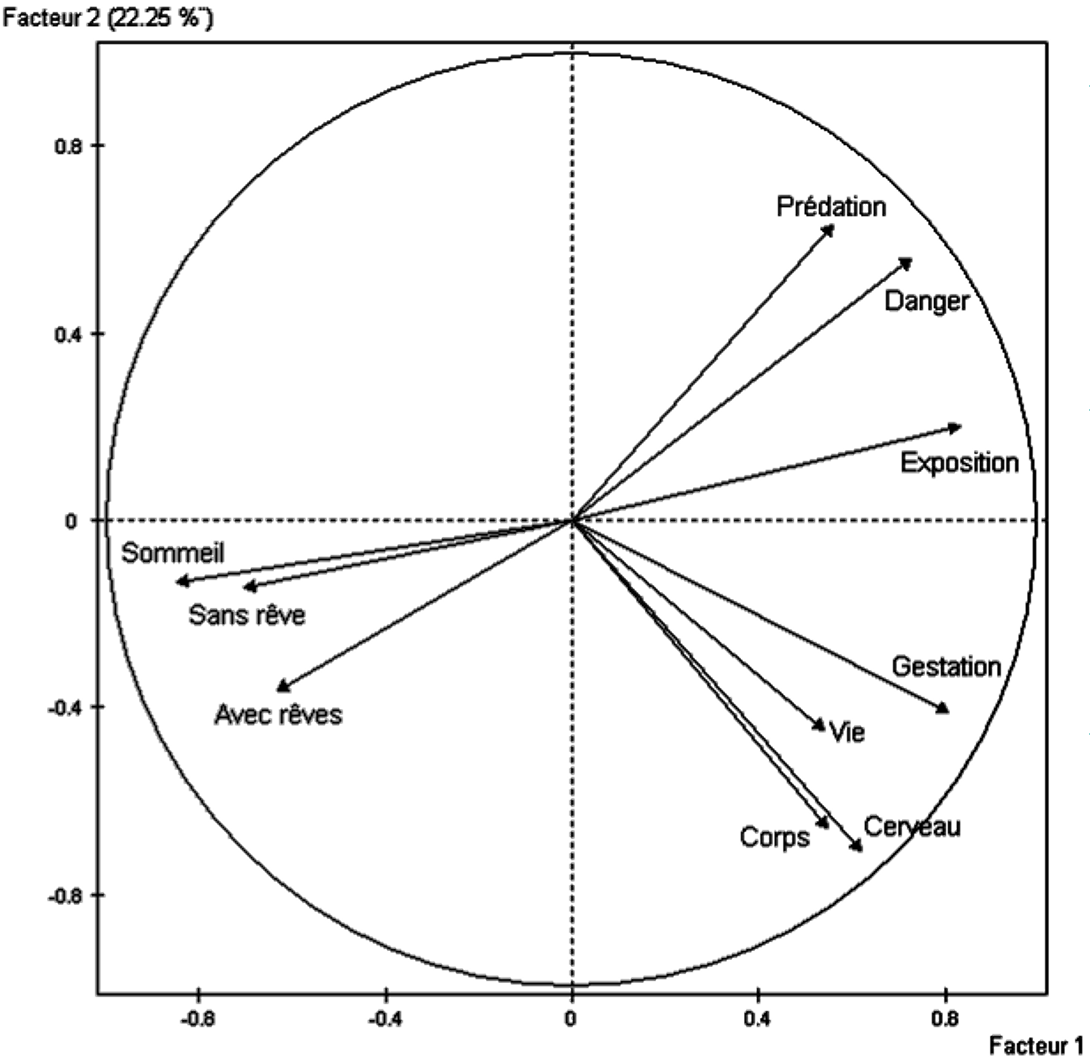
Fig. 8 Exemple ACP : projection des variables sur le premier plan factoriel (données mammifères [2])
Choix du nombre de composantes \(k\). Plusieurs critères sont utilisables selon l’objectif :
Analyse descriptive : méthode du « coude » — on trace les valeurs propres triées par ordre décroissant et on retient celles qui précèdent le premier coude marqué (voir la figure suivante).
Réduction du volume : on impose un taux d’inertie expliquée minimum (par ex. 85 %).
Prétraitement décisionnel : on cherche un bon conditionnement de la matrice des covariances, ou on traite \(k\) comme un hyperparamètre à optimiser.
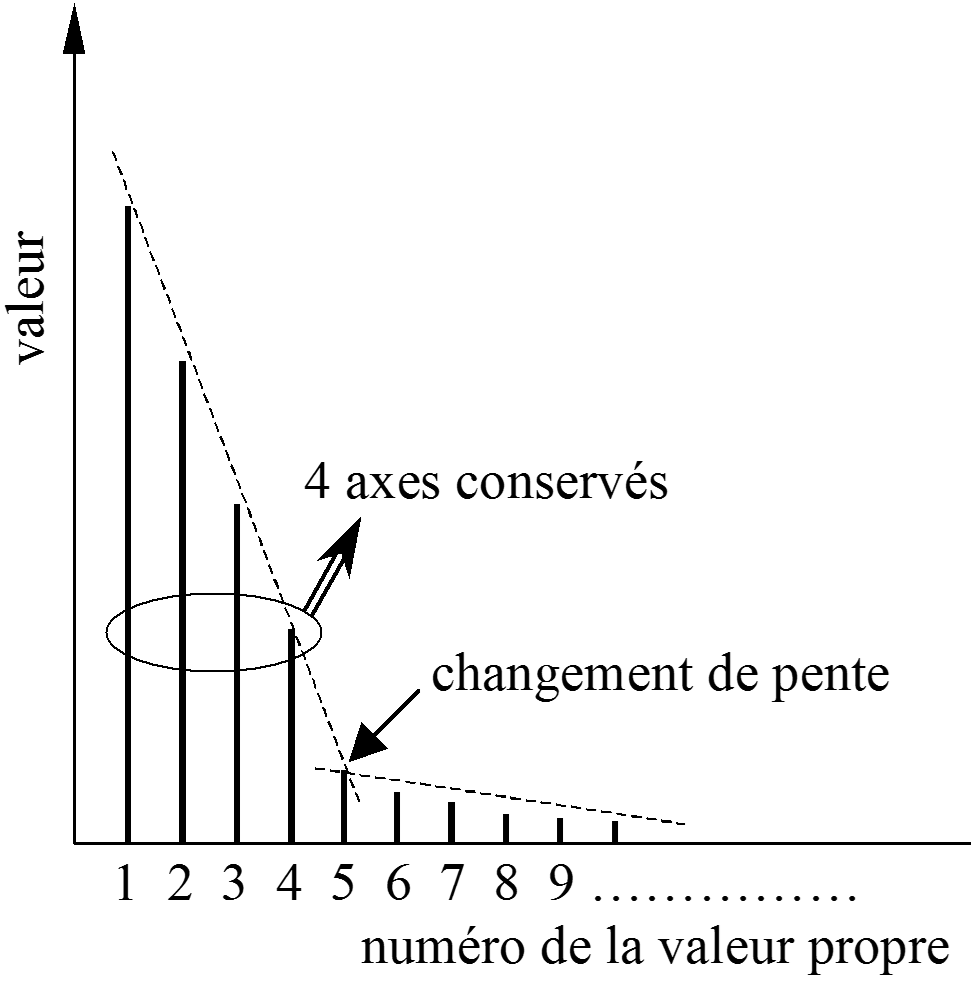
Fig. 9 Choix du nombre d’axes par la méthode du coude : on retient les valeurs propres avant le premier coude marqué
Analyse factorielle discriminante (AFD)
L’AFD est une méthode à la fois exploratoire et décisionnelle qui considère, en plus des \(m\) variables quantitatives, une variable nominale de classe \(Y \in \{1,\ldots,q\}\). Elle cherche \(k < q\) facteurs discriminants, combinaisons linéaires des variables initiales, qui maximisent la séparation entre classes. Nous nous intéressons ici exclusivement à sa composante descriptive.
La figure suivante compare l’ACP et l’AFD sur un exemple simple à deux classes de forme allongée : l’ACP cherche la direction de variance maximale des projections, l’AFD cherche la direction qui sépare le mieux les projections des classes.
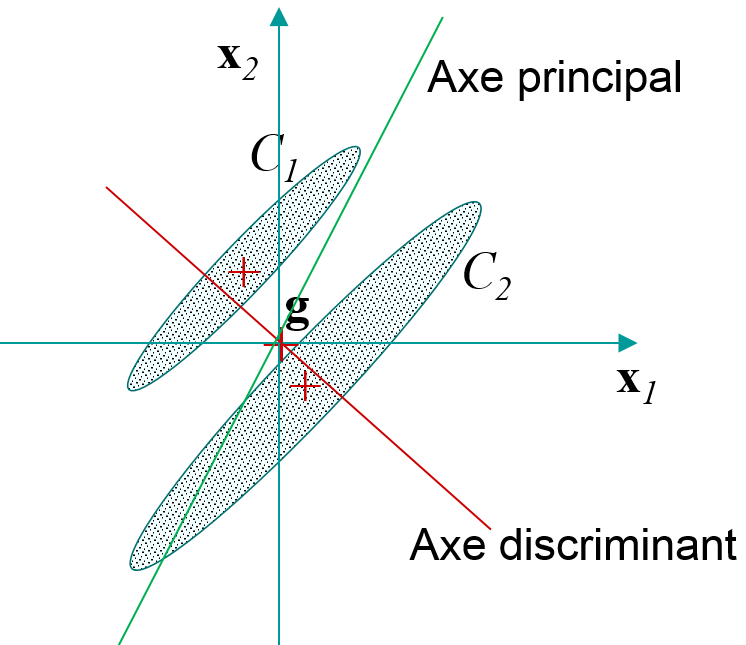
Fig. 10 AFD versus ACP : sur cet exemple à deux classes, le premier axe principal et l’axe discriminant sont très différents
La projection des mêmes données textures (\(N = 5500\), \(m = 40\), \(q = 11\)) sur les deux premiers facteurs discriminants donne une séparation entre classes nettement supérieure à celle obtenue par l’ACP :
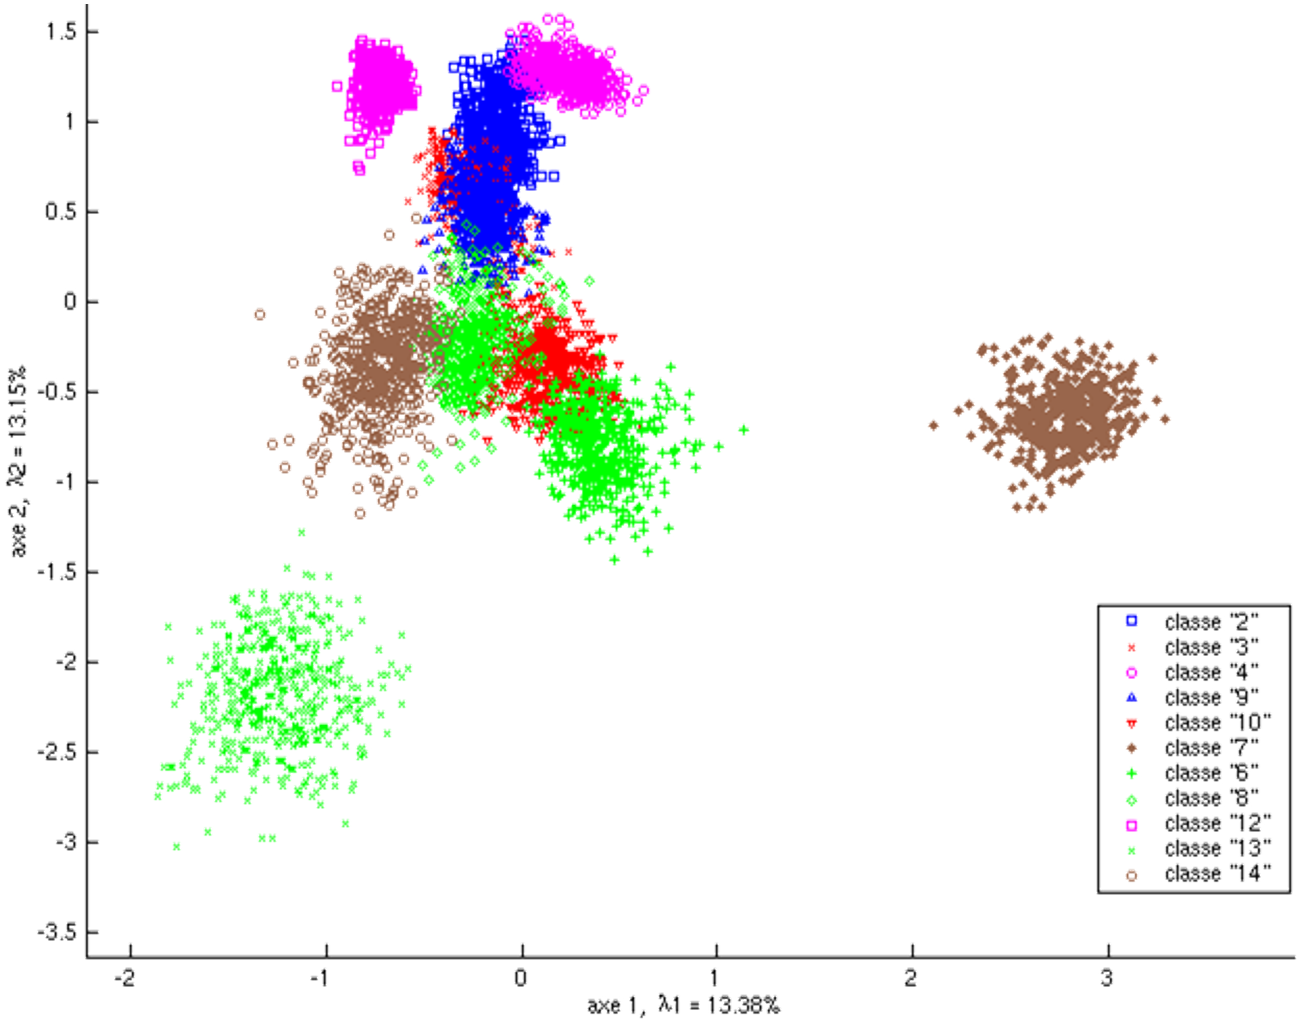
Fig. 11 Exemple AFD : projection des observations sur le premier plan discriminant (données textures [1])
Calcul. L’AFD s’appuie sur trois matrices de covariance :
\(\mathbf{E}\) : covariance inter-classes (calculée sur les centres de gravité des \(q\) classes) ;
\(\mathbf{D}\) : covariance intra-classes (calculée sur les observations, chaque classe centrée sur son centre de gravité) ;
\(\mathbf{S}\) : covariance totale, avec la relation de Huygens \(\mathbf{S} = \mathbf{E} + \mathbf{D}\).
Les facteurs discriminants sont les vecteurs propres \(\mathbf{u}_\alpha\) associés aux plus grandes valeurs propres de l’équation généralisée \(\mathbf{E}\,\mathbf{u}_\alpha = \lambda_\alpha\,\mathbf{S}\,\mathbf{u}_\alpha\).
Limites. Deux points importants :
Le nombre de facteurs est borné : \(k < q\) (pour \(q\) classes, \(\mathbf{E}\) est de rang au plus \(q-1\)). Avec seulement 2 classes, il n’existe qu”un seul facteur discriminant.
Utiliser l’ACP comme prétraitement de l’AFD est tentant pour améliorer le conditionnement de \(\mathbf{S}\), mais risqué : les directions de faible variance pour l’ACP peuvent être des directions très discriminantes pour l’AFD. Une régularisation \(\mathbf{S} \leftarrow \mathbf{S} + r\mathbf{I}_m\) est préférable.
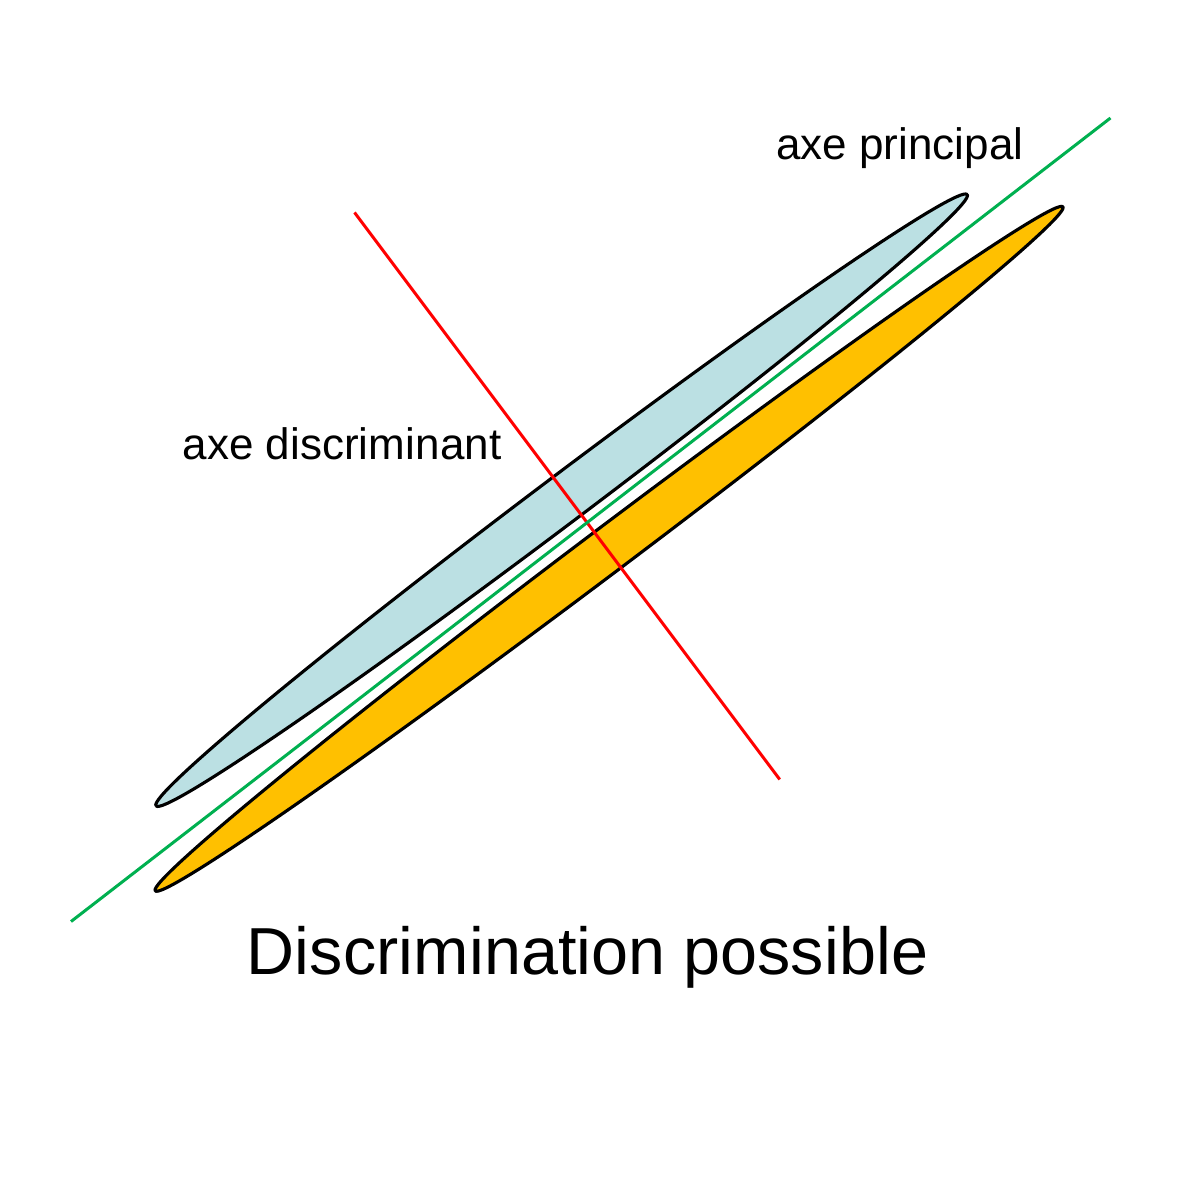
Fig. 12 Exemple : la direction de variance maximale (ACP) est ici perpendiculaire à la direction discriminante (AFD), projeter d’abord sur l’axe principal rendrait la discrimination impossible
Analyse des correspondances multiples (ACM)
L’ACM est une méthode exploratoire adaptée à des données décrites par des variables nominales (à modalités). Elle considère \(N\) observations caractérisées par \(q > 2\) variables nominales, représentées dans un tableau disjonctif complet (TDC) : chaque modalité de chaque variable devient une colonne binaire, indiquant si l’observation possède ou non cette modalité.
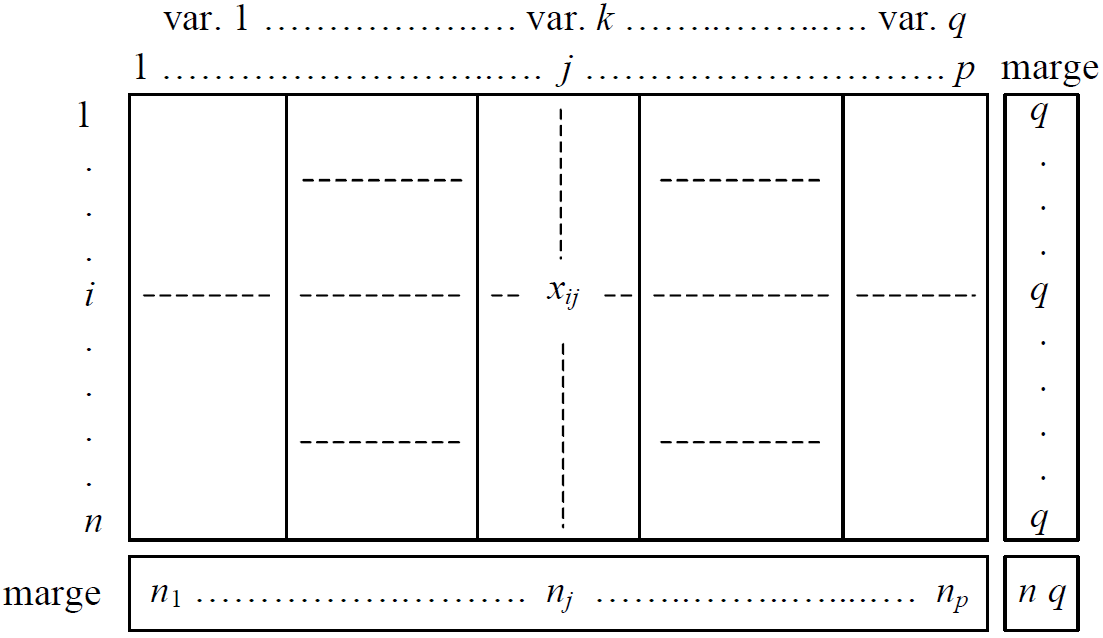
Fig. 13 Tableau disjonctif complet (TDC) : chaque colonne correspond à une modalité d’une variable nominale
L’ACM construit \(k\) nouvelles variables quantitatives qui conservent un maximum de variance du TDC, en utilisant la distance du \(\chi^2\) qui pondère l’influence de chaque modalité par l’inverse de sa fréquence relative. Cette distance présente une propriété d’équivalence distributionnelle : fusionner deux modalités proportionnelles ne change pas les résultats.
L’ACM est utilisée pour :
résumer un grand nombre \(q\) de variables qualitatives par un faible nombre \(k \ll q\) de variables quantitatives ;
mettre en évidence les relations dominantes entre modalités de variables nominales ;
intégrer des variables quantitatives après discrétisation en intervalles, permettant ainsi de détecter des relations non linéaires.
La figure suivante illustre l’ACM sur l’enquête « Les étudiants et la ville » [3], qui porte sur cinq variables nominales (mode d’habitation, type de logement, ancienneté, distance à l’université, surface habitable). Les projections des modalités sur les deux premiers facteurs permettent de lire des similarités (modalités que possèdent une même population ou des populations similaires suivant les autres variables) et des oppositions.
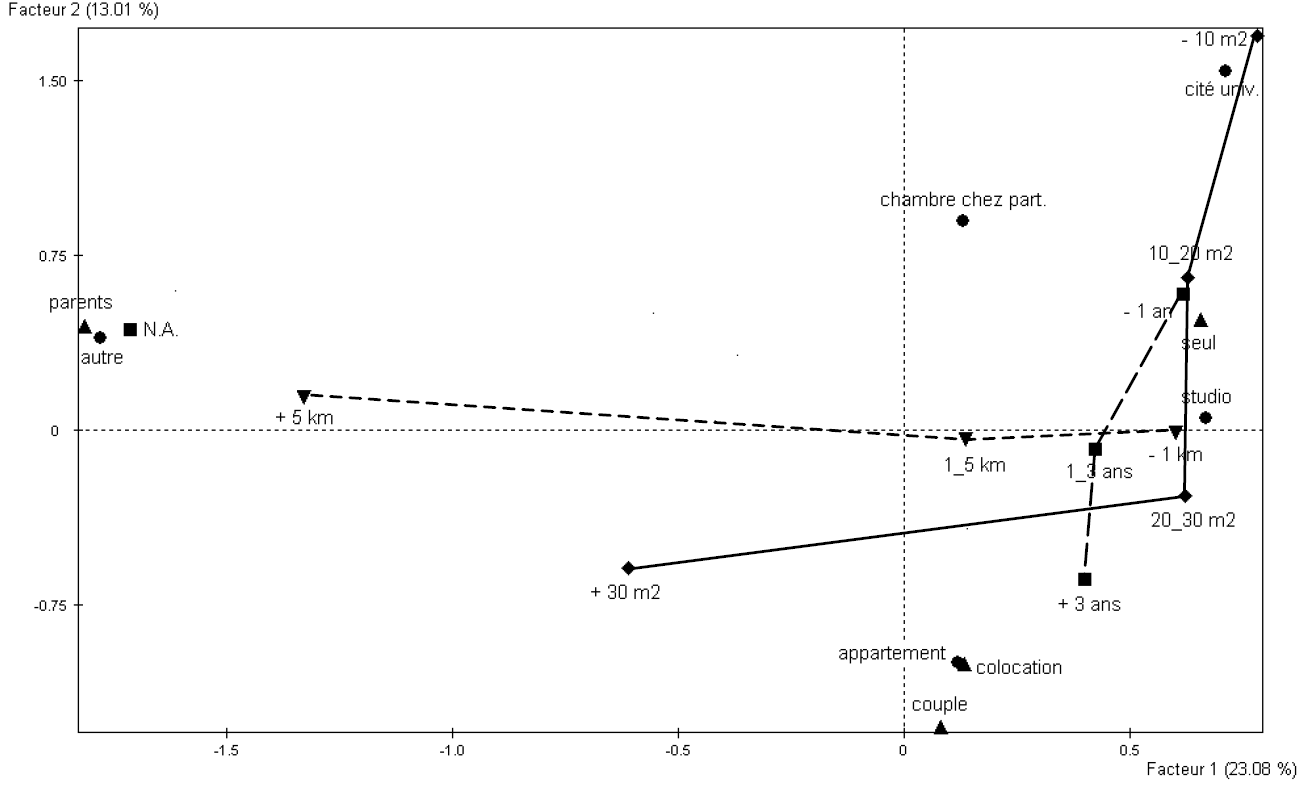
Fig. 14 ACM : résultats sur l’exemple « Les étudiants et la ville » [3]. Deux modalités proches concernent une même population ou des populations similaires suivant les autres variables ; deux modalités opposées concernent des populations aux profils très différents.
Calcul efficace sans distribution
Il est possible d’accélérer significativement les traitements sur un seul ordinateur en choisissant des outils mieux adaptés aux grandes données que la bibliothèque Pandas standard. Nous présentons ici les deux principales alternatives Python : Polars et Dask.
Limites de Pandas à grande échelle
Pandas est la bibliothèque DataFrame de référence en Python et reste le meilleur choix pour des données de taille modeste (quelques dizaines voire une centaine de mégaoctets). Ses limites deviennent problématiques au-delà :
Exécution mono-thread : la quasi-totalité des opérations Pandas n’exploite qu’un seul cœur, laissant inactifs les autres cœurs d’une machine actuelle.
Tout en mémoire : Pandas requiert que l’intégralité du DataFrame tienne dans la RAM. Avec 16 Go de RAM, un DataFrame de données numériques est limité à quelques millions de lignes selon le nombre de colonnes.
Copies mémoire coûteuses : de nombreuses opérations Pandas créent des copies intermédiaires du DataFrame, multipliant la consommation mémoire.
Format de stockage en lignes : Pandas stocke ses données en mémoire par lignes (row-major), ce qui est peu efficace pour les opérations columnaires (agrégations, filtres sur une colonne) très fréquentes en analyse de données.
À partir de quelques gigaoctets, les temps d’exécution de Pandas deviennent pénalisants et la gestion mémoire difficile. C’est le domaine où Polars et Dask présentent un grand intérêt.
Polars
Polars est une bibliothèque DataFrame écrite en Rust, publiée à partir de 2020 et dont l’adoption a connu une croissance très rapide dans la communauté Python. Elle repose sur trois principes architecturaux qui la distinguent de Pandas (voir la documentation officielle, ainsi que Polars vs Pandas: A Comprehensive Comparison).
Architecture
Format de stockage en colonnes Apache Arrow. Polars stocke ses données colonne par colonne en mémoire, dans le format Apache Arrow. Ce format est nativement adapté aux opérations d’agrégation et de filtrage sur des colonnes entières, qui constituent la majorité des opérations analytiques. Il permet également un échange efficace avec d’autres outils qui utilisent Arrow (Spark, DuckDB, etc.), sans conversion.
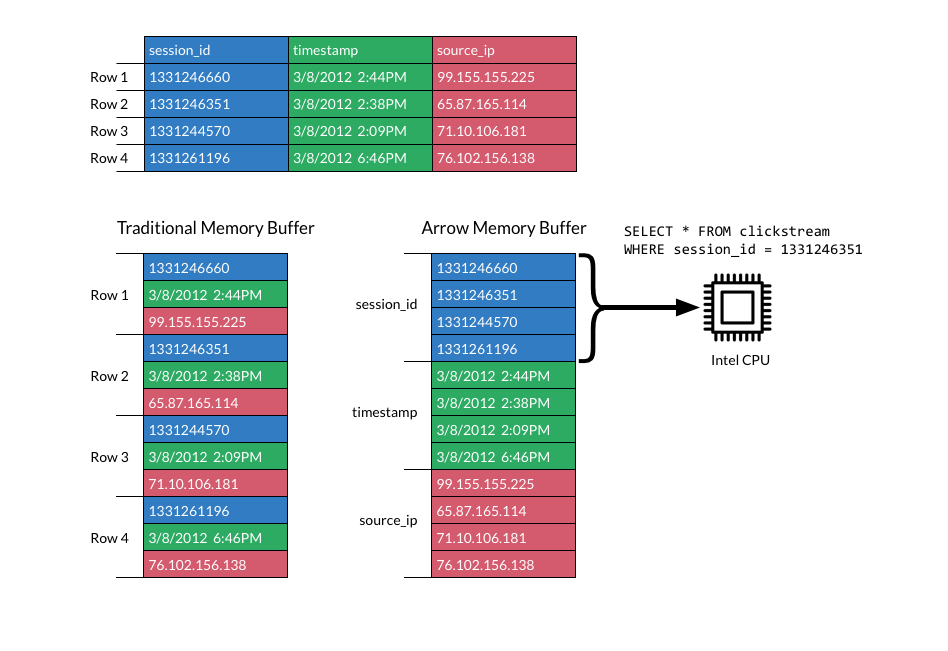
Fig. 15 Format Apache Arrow (source de l’image) : plus facile de lire seulement les colonnes nécessaires, d’appliquer des opérations vectorielles, etc.
Parallélisme multi-cœur automatique. Polars parallélise automatiquement les opérations sur tous les cœurs disponibles de la machine, sans aucune configuration de la part de l’utilisateur.
Exécution paresseuse (lazy evaluation). Polars distingue deux modes d’exécution :
Eager (immédiat) : l’opération est exécutée dès qu’elle est écrite, comme dans Pandas. A préférer seulement quand les résultats intermédiaires sont utiles et pour une étude exploratoire (le traitement complet à appliquer est en cours de définition), dans tous les autres cas privilégier lazy.
Lazy (paresseux) : les opérations sont empilées dans un graphe de requête et ne sont exécutées qu’à l’appel explicite de
collect(). L’optimiseur de requêtes de Polars peut alors réordonner, fusionner et éliminer des opérations pour minimiser le travail réel, en particulier appliquer les filtres le plus tôt possible (predicate pushdown) et ne lire que les colonnes nécessaires (projection pushdown).
API principale
Le point d’entrée est pl.DataFrame (mode eager) ou pl.LazyFrame (mode lazy).
La lecture d’un fichier CSV peut se faire dans les deux modes :
import polars as pl

# Mode eager : lecture immédiate en mémoire
df = pl.read_csv("data.csv")

# Mode lazy : lecture différée, optimisée
lf = pl.scan_csv("data.csv")
Les opérations de filtrage, sélection, agrégation et jointure s’expriment facilement :
# Sélection de colonnes et filtrage
result = (
    lf
    .filter(pl.col("age") > 30)
    .select(["nom", "age", "revenu"])
    .collect()
)

# Agrégation par groupe
result = (
    lf
    .group_by("categorie")
    .agg([
        pl.col("revenu").mean().alias("revenu_moyen"),
        pl.col("age").max().alias("age_max"),
        pl.len().alias("n"),
    ])
    .sort("revenu_moyen", descending=True)
    .collect()
)

# Jointure
result = lf.join(lf2, on="id_client", how="left").collect()

# Ajout d'une colonne calculée
result = (
    lf
    .with_columns(
        (pl.col("revenu") / pl.col("age")).alias("revenu_par_an_age")
    )
    .collect()
)
Comparaison syntaxique entre Pandas et Polars. La transition depuis Pandas est généralement rapide, le tableau suivant donne quelques équivalences clés :
Pandas |
Polars (lazy) |
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
Performances
Sur de nombreuses tâches analytiques courantes incluant des étapes de filtrage, agrégation, jointure, tri, Polars est 5 à 20 fois plus rapide que Pandas selon les opérations et la taille des données (voir par exemple Polars vs Pandas, DuckDB benchmarks).
Cas d’usage typiques de Polars
Polars est particulièrement adapté quand :
les données tiennent dans la mémoire RAM (de quelques Go à quelques dizaines de Go) d’une machine ;
les traitements analytiques s’appuyent fortement sur des opérations en colonnes (filtrage, agrégation, jointure) ;
la rapidité d’exécution sur une seule machine est prioritaire ;
on cherche une solution qui n’impose pas d’apprendre un nouveau paradigme de programmation distribué.
Polars ne propose pas nativement de distribution sur plusieurs machines ; pour ce besoin il faut se tourner vers Dask ou Spark.
Dask
Dask est une bibliothèque Python native développée à partir de 2014. Son objectif principal est de paralléliser et potentiellement distribuer des calculs qui utilisent les API Python familières (NumPy, Pandas) avec un minimum de changements dans le code.
Architecture
Dask travaille sur différents types de collections partitionnées. Les partitions peuvent être traitées en parallèle sur les cœurs disponibles d’une même machine, ou chargées en mémoire depuis le stockage de masse et traitées successivement si la collection est trop volumineuse pour la mémoire d’une seule machine, ou encore traitées sur les différentes machines d’un cluster (traitement distribué). Les traitements à effectuer sont représentés sous la forme d’un graphe acyclique dirigé et ensuite exécutés (sur une ou plusieurs machines) en mode paresseux (lazy) sous le contrôle d’un scheduler centralisé.
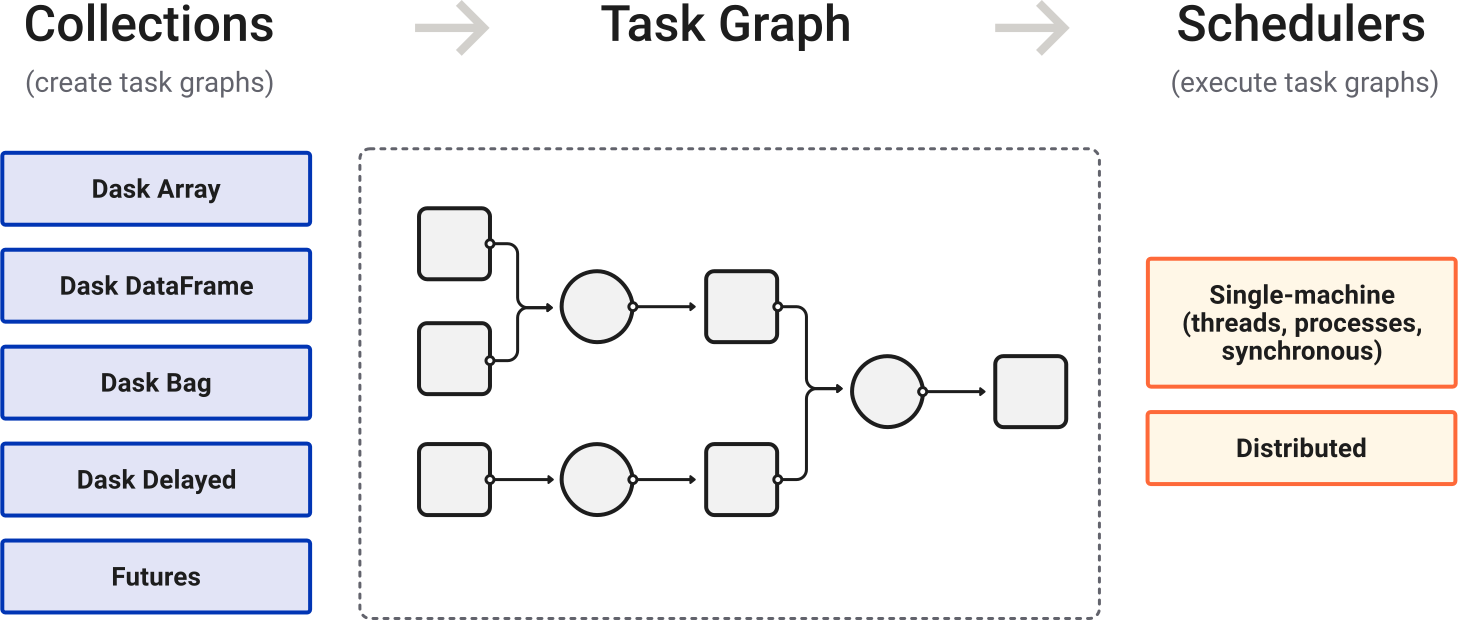
Fig. 16 Fonctionnement global de Dask : la collection et le programme sont employés pour définir un graphe de tâches qui est ensuite exécuté à l’aide d’un scheduler (source : documentation Dask)
Collections partitionnées. Une collection est composée de partitions qui correspondent à
des collections Pandas ou NumPy, raison pour laquelle l’API Dask peut rester très proche des
API NumPy (pour dask.Array) ou Pandas (pour dask.DataFrame) correspondantes. La figure
suivante illustre une dask.DataFrame qui est une collection de partitions, chaque
partition étant une pandas.DataFrame ordinaire. Les opérations Dask s’appliquent à toutes
les partitions, partition après partition ou en parallèle, suivant le mode d’exécution (qui
dépend des ressources disponibles). Le partitionnement peut se faire par plage d’index
(range partitioning) ou par hachage (hash partitioning), ce dernier étant nécessaire
pour des opérations join et groupby efficaces.
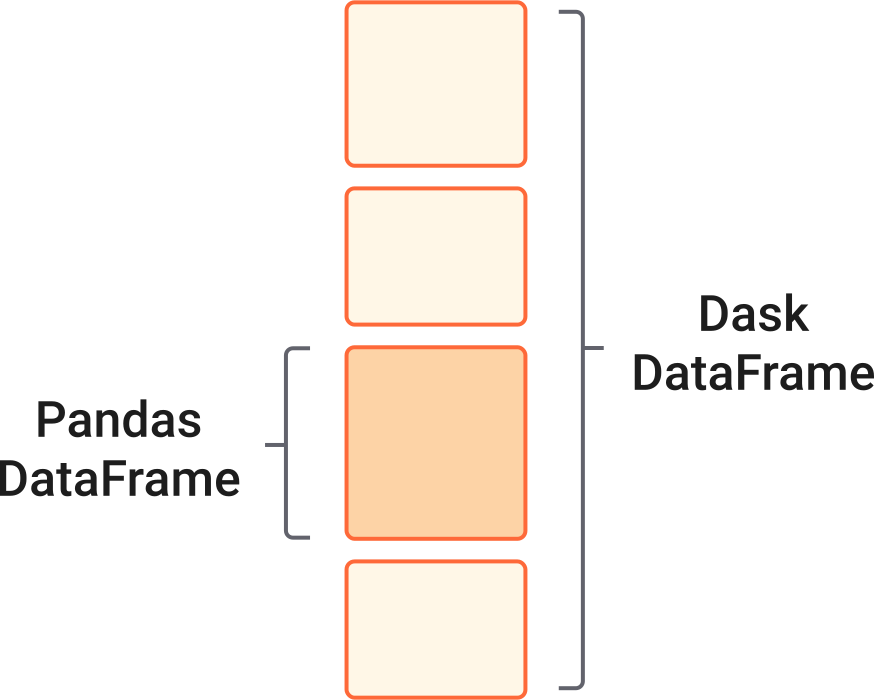
Fig. 17 Structure d’une DataFrame Dask
Graphe des tâches. Toute opération Dask construit un graphe acyclique dirigé (DAG) de tâches Python, chaque nœud du graphe correspondant à une opération élémentaire sur un fragment de données. Ce graphe est d’abord optimisé, puis soumis au scheduler pour exécution.
Scheduler. Dask inclut plusieurs schedulers :
Synchrone : exécution séquentielle, sans parallélisme, principalement pour le débogage.
Threads : parallélisme intra-machine par threads, qui introduit un minimum de overhead ; adapté aux opérations qui libèrent le Global Interpreter Lock, ou GIL, comme NumPy.
Processus : parallélisme intra-machine par processus, avec un overhead plus élevé ; adapté aux opérations Python pures, où chaque processus retient son GIL et ne permet pas à plusieurs threads de s’exécuter en parallèle, le parallélisme ne peut donc avoir lieu qu’entre processus.
Distribué : déploiement sur un cluster de machines, avec un scheduler centralisé et un tableau de bord de monitoring ; si une machine tombe en panne, le scheduler redéploie les calculs sur une autre machine.
API Dask
Pour faciliter la parallélisation de code existant, l’API de Dask est proche de l’API classique NumPy ou Pandas correspondante. Ainsi, l’API dask.dataframe est intentionnellement très proche de celle de Pandas :
import dask.dataframe as dd

# Lecture : crée un DataFrame Dask partitionné (lecture lazy)
ddf = dd.read_csv("data_large_*.csv")   # supporte les glob patterns

# Les opérations s'écrivent comme en Pandas...
result = ddf[ddf["age"] > 30]["revenu"].mean()

# ... mais ne sont pas exécutées tant que compute() n'est pas appelé
print(result.compute())   # déclenche l'exécution

# Agrégation par groupe
result = (
    ddf
    .groupby("categorie")["revenu"]
    .agg(["mean", "max", "count"])
    .compute()
)

# Jointure (nécessite que les deux DataFrames aient le même schéma de partitionnement
# sur la clé de jointure pour être efficace)
result = ddf.merge(ddf2, on="id_client").compute()
A son tour, dask.array propose une API NumPy distribuée, utile pour le calcul scientifique
sur des tableaux qui ne tiennent pas en mémoire :
import dask.array as da

x = da.random.random((100_000, 100_000), chunks=(1000, 1000))
result = x.mean(axis=0).compute()   # moyenne sur 10^10 éléments
Aussi, dask.bag est adaptée aux collections Python semi-structurées (listes de dictionnaires,
JSON, textes), avec des opérations de type map, filter ou groupby.
Dask en mode distribué
Sur une seule machine, Dask utilise par défaut le scheduler multi-threads ou multi-processu.
Pour un déploiement sur cluster, dask.distributed fournit un scheduler centralisé
(Client) et des workers distribués :
from dask.distributed import Client

# Connexion à un cluster existant (ou création d'un cluster local)
client = Client("scheduler-address:8786")
# ou, sur une seule machine :
client = Client()   # crée automatiquement des workers locaux

# Le reste du code Dask est identique
ddf = dd.read_csv("hdfs://data/*.csv")
result = ddf.groupby("cat")["val"].mean().compute()
Un tableau de bord (dashboard) est accessible via le navigateur pour suivre l’avancement des tâches, la consommation mémoire et les transferts réseau entre workers.
Quand préférer Dask à Polars ?
Polars et Dask répondent à des besoins complémentaires. Dask est préférable quand :
les données dépassent la RAM d’une seule machine mais on ne dispose pas d’un cluster”: Dask traite les partitions les unes après les autres en les conservant sur disque entre les étapes ;
on souhaite un déploiement sur cluster avec la même API que sur une seule machine : les traitements utilisent des opérations NumPy ou Pandas existantes que l’on veut simplement paralléliser sans réécrire le code.
Polars est préférable quand les données tiennent en RAM et que la priorité est la vitesse d’exécution sur une seule machine.
Synthèse : Pandas, Polars, Dask
Le tableau suivant complète la vue d’ensemble de la séance introductive pour les outils sans distribution.
Pandas |
Polars |
Dask |
|
|---|---|---|---|
Langage interne |
C / Python |
Rust |
Python |
Format mémoire |
Lignes (NumPy) |
Colonnes (Arrow) |
Partitions Pandas |
Multi-cœur |
Non |
Oui (automatique) |
Oui (configurable) |
Données > RAM |
Non |
Partiel (scan pour lecture lazy) |
Oui |
Distribution cluster |
Non |
Non |
Oui ( |
Exécution paresseuse |
Non |
Oui (LazyFrame) |
Oui ( |
Compatibilité Pandas |
— |
Partielle |
Très forte |
Vitesse (données en RAM) |
★★ |
★★★★★ |
★★★ |
Facilité de prise en main |
★★★★★ |
★★★★ |
★★★★ |
Cas d’usage principal |
Volumes modérés, exploration |
Analyses rapides, quelques Go en RAM |
Données > RAM, parallélisation de code Pandas existant |
Il est important de comprendre que toutes ces bibliothèques évoluent constamment, en intégrant de nouvelles fonctionnalités, en optimisant certains algorithmes, etc. Ces évolutions peuvent avoir un impact significatif sur les écarts relatifs de performance.
Crucianu, M., J.-P. Asselin de Beauville, et R. Boné. Méthodes d’analyse factorielle des données : méthodes linéaires et non linéaires. Hermès, Paris, 2004.
Saporta, G. Probabilités, Analyse des Données et Statistique. Technip, Paris, 2011.
Tang, J., S. Alelyani, et H. Liu. Feature selection for classification: A review. Dans Data Classification: Algorithms and Applications, pages 37–64. 2014.
Tillé, Y. Théorie des sondages. Dunod, Paris, 2001.