Cours - Approches distribuées
Supports complémentaires :
[Diapositives du cours : 2 par page] [Diapositives du cours : 1 par page]
Pour une présentation très illustrée de MapReduce, voir également la séance MapReduce démystifié de l’UE NFE204 du Cnam. Pour une introduction approfondie à Spark, voir la séance Etude de cas : Apache Spark de la même UE.
La séance précédente a montré comment repousser les limites d’une architecture centralisée par la réduction du volume de données ou grâce à des bibliothèques optimisées (Polars, Dask). Les approches centralisées ont néanmoins une limite absolue : elles sont contraintes par la capacité d’une seule machine, c’est à dire sa mémoire, ses cœurs CPU, son stockage local. Lorsque le volume de données dépasse cette capacité, ou lorsque les calculs doivent s’exécuter en quelques secondes sur des données qui en nécessiteraient des heures sur une seule machine, il faut distribuer à la fois les données et les calculs sur un ensemble d’ordinateurs interconnectés.
Cette séance présente les fondements du calcul distribué pour la fouille de données : le modèle MapReduce qui a posé les bases, Apache Spark qui en constitue aujourd’hui l’évolution dominante, et Ray qui représente une approche plus générale orientée vers l’apprentissage automatique distribué. Rappelons toutefois que Dask n’est pas limitée aux calculs centralisés mais permet également une exécution distribuée.
Principes du calcul distribué
Architecture d’un cluster
La solution privilégiée depuis les années 2010 pour traiter des données massives est de distribuer données et calculs sur un grand nombre d’ordinateurs standards bon marché, chacun équipé de son propre processeur, de sa mémoire vive et de son stockage local, interconnectés par un réseau haut débit pour former un cluster.
Ce choix architectural est guidé par le rapport coût/performance : un cluster de 1 000 serveurs à 1 000 € chacun offre une puissance de traitement et une capacité de stockage bien supérieures à celles d’un serveur unique à 1 000 000 €, pour un coût comparable. Il présente en outre une élasticité naturelle : nous pouvons facilement ajouter ou retirer des nœuds selon les besoins.
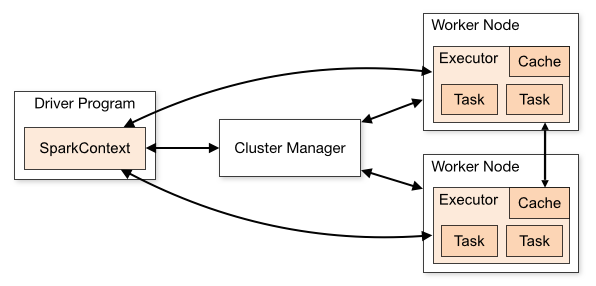
Fig. 18 Architecture d’un cluster : un programme driver distribue les tâches aux nœuds de calcul (worker nodes) gérés par un gestionnaire de cluster (cluster manager). Illustration issue de la documentation de Spark.
La localité des données est un principe central : les données à traiter étant bien plus volumineuses que les programmes à exécuter, on préfère envoyer le code vers les données plutôt que l’inverse. Chaque nœud de calcul travaille donc sur les données stockées localement, minimisant les transferts réseau coûteux.
Tolérance aux pannes
L’emploi d’un grand nombre d’ordinateurs standards augmente inévitablement la probabilité de panne d’au moins un nœud. Sur un cluster de 1 000 machines dont chacune tombe en panne en moyenne une fois tous les trois ans, on s’attend statistiquement à environ une panne par jour. Un système distribué efficace doit donc tolérer les pannes sans perdre de données ni interrompre les calculs en cours.
Deux mécanismes fondamentaux assurent cette tolérance :
La réplication : chaque fragment de données est stocké sur plusieurs nœuds (en général 3 dans HDFS). Si un nœud tombe en panne, les données qu’il hébergeait restent accessibles sur les autres copies.
Le partitionnement fin des calculs : l’ensemble du travail est découpé en tâches élémentaires traçables. En cas de panne d’un nœud, les tâches qu’il devait exécuter sont simplement réaffectées aux nœuds encore actifs, sans reprendre l’ensemble du calcul depuis le début.
MapReduce
MapReduce est le modèle d’exécution distribué qui a posé les fondations du traitement de données massives à grande échelle. Proposé par Google en 2004 [DG04] et implémenté en open source dans le framework Hadoop, il reste une référence conceptuelle même si Spark l’a largement supplanté dans la pratique.
Principe
MapReduce décompose tout traitement en deux types de tâches élémentaires et uniformes.
Une tâche Map reçoit un fragment de données lu depuis le stockage non volatil (disque) et produit une séquence de paires
[clé, valeur]. Toutes les tâches Map sont indépendantes les unes des autres et peuvent s’exécuter en parallèle sur des fragments de données différents.Une tâche Reduce reçoit, pour une clé donnée, l’ensemble des valeurs associées à cette clé par les différentes tâches Map (après un regroupement appelé shuffle) et les combine pour produire un résultat qui est stocké sur disque.
Le programmeur n’écrit que les fonctions Map et Reduce. Le framework se charge de distribuer les données, d’affecter les tâches aux nœuds, de gérer les pannes et de collecter les résultats.
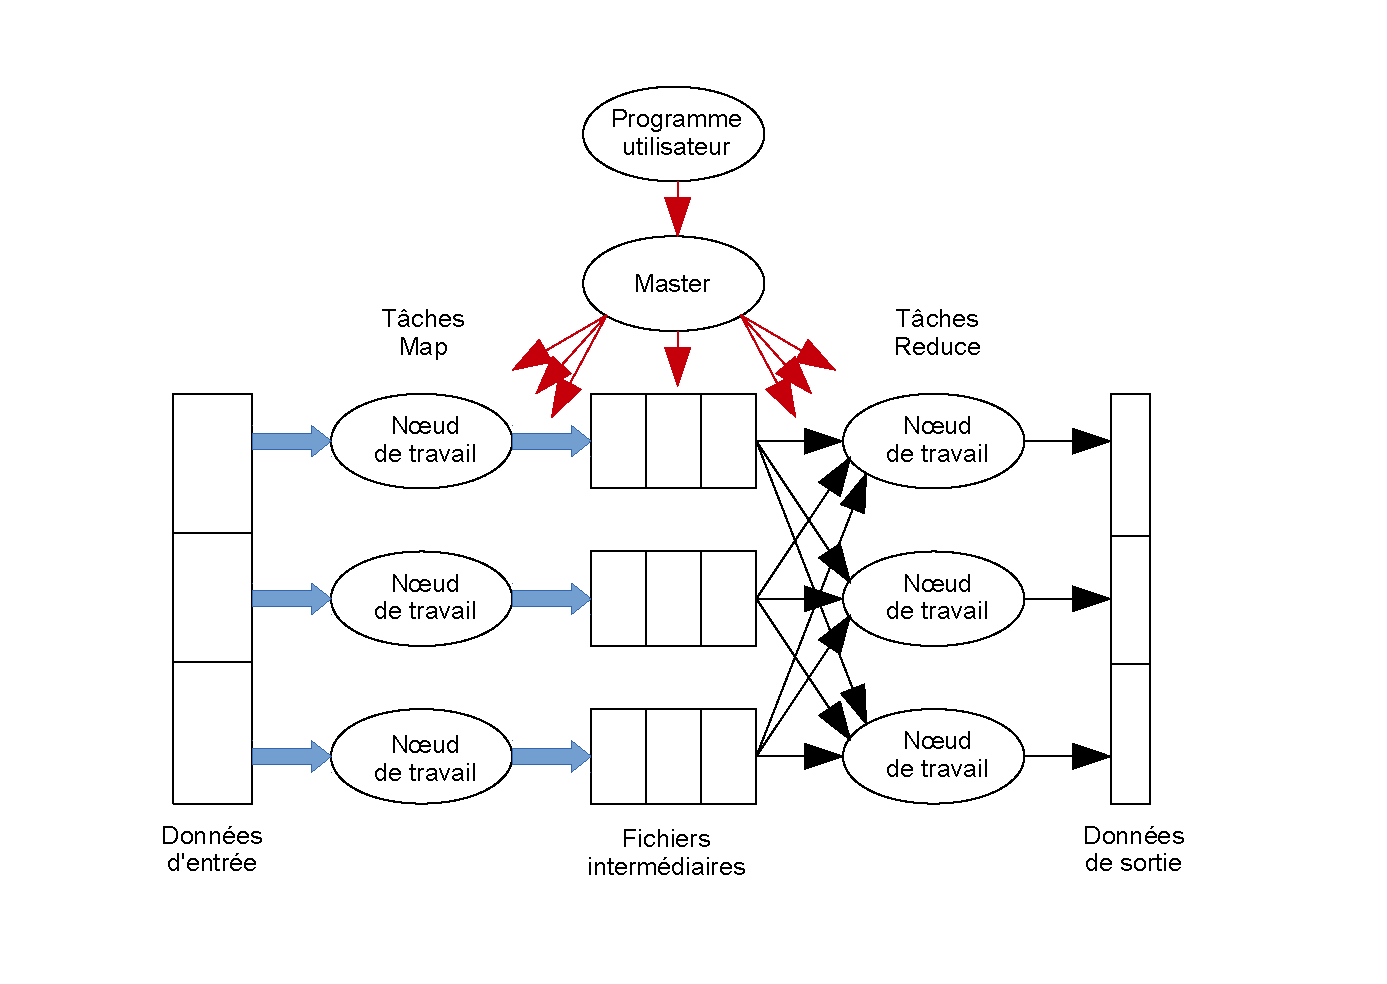
Fig. 19 MapReduce : exécution d’un programme
Exemple 1 : comptage de mots (Word Count)
Le comptage du nombre d’occurrences de chaque mot dans une grande collection de documents est l’exemple canonique de Map Reduce. Supposons que la collection est répartie en fragments, un fragment par nœud de calcul.
Tâche Map : chaque nœud parcourt les mots de son fragment et émet une paire
[mot, 1] pour chaque occurrence.
Étape Shuffle : les paires sont regroupées par clé (mot) et acheminées vers les nœuds Reduce responsables de chaque mot.
Tâche Reduce : pour chaque mot, le nœud additionne toutes les valeurs 1 reçues et
stocke le résultat [mot, nombre_total].
Optimisation. L’addition est associative et commutative : plutôt
que d’émettre une paire [mot, 1] par occurrence, chaque tâche Map peut d’abord
comptabiliser localement les occurrences de chaque mot dans son fragment, puis n’émettre
qu’une seule paire [mot, n_local]. En « remontant » ainsi une partie de chaque tâche Reduce
dans les tâches Map on réduit considérablement le volume de données transférées lors de
l’étape shuffle.


Exemple 2 : multiplication matrice × vecteur
Considérons le produit \(\mathbf{y} = \mathbf{M} \times \mathbf{x}\), avec \(y_i = \sum_{j=1}^n m_{ij}\, x_j\) et une matrice \(\mathbf{M}\) trop grande pour tenir dans la mémoire d’un seul nœud.
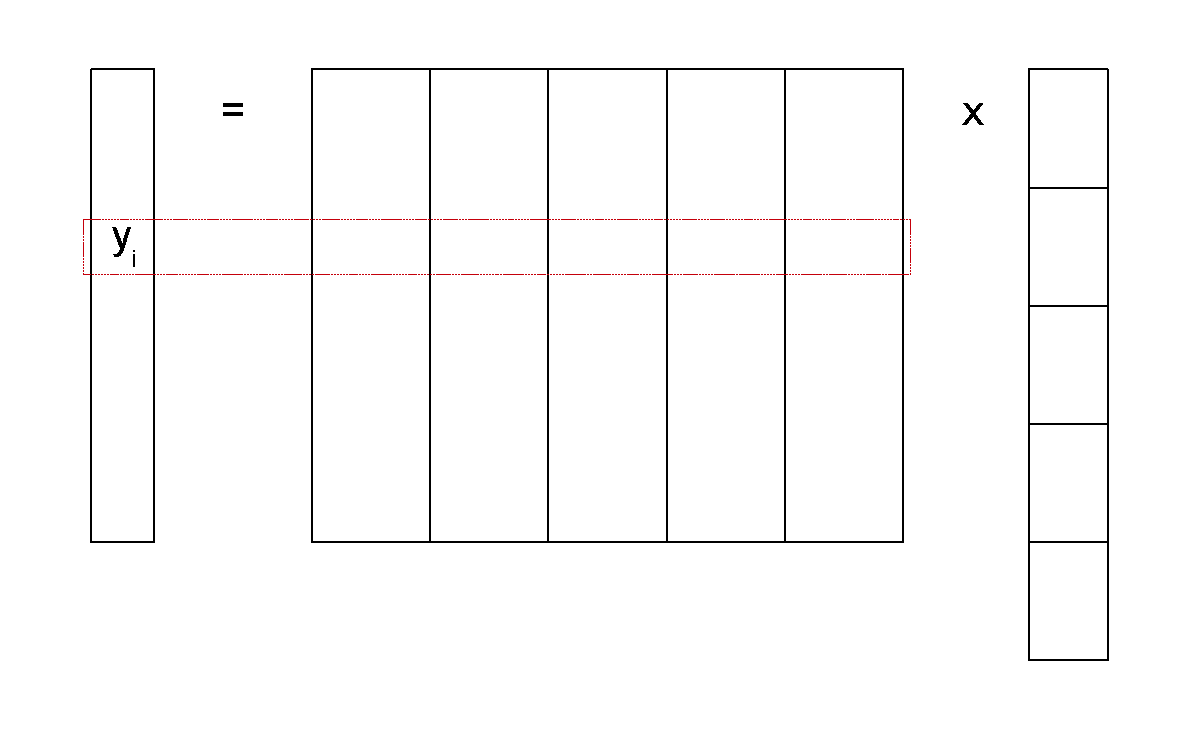
Fig. 20 Multiplication matrice × vecteur en Map Reduce
\(\mathbf{M}\) est découpée en groupes de colonnes, chaque groupe tenant en mémoire sur un nœud. Le vecteur \(\mathbf{x}\) est découpé en groupes de lignes de façon correspondante.
Map : chaque nœud reçoit un fragment de \(\mathbf{M}\) et le fragment correspondant de \(\mathbf{x}\). Pour chaque élément \(m_{ij}\), il calcule \(m_{ij} x_j\) et émet la paire \((i,\; m_{ij} x_j)\).
Shuffle : les paires sont regroupées par indice \(i\).
Reduce : pour chaque \(i\), le nœud additionne toutes les valeurs \(m_{ij} x_j\) reçues pour obtenir \(y_i\).
Ici aussi, l’addition étant associative et commutative, une optimisation consiste à pré-sommer les contributions partielles de chaque nœud Map avant l’étape shuffle.
Hiérarchie de stockage et coût des accès disque
Le choix de stocker ou non les résultats intermédiaires en mémoire plutôt que sur disque a un impact considérable sur les performances. La figure suivante rappelle les ordres de grandeur des débits aux différents niveaux de la hiérarchie de stockage :
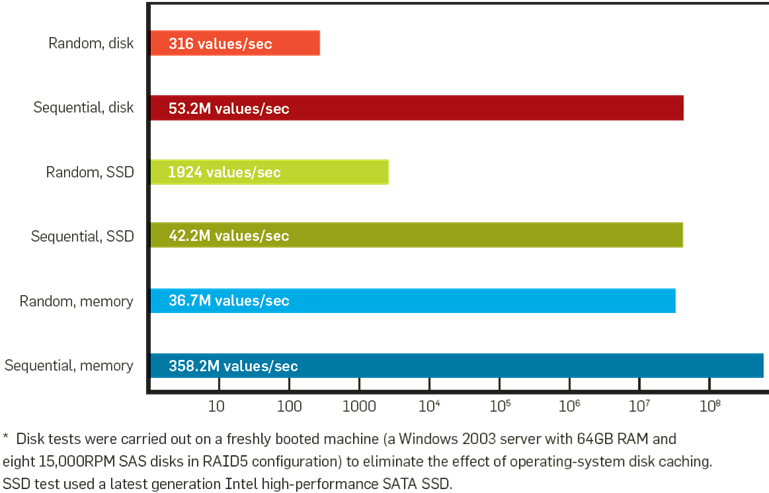
Fig. 21 Hiérarchie de stockage (issue de Communications of the ACM 2009 (8): 36-44)
La mémoire vive est plusieurs ordres de grandeur plus rapide que le disque. Cette observation est au cœur de la différence architecturale entre MapReduce et Spark, comme nous allons le voir.
Éléments de réponse :
Avec 1000 itérations il y a 999 stockages intermédiaires ; entre deux itérations il faut compter une écriture à la fin de l’itération courante et une lecture au début de l’itération suivante, soit deux accès disque par itération intermédiaire. D’où : \(\frac{1064 \times 999 \times 2}{53{,}2} = 39\,960\) secondes, soit environ 11 heures de surcoût purement lié aux accès disque.
Limites de MapReduce pour les algorithmes itératifs
MapReduce présente deux contraintes importantes qui le rendent pénalisant pour les algorithmes de fouille de données, qui sont souvent itératifs (k-moyennes, descente de gradient, ACP par la méthode des puissances, etc.).
Stockage obligatoire des résultats intermédiaires. Le mécanisme de reprise sur panne de Map Reduce exige que les résultats de chaque étape Reduce soient écrits sur disque (HDFS) avant de pouvoir être utilisés comme données d’entrée de l’itération suivante. Pour un algorithme comportant \(k\) itérations, cela engendre \(k\) aller-retours disque. Comme le montre la question chiffrée précédente, ce surcoût peut être de plusieurs ordres de grandeur supérieur au temps de calcul effectif.
Niveau d’abstraction bas. Le programmeur doit reformuler chaque itération en termes de Map et Reduce, puis enchaîner les itérations manuellement. Le code devient vite complexe et difficile à maintenir.
Ces limitations ont motivé le développement de Spark.
Apache Spark
Apache Spark [Zah+12] est né en 2009 au sein de l’UC Berkeley AMPLab, avec pour ambition de conserver les avantages de MapReduce (tolérance aux pannes, parallélisme automatique, scalabilité) tout en éliminant ses limites pour les algorithmes itératifs. Spark est aujourd’hui le framework de traitement de données distribuées le plus utilisé dans l’industrie.
Solution aux limites de MapReduce : données en mémoire et lineage
La réponse de Spark aux limites de MapReduce repose sur deux idées fondamentales.
Données en mémoire. Spark conserve les résultats intermédiaires dans la mémoire vive des nœuds de calcul (autant que possible), évitant les coûteux aller-retours disque entre itérations. L’accélération sur les algorithmes itératifs est de 10 à 100 fois par rapport à Map Reduce classique.
Lineage (historique des opérations). Spark enregistre le graphe des transformations ayant permis de produire chaque donnée intermédiaire. En cas de panne d’un nœud, les données perdues (car stockées en mémoire vive sur ce nœud) et elles seules sont recalculées à la demande à partir des dernières données stables, en rejouant sur un autre nœud les transformations enregistrées. La tolérance aux pannes est ainsi assurée sans stockage non volatil des données intermédiaires.
Structures de données : RDD, Dataset, DataFrame
L’API de Spark a évolué au fil des versions. Trois niveaux d’abstraction coexistent.
RDD (Resilient Distributed Dataset). Introduit dans la version 1.0, le RDD est la structure de données fondamentale de Spark : une collection de données partitionnée et distribuée sur les nœuds du cluster, conservée autant que possible en mémoire. Les RDD sont immuables, toute transformation produit un nouveau RDD. Les opérations sur les RDD se divisent en deux catégories :
Transformations (
map,filter,flatMap,groupByKey,reduceByKey, etc.) : définissent une nouvelle opération mais ne déclenchent aucun calcul car l’évaluation est paresseuse (lazy evaluation).Actions (
collect,count,reduce,saveAsTextFile, etc.) : déclenchent l’exécution effective du graphe de transformations accumulées.
Dataset / DataFrame. Introduites avec Spark 1.6 / 2.0, ces abstractions de plus haut niveau ajoutent :
Un typage fort et une représentation binaire compact (format Tungsten), plus efficace que les JavaObjects des RDD.
Un optimiseur de requêtes (Catalyst) qui analyse le plan d’exécution logique, l’optimise (fusion d’opérations, application des filtres le plus tôt possible, réordonnancement de jointures, etc.) et génère un plan physique efficace (similaire à ce que fait un optimiseur SQL).
Une API SQL : les DataFrames peuvent être interrogées avec des requêtes SQL standard.
Une DataFrame est un Dataset organisé en colonnes nommées, analogue à une table
relationnelle. En PySpark (Python), DataFrame est l’alias de Dataset[Row].
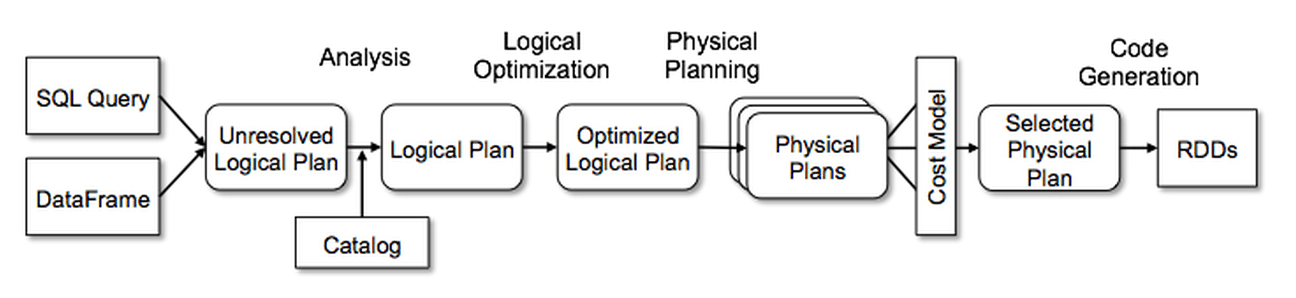
Fig. 22 Pipeline d’optimisation Catalyst : du plan logique au code généré (source : Databricks Engineering Blog)
Une description détaillée de l’évolution des formats de stockage et des raisons qui la justifient peut être trouvée dans Apache Spark — Deep Dive into Storage Formats.
Recommandation pratique :
Pour tout nouveau développement il est préférable d’employer l’API DataFrame / Dataset plutôt que l’API RDD. L’API DataFrame / Dataset est plus expressive, bénéficie des optimisations de Catalyst et ses performances sont généralement supérieures. L’API RDD reste utile pour des opérations de bas niveau qui ne s’expriment pas naturellement en colonnes.
Déploiement
Un programme Spark s’exécute selon le schéma suivant (voir aussi la Fig. 18) :
Le programme driver contrôle la logique applicative, construit le graphe des transformations, le soumet au cluster et collecte les résultats finaux. Il doit tourner sur un nœud du cluster pour minimiser la latence de communication avec les workers.
Les executors (ou worker nodes) exécutent les tâches qui leur sont assignées et stockent les partitions en mémoire ou sur disque local.
Le gestionnaire de cluster (cluster manager) alloue les ressources. Spark supporte différents gestionnaires :
Standalone : gestionnaire intégré à Spark, simple à déployer, mais sans intégration avec d’autres systèmes.
Hadoop YARN : permet de partager le cluster avec d’autres jobs Map Reduce ou non-Map Reduce, format standard dans les environnements Hadoop.
Apache Mesos : gestionnaire généraliste, moins utilisé aujourd’hui.
Kubernetes : déploiement dans des conteneurs, mode de facto pour les déploiements cloud modernes (GKE, EKS, AKS).
Plusieurs applications Spark s’exécutant sur le même cluster sont complètement isolées (chacune dans sa propre JVM) et ne peuvent communiquer qu’à travers des fichiers.
Spark supporte les langages Scala (natif), Java, Python (PySpark) et R (SparkR, sparklyr). PySpark est le choix le plus répandu aujourd’hui pour la fouille de données et sera utilisé dans tous les TP de ce cours.
Bibliothèques de l’écosystème Spark
Au-delà du moteur de traitement de base, Spark propose un ensemble de bibliothèques couvrant l’ensemble des besoins de la fouille de données massives :
Bibliothèque |
Rôle |
|---|---|
MLlib |
Apprentissage statistique distribué : classification, régression, clustering, réduction de dimension, recommandation, pipelines ML |
Structured Streaming |
Traitement de flux de données en temps réel, avec la même API que les DataFrames batch (voir le chapitre sur les flux) |
GraphX / GraphFrames |
Calculs sur les graphes distribués : centralités, composantes connexes, PageRank, détection de communautés (voir le chapitre sur les graphes) |
SparkNLP (John Snow Labs) |
Traitement du langage naturel distribué : tokenisation, NER, plongements lexicaux, BERT, LLM (voir le chapitre sur la fouille de textesx) |
Spark SQL |
Requêtes SQL sur des DataFrames, connecteurs vers Hive, JDBC, Parquet, Delta Lake |
Ray
Ray [Mor+18] est un framework de calcul distribué développé depuis 2017 à l’UC Berkeley (ensuite par la société Anyscale), écrit en C++ avec une API Python. Il a été conçu avec un objectif différent de celui de Spark : non le traitement de données tabulaires en batch, mais la parallélisation d’algorithmes Python arbitraires, en particulier pour l’apprentissage automatique.
Motivations : au-delà du traitement batch
Spark excelle pour le traitement de données tabulaires en batch et l’application de modèles prédictifs. Mais certains cas d’usage résistent à cette approche :
L”entraînement distribué de modèles d’apprentissage profond, qui exige une communication fine entre workers (gradients, paramètres) et un ordonnancement dynamique des tâches, difficile à exprimer proprement avec Map Reduce ou avec des DataFrame Spark.
L”apprentissage par renforcement (Reinforcement Learning, RL), qui mêle simulation, entraînement GPU et orchestration asynchrone.
Le service de modèles (model serving) à faible latence, qui nécessite de maintenir un état entre les requêtes.
La recherche d”hyperparamètres par essais parallèles massifs.
Architecture
Ray repose sur un modèle d’acteurs distribués avec trois primitives fondamentales :
Task (
@ray.remotesur une fonction) : fonction sans état (stateless) exécutée de façon asynchrone sur un worker disponible. Les tâches peuvent dépendre les unes des autres, formant un graphe de calcul dynamique.Actor (
@ray.remotesur une classe) : instance avec état (stateful) déployée sur un worker. Permet de maintenir un état entre appels successifs (par ex. un modèle chargé en mémoire, un buffer de replay RL).Object : données immuables stockées dans l”Object Store distribué (mémoire partagée entre workers via Apache Plasma), accessibles depuis n’importe quel nœud du cluster.
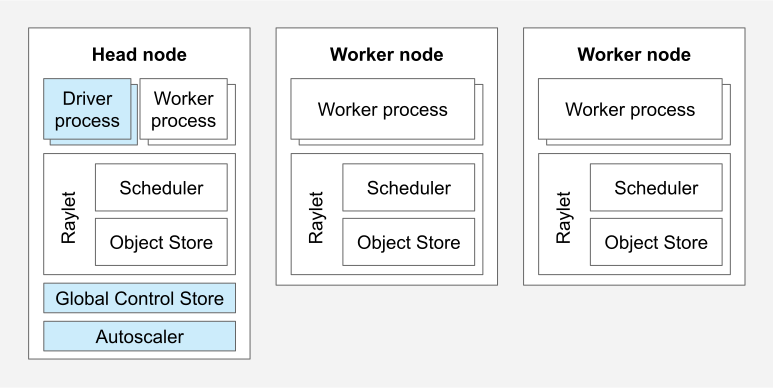
Fig. 23 Architecture de Ray : le Head Node héberge le Global Control Store et le scheduler ; les Worker Nodes exécutent tâches et acteurs et partagent les objets via l”Object Store distribué (source : documentation Ray)
Bibliothèques de l’écosystème Ray
Ray propose des bibliothèques spécialisées pour les cas d’usage d’apprentissage statistique (machine learning, ML) :
Bibliothèque |
Rôle |
|---|---|
Ray Train |
Entraînement distribué de modèles PyTorch, TensorFlow, XGBoost, avec gestion automatique des checkpoints et de la reprise sur panne |
Ray Tune |
Recherche distribuée d’hyperparamètres (grid search, random search, optimisation bayesienne, algorithmes évolutionnaires) avec des centaines d’essais en parallèle |
Ray Serve |
Service de modèles ML à faible latence, avec scalabilité automatique et composition de pipelines de modèles |
RLlib |
Bibliothèque de référence pour l’apprentissage par renforcement distribué ; utilisée entre autres par OpenAI et DeepMind |
Positionnement par rapport à Spark
Ray et Spark ne sont pas en concurrence directe mais répondent plutôt à des besoins complémentaires.
Spark est préféré pour la préparation de données à grande échelle (ETL, agrégations, jointures sur des téraoctets), l”application de modèles à grande échelle (scoring en batch) et les workflows de fouille de données tabulaires.
Ray est préféré pour le développement et l’entraînement de modèles complexes (deep learning, RL), la recherche d’hyperparamètres et le service de modèles en production à faible latence.
Des combinaisons existent : Spark on Ray (exécuter des jobs Spark sur un cluster Ray), Ray on Spark (lancer des workers Ray depuis un job Spark) permettent de combiner les points forts des deux systèmes dans une même pipeline.
Note :
Le support de Ray dans les TP de ce cours est limité : les TP utilisent Spark, plus adapté à un environnement JupyterLab de taille modeste et couvrant l’ensemble des sujets du cours. Ray sera mentionné ponctuellement lorsque son approche se distingue significativement de celle de Spark.
Tableau comparatif complet
Le tableau suivant synthétise les caractéristiques des principales plateformes abordées dans ce cours. Il complète et précise le tableau de la séance d’introduction.
Pandas |
Polars |
Dask |
Spark |
Ray |
MapReduce (Hadoop) |
Bases vectorielles |
|
|---|---|---|---|---|---|---|---|
Distribution |
Non |
Non |
Optionnelle |
Oui |
Oui |
Oui |
Variable |
Multi-cœur |
Non |
Oui (auto) |
Oui |
Oui |
Oui |
Oui |
Variable |
Données > RAM |
Non |
Partiel |
Oui |
Oui |
Oui |
Oui |
Oui |
Tolérance pannes |
Non |
Non |
Partielle |
Oui (lignage[#]_) |
Oui (lignage) |
Oui (HDFS) |
Oui |
Algorithmes itératifs |
Oui |
Oui |
Oui |
Très efficace |
Très efficace |
Lent (disque) |
— |
ML intégré |
Non |
Non |
Partiel |
MLlib (complet) |
Ray Train/Tune |
Non |
— |
Streaming |
Non |
Non |
Oui (limité) |
Structured Streaming |
Non natif |
Non |
— |
API Python |
Oui |
Oui |
Oui |
PySpark |
Oui (natif) |
Non natif |
Oui |
Facilité prise en main |
★★★★★ |
★★★★ |
★★★★ |
★★★ |
★★★ |
★★ |
★★★★ |
Point fort principal |
Référence universelle |
Rapidité mono-machine |
Pandas → cluster |
Batch + ML distribués |
ML avancé, RL |
Robustesse, maturité |
Recherche similarité |
Cas d’usage typique |
Exploration, prototypage |
Analyses rapides, quelques Go |
Données > RAM, code Pandas existant |
ETL, scoring, fouille de données massives |
Entraînement deep learning, hyperparamètres |
Pipelines Hadoop existants |
Recherche vecteurs denses |
Critères de choix en pratique :
Les données tiennent en RAM sur une seule machine ? Préférer Polars (rapidité) ou Pandas (familiarité).
Les données dépassent la RAM mais une seule machine suffit ? Préférer Dask.
Les données sont massives et on souhaite distribuer des calculs écrits avec NumPy/Pandas ? Préférer Dask.
Les données sont massives et les calculs sont du batch / ML / streaming ? Préférer Spark.
L’objectif est l’entraînement de modèles complexes ou la recherche d’hyperparamètres ? Préférer Ray, éventuellement en combinaison avec Spark pour la préparation des données.
L’infrastructure existante est basée sur Hadoop ? Spark est le choix naturel.
Dean, J. et S. Ghemawat. MapReduce: Simplified Data Processing on Large Clusters. OSDI’04: Sixth Symposium on Operating System Design and Implementation, San Francisco, CA, 2004.
Zaharia, M., M. Chowdhury, T. Das, A. Dave, J. Ma, M. McCauley, M. J. Franklin, S. Shenker et I. Stoica. Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing. USENIX NSDI, 2012.
Moritz, P., R. Nishihara, S. Wang, A. Tumanov, R. Liaw, E. Liang, M. Elibol, Z. Yang, W. Paul, M. I. Jordan et I. Stoica. Ray: A Distributed Framework for Emerging AI Applications. OSDI, 2018.
Damji, J. S., B. Wenig, T. Das et D. Lee. Learning Spark — Lightning-Fast Data Analytics, 2e édition. O’Reilly, 2020.