Cours - Aspects éthiques dans la fouille de données (2/2)
Supports complémentaires :
[Diapositives du cours : 2 par page] [Diapositives du cours : 1 par page]
Cette séance fait suite à la première séance qui a présenté la problématique générale et introduit les critères observationnels d’équité. Nous examinons ici la typologie et les sources des biais, des méthodes de détection de l’iniquité dans les modèles prédictifs et des méthodes de correction.
Dans la séance de travaux pratiques associée, une correction a posteriori est appliquée à un modèle pour rendre ses prédictions équitables suivant le critère de séparation (equalized odds).
Typologie et sources des biais
Le terme « biais » (bias) est fréquemment employé dans le contexte de la discrimination dans la prise de décision algorithmique ([BHN18], [MMSLG19], [Neil16]). Il est utile de clarifier ce terme car sa signification est sujette à confusions :
En statistique, le biais désigne un écart systématique entre l’espérance de la valeur estimée et la vraie valeur.
En apprentissage statistique, le biais correspond à une erreur systématique souvent attribuée à des hypothèses erronées (par exemple, choix d’une famille de modèles de capacité insuffisante).
Dans le contexte de la discrimination, par biais on entend des disparités démographiques légalement répréhensibles ou moralement discutables dans la prise de décision basée sur des algorithmes.
D’où proviennent ces disparités ?
Disparités introduites par la collecte des données
Les disparités dans les données ne proviennent pas toutes de disparités sociales préexistantes. La méthode de constitution des bases de données peut elle-même introduire ou renforcer des disparités. Par exemple, un échantillonnage de convenance (on sélectionne l’échantillon le plus facilement accessible) sur-représente les catégories majoritaires et sous-représente les groupes minoritaires, ce qui peut dégrader les performances du modèle précisément sur des groupes déjà défavorisés.
Mécanismes de transfert des disparités vers les modèles
Les disparités présentes dans les données peuvent être transférées aux modèles par plusieurs mécanismes :
Action directe : inclusion de variables protégées parmi les variables explicatives. Cela peut être explicitement prohibé par la législation (disparate treatment aux États-Unis).
Action par l’intermédiaire de proxy : une variable de substitution remplace une variable protégée non observable, non mesurable ou exclue. L’exemple classique aux États-Unis est l’emploi du zip code comme proxy de la « race ». Selon les variables employées, le lien entre proxy et variable protégée peut être plus ou moins difficile à mettre en évidence.
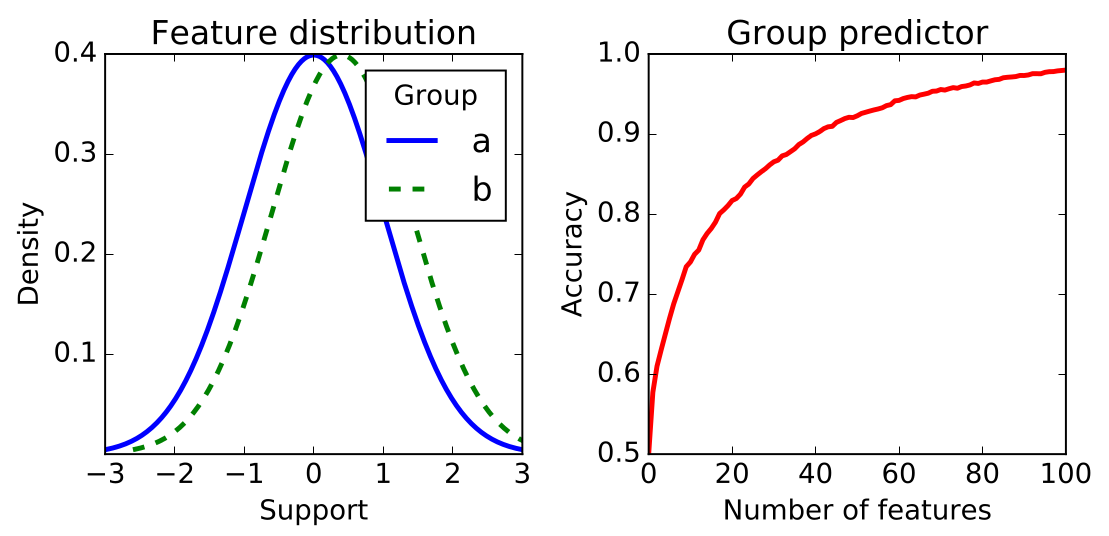
Action par l’intermédiaire de corrélations cumulées : l’absence de proxy clair ne signifie pas que l’attribut protégé est inaccessible, car des disparités dans les données peuvent engendrer des corrélations entre variables explicatives « anodines » et la variable protégée ; or, cumuler un nombre suffisant de variables « anodines » (chacune peu corrélée à la variable protégée) peut suffire pour estimer assez bien la valeur de la variable protégée. La Fig. 116 illustre ce mécanisme, qui correspond au disparate impact le plus difficile à caractériser : le modèle n’utilise ni la variable protégée ni de proxy évident, mais les corrélations accumulées lui permettent néanmoins d’y accéder implicitement. Cet accès indirecte à la variable protégée est le résultat de l’emploi d’un grand nombre de variables explicatives et n’est pas (en général) intentionnel de la part du modélisateur.
Détecter l’iniquité
Pour pouvoir agir contre la discrimination, il faut d’abord la détecter. Différentes techniques ont été développées à cette fin.
Techniques générales
Tests d’aveuglement (blinding) : vérifier que les attributs protégés (et parfois leurs proxies évidents) ne sont pas pris en compte, sans contrôler les autres variables.
Audits : tests d’aveuglement avec contrôle des autres variables (« toutes choses égales par ailleurs »). Les combinaisons d’attributs résultant de cette contrainte ne correspondent pas toujours à des cas réels, ce qui peut limiter l’applicabilité des audits.
Révéler l’arbitraire dans les décisions : mettre en évidence le caractère non systématique de la prise de décision, notamment en révélant des relations entre la décision et des facteurs qui ne devraient pas intervenir.
Tests basés sur les issues (outcomes) \(Y\), lorsqu’elles sont disponibles (par exemple \(Y\) = défaut ou remboursement du prêt, \(R\) = score sur lequel s’appuie la décision) :
Le test de suffisance (\(Y \perp\kern-5pt\perp A \,\, | \, R\)) consiste à vérifier, pour des candidats dont le score \(R\) est dans un intervalle étroit, s’il y a un même taux de \(Y=1\) pour chaque valeur de l’attribut protégé \(A\) (chaque groupe). Le test est difficile à appliquer pour le score dans un intervalle large car \(Y\) n’est pas disponible si \(R\) est trop bas.
En l’absence d’accès au score \(R\) il est possible d’appliquer un test de parité de prédiction, en vérifiant si le taux de \(Y=1\) est le même pour les candidats classés favorablement (\(\hat{Y}=1\)) dans chaque groupe.
Le test de séparation (\(R \perp\kern-5pt\perp A \,\, | \, Y\)) est difficile à appliquer car en général \(Y\) est observé seulement pour \(\hat{Y}=1\). Le test est donc possible seulement si on peut évaluer \(Y\) aussi pour \(\hat{Y}=0\).
Spécificités de la décision algorithmique
Quelles sont les différences entre la décision humaine et la décision algorithmique ? La décision humaine peut être non aveugle et non systématique (arbitraire), mais elle ne peut généralement pas traiter un grand nombre de variables pour imputer les valeurs manquantes d’un attribut protégé. En revanche, la décision algorithmique est systématique, les attributs protégés peuvent être exclus a priori, mais un algorithme peut inférer les valeurs des attributs protégés à partir des autres variables « anodines ».
En conséquence, pour la décision algorithmique :
Les tests d’aveuglement sont peu pratiqués car les attributs protégés peuvent être exclus a priori. Par ailleurs, le blinding est de peu d’utilité car les attributs protégés peuvent souvent être (partiellement) inférés des autres variables.
Révéler l’arbitraire n’a pas d’intérêt direct car une procédure algorithmique est systématique. En revanche, un excès de variables explicatives peut permettre (par surapprentissage) de trouver prédictifs des variables arbitraires, d’où l’importance de détecter le surapprentissage.
Les critères observationnels (parité démographique, parité des taux d’erreur, calibration) sont potentiellement applicables, avec les réserves mentionnées lors de leur présentation. Leur évaluation est cependant à considérer avec précaution : les résultats des tests peuvent avoir des explications autres que la discrimination. Deux exemples illustrent ce besoin de précaution :
Des moteurs de recherche généralistes ont été accusés de personnaliser les résultats même lorsque’on leur demande explicitement de ne pas les personnaliser. Ainsi, des recherches équivalentes donneraient des résultats qui dépendent des recherches antérieures, renforçant ainsi les croyances de la personne qui cherche. Une analyse plus approfondie a mis en évidence que les requêtes considérées « équivalentes » n’étaient pas identiques, chaque personne employait des termes spécifiques suivant ses croyances et ces termes orientaient différemment les résultats de recherche.
Un test a mis en évidence le fait qu’un site de vente en ligne qui a aussi des magasins « en dur » proposait des réductions plus fortes pour certains zip codes que pour d’autres (on rappelle que dans certains endroits le zip code peut être un proxy pour « race »). Un examen plus approfondi des raisons a permis de montrer que la réduction augmentait (suivant une pratique commerciale générale et naturelle) avec la concurrence locale autour du zip code, or cette concurrence était plus forte là où le pouvoir d’achat local était supérieur.
Ces exemples montrent qu’avant de tirer des conclusions définitives à partir des tests, il est nécessaire de comprendre le mécanisme exact qui mène au résultat observé.
Supprimer ou réduire l’iniquité
Trois approches générales ont été proposées pour supprimer ou réduire l’iniquité (les formulations ci-dessous sont parfois adaptées au critère d’indépendance mais s’appliquent à d’autres critères) : le prétraitement, l’intriduction de contraintes dans le processus d’apprentissage et le post-traitement. On rappelle que les critères d’équité étant en général incompatibles entre eux, le modèle résultant respectera le critère choisi au dépens des autres critères.
Approche 1 : Prétraitement
Le prétraitement vise à transformer la représentation des données pour enlever le biais (par exemple, la rendre indépendante des attributs protégés) avant d’apprendre le modèle. Cette approche exige l’accès complet aux données d’apprentissage et d’évaluation, ainsi qu’à l’attribut protégé.
Un avantage majeur est que, les biais des données étant supprimés, aucune restriction n’est imposée sur les méthodes de modélisation appliquées en aval.
Exemples de méthodes de prétraitement :
Compléter les données : suivre des plans d’expérience pour réduire les disparités présentes dans les données à la source.
Redressement de l’échantillon : augmenter les pondérations des individus appartenant à des populations sous-représentées.
Ré-échantillonnage : sous-échantillonnage des groupes sur-représentés, sur-échantillonnage (ou génération par interpolation, par exemple avec SMOTE [CBH02]) des groupes sous-représentés.
Approche 2 : Contrainte dans le processus d’apprentissage
Cette approche consiste à inclure le respect d’un critère d’équité directement dans le processus d’optimisation qui permet d’obtenir le modèle. Elle exige l’accès aux données, à l’attribut protégé et à la procédure d’apprentissage. Elle impose également des contraintes sur les familles de modèles utilisées et sur les procédures d’optimisation.
Exemple : le processus d’optimisation intègre en général le risque empirique et des termes de régularisation ; en introduisant un terme supplémentaire de « coût d’iniquité » (suivant le critère d’équité considéré), on obtient un compromis entre performance prédictive et respect de l’équité.
Approche 3 : Post-traitement
Le post-traitement vise à ajuster un modèle décisionnel déjà obtenu pour que ses décisions respectent le critère d’équité considéré. Cette approche ne nécessite pas l’accès aux données ni à la procédure d’apprentissage, en revanche elle exige l’accès à l’attribut protégé lors de la prédiction. Elle peut s’appliquer à tout modèle, y compris aux modèles de type « boîte noire ».
Exemples de méthodes de post-traitement :
Modification sélective des seuils de décision : lorsque le modèle fournit un score quantitatif, diminuer le seuil pour les groupes défavorisés et l’augmenter pour les groupes favorisés (voir [HPS16]).
Randomisation partielle des prédictions : lorsque le modèle fournit directement une prédiction binaire \(\hat{Y}\), par randomisation partielle des prédictions il est possible de respecter un critère observationnel d’équité en diminuant le moins possible les performances de prédiction (voir [HPS16]). Cette approche est mise en œuvre dans la séance de travaux pratiques.
Remarque importante. Toutes les approches qui visent à supprimer ou à réduire l’iniquité exigent l’accès à l’attribut protégé, même si le modèle a été initialement développé sans accès à cet attribut. La correction suppose de savoir à quel groupe appartient chaque individu au moment de la prédiction.
Méthode de post-traitement par randomisation [HPS16]
Cette méthode est générale, applicable à un modèle qui fait des prédictions binaires (sans score quantitatif), sans accès aux données d’apprentissage ni à la procédure d’apprentissage. Elle cherche à maximiser la performance (accuracy) du modèle corrigé tout en respectant le critère de séparation (equalized odds).
Principe. Pour le modèle initial, les taux de faux positifs (TFP) et de vrais positifs (TVP) sont différents selon les groupes ; c’est en cela que le critère de séparation n’est pas respecté. Pour corriger le modèle il est nécessaire d’augmenter le taux de prédictions positives (et ainsi à la fois le taux de vrais positifs et le taux de faux positifs) lorsque l’attribut protégé prend la valeur « défavorisée » et/ou de réduire le taux de prédictions positives lorsque l’attribut protégé prend la valeur « favorisée ». Si le modèle initial disponible prédit directement une variable nominale \(\hat{Y}\) (sans passer par un score intermédiaire \(R\)), une façon de faire ces modifications est d’utiliser une procédure de randomization :
Pour les membres du groupe défavorisé on convertit aléatoirement une proportion des prédictions négatives en prédictions positives (augmentation du TVP et du TFP).
Pour les membres du groupe favorisé on convertit aléatoirement une proportion des prédictions positives en prédictions négatives (réduction du TVP et du TFP).
Il faut déterminer les corrections à faire (calculer les taux de conversion de prédictions) afin de respecter le critère equalized odds tout en maximisant la performance (accuracy) du modèle corrigé. Dans [HPS16] on démontre qu’un modèle corrigé respectant le critère equalized odds doit avoir sa réponse dans la région admissible, qui est l’intersection entre les triangles définis dans le diagramme ROC par les points du modèle initial pour chaque groupe et les coins [0,0] et [1,1], voir la Fig. 117.
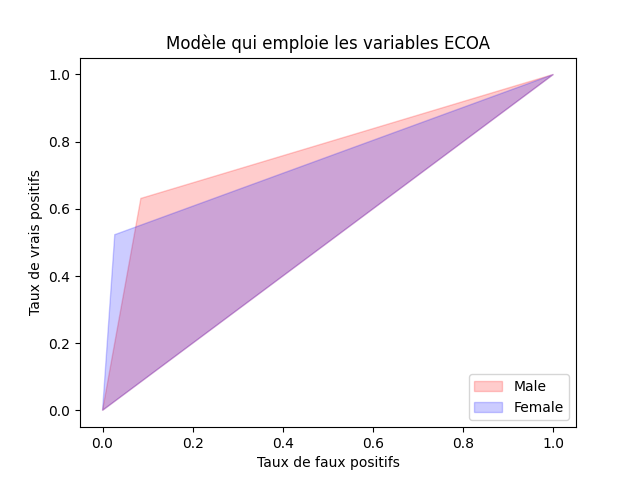
Fig. 117 Région admissible (intersection des deux triangles) pour la correction equalized odds. Pour une performance maximale, le point cible est celui du domaine admissible le plus éloigné de la diagonale. Illustration issue de notre séance de travaux pratiques.
Dans ce domaine admissible, le point de performance (accuracy) maximale est le point du domaine admissible qui est le plus éloigné de la diagonale. Il peut être trouvé comme solution d’un problème d’optimisation linéaire. Dans le cas fréquent où le domaine admissible est un simple triangle, comme dans la Fig. 117, ce point est l’intersection des droites reliant chaque point du modèle initial aux coins [0,0] et [1,1] respectivement.
Calcul des taux de conversion. À partir des coordonnées du point cible et des taux (de vrais positifs et de faux positifs) du modèle initial pour chaque groupe, les taux de conversion de prédictions (proportions de prédictions à modifier) se calculent analytiquement, comme détaillé dans la séance de travaux pratiques.
Lors de la prédiction, la décision du modèle initial est conservée ou modifiée en fonction de la valeur de l’attribut protégé et d’un tirage aléatoire, en respectant les taux de changement précalculés. L’accès à l’attribut protégé est donc indispensable, même si le modèle initial a été développé sans lui.
Solon Barocas, Moritz Hardt, and Arvind Narayanan. Fairness and Machine Learning Limitations and Opportunities. 2018.
CERNA Collectif. Research Ethics in Machine Learning. Technical report.
Moritz Hardt, Eric Price, and Nati Srebro. Equality of opportunity in supervised learning. In Advances in Neural Information Processing Systems, volume 29. Curran Associates, Inc., 2016.
Ninareh Mehrabi, Fred Morstatter, Nripsuta Saxena, Kristina Lerman, and Aram Galstyan. A survey on bias and fairness in machine learning, 2019.
Cathy O’Neil. Weapons of Math Destruction: How Big Data Increases Inequality and Threatens Democracy. Crown Publishing Group, USA, 2016.
Poibeau, T. 2025. Understanding Conversational AI: Philosophy, Ethics and Social Impact of Large Language Models. Pp. 149–175. London: Ubiquity Press.
Nitesh V. Chawla, Kevin W. Bowyer, Lawrence O. Hall, and W. Philip Kegelmeyer. SMOTE: synthetic minority over-sampling technique. J. Artif. Int. Res. 16, 1 (juin 2002), 321-357.