Travaux pratiques - Analyse d’un grand graphe (Medline)
Références externes utiles :
Objectif du TP
Nous analysons ici un graphe réel de grande taille, construit à partir d’une base de publications scientifiques (MEDLINE). Les tags thématiques (MeSH) des articles constituent les nœuds du graphe ; deux tags sont reliés s’ils apparaissent ensemble comme sujets principaux dans au moins un article (co-occurrence).
Le TP est organisé en quatre parties :
Construction du graphe à partir des données XML ;
Propriétés structurelles : composantes connexes, distribution de degrés, coefficient de clustering ;
Centralités : nœuds les plus influents selon différentes mesures ;
Détection de communautés : Label Propagation (GraphFrames) et Louvain (NetworkX), comparaison et interprétation.
Description des données
MEDLINE est la base de données bibliographique du NIH (équivalent
américain de l’INSERM), disponible en ligne depuis 1996 et contenant plus de
20 millions d’articles en médecine et sciences du vivant. Chaque article est
annoté par des mots-clefs MeSH (Medical Subject Headings), dont certains
sont désignés comme sujets principaux (attribut MajorTopicYN="Y").
Le graphe que nous construisons a pour sommets les tags MeSH principaux, et une arête entre deux tags dès qu’ils co-apparaissent dans au moins un article. Les arêtes sont valuées par le nombre d’articles partageant les deux tags.
La Fig. 78 illustre la construction de ce graphe. Les mots-clefs en rouge sont les tags MeSH principaux. La présence de « AAA », « BBB » et « CCC » comme tags dans l’article 1 induit la présence de 3 arêtes : (AAA - BBB), (BBB - CCC), (AAA - CCC).
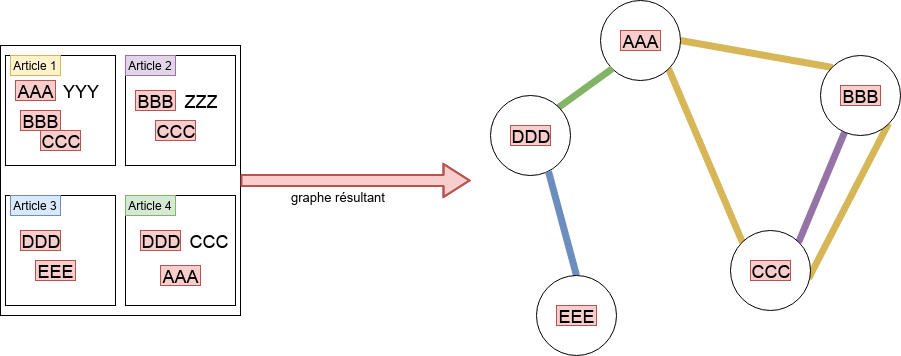
Fig. 78 Construction du graphe : les tags en rouge sont les MajorTopics. L’article 1 (tags AAA, BBB, CCC) induit trois arêtes.
Partie 1 : Construction du graphe
Récupération des données
import os, sys

dossier_tp  = "tpGraphes/medline_data/"
fichier_xml = dossier_tp + "medsamp2016a.xml"

if not os.path.exists(fichier_xml):
    os.system("mkdir -p " + dossier_tp)
    sortie = "téléchargement OK" if os.system(
        "wget -q -nc ftp://ftp.nlm.nih.gov/nlmdata/sample/medline/"
        "medsamp2016*.xml.gz -P " + dossier_tp) == 0 \
        else "problème de téléchargement"
    print(sortie)
    os.system("gunzip " + dossier_tp + "*gz")
else:
    print("fichiers présents dans " + dossier_tp)
!ls -lh tpgraphes/medline_data/*xml
Initialisation de Spark et GraphFrames :
os.environ['PYSPARK_PYTHON'] = sys.executable
os.environ['PYSPARK_DRIVER_PYTHON'] = sys.executable
os.environ['PYSPARK_SUBMIT_ARGS'] = '--packages graphframes:graphframes:0.8.1-spark3.0-s_2.12,com.databricks:spark-xml_2.12:0.18.0 pyspark-shell'
from pyspark.sql import SparkSession

spark = SparkSession.builder.getOrCreate()
sc = spark.sparkContext
Construction du graphe de co-occurrences
topicPairs = medline.flatMap(lambda l: combinations(sorted(l), 2))
cooccurs   = topicPairs.map(lambda p: (p, 1)).reduceByKey(add)
cooccurs.cache()
print(f"Nombre de co-occurrences distinctes : {cooccurs.count()}")
Question
Quel est le nombre maximal théorique de co-occurrences pour \(n\) MajorTopics distincts ? Comparez au nombre effectivement observé et commentez la densité du graphe.
from pyspark.sql.types import StructType, StructField, StringType, IntegerType

edges_schema   = StructType([
    StructField('src',  StringType(),  True),
    StructField('dst',  StringType(),  True),
    StructField('freq', IntegerType(), True)])
edges = spark.createDataFrame(
    cooccurs.map(lambda l: (l[0][0], l[0][1], l[1])), schema=edges_schema)

vertices_schema = StructType([
    StructField('id',   StringType(), True),
    StructField('hash', StringType(), True)])
vertices = spark.createDataFrame(
    topics.distinct().map(lambda t: (t, str(hash(t)))), schema=vertices_schema)

from graphframes import GraphFrame
topicGraph = GraphFrame(vertices, edges)

print(f"Sommets : {topicGraph.vertices.count()}")
print(f"Arêtes  : {topicGraph.edges.count()}")
Partie 2 : Propriétés structurelles
Composantes connexes
import os
os.makedirs("checkpoints", exist_ok=True)
spark.sparkContext.setCheckpointDir('checkpoints')

topicCC = topicGraph.connectedComponents()
from pyspark.sql import functions as F

# Taille des 15 plus grandes composantes connexes
topicCCrdd = topicCC.select('component').rdd.map(lambda r: r['component'])
cc         = topicCCrdd.countByValue()
cc_sorted  = sorted(cc.items(), key=lambda x: x[1], reverse=True)

print(f"Nombre total de composantes connexes : {len(cc_sorted)}")
print("\nRang | Taille")
print("-" * 20)
for k, (cid, size) in enumerate(cc_sorted[:15]):
    print(f"  {k+1:2d} | {size:6d}")
Question
Qu’observez-vous ? La composante connexe géante (CCG) regroupe-t-elle la grande majorité des nœuds ? Que révèle la présence de nombreuses petites composantes ?
Question
Affichez les nœuds des composantes de rang 2 à 5. Ces tags semblent-ils appartenir à une thématique particulière ?
Distribution de degrés
degrees = topicGraph.degrees
degrees.describe('degree').show()
# Distribution : combien de nœuds ont chaque degré ?
d_rdd      = degrees.select("degree").rdd.flatMap(lambda x: x)
freqDegres = d_rdd.countByValue()
distribDeg = sorted(freqDegres.items(), key=lambda x: x[0], reverse=True)

print(f"{'Degré':>8} | {'Nb nœuds':>10}")
print("-" * 22)
for deg, nb in distribDeg[:20]:
    print(f"{deg:8d} | {nb:10d}")
# Les 10 nœuds de plus fort degré
from pyspark.sql.functions import desc
topicGraph.degrees.orderBy(desc('degree')).show(10, truncate=False)
Question
La distribution de degrés est-elle homogène (style gaussienne/Poisson) ou hétérogène (quelques nœuds avec un très fort degré, majorité de nœuds à faible degré) ? Que dit-on d’un tel graphe ?
Exercice
Visualisez la distribution de degrés en échelle log-log en utilisant Matplotlib. Observez-vous une droite ? Que cela implique-t-il sur la forme de la distribution ?
Coefficient de clustering global
Le coefficient de clustering mesure la densité locale des triangles. GraphFrames ne le calcule pas directement. Nous nous servons de basculer sur NetworkX, une bibliothèque Python (non distribuée) qui charge l’intégralité du graphe en mémoire sur une seule machine.
Note
Pourquoi NetworkX est acceptable ici et où se situent ses limites.
Le graphe Medline que nous utilisons (échantillon NIH, 8 fichiers) contient environ 14 500 nœuds et 213 000 arêtes. NetworkX stocke ce graphe dans des dictionnaires Python imbriqués : les arêtes étant représentées dans les deux sens (graphe non orienté), cela correspond à env. 426 000 entrées, soit 150 à 200 Mo en mémoire vive. Cela tient donc parfaitement sur un ordinateur (y compris sur notre JupyterHub lorsque plusieurs utilisateurs travaillent simultanément), la mémoire occupée par un graphe de cette taille étant faible par rapport à la RAM disponible par session)
En revanche, Medline complet (28 millions d’articles, plusieurs centaines de milliers de MeSH distincts, potentiellement des dizaines de millions d’arêtes) dépasserait largement la mémoire d’une machine standard avec NetworkX. Il faudrait alors rester dans GraphFrames pour l’intégralité des calculs ou utiliser une autre des bibliothèques conçues pour les grands graphes distribués (GraphX, cuGraph sur GPU, etc.).
Le choix de NetworkX ici illustre une pratique courante dans l’analyse de graphes réels de taille moyenne, tout en restant explicite sur ses limites de passage à l’échelle.
import networkx as nx

# Extraction des identifiants de la CCG depuis Spark
cid_giant = cc_sorted[0][0]
giant_ids = set(
    topicCC.filter(topicCC.component == cid_giant)
           .select("id").rdd.flatMap(lambda x: x).collect())

# Chargement du sous-graphe CCG en mémoire locale (NetworkX)
# collect() rapatrie toutes les arêtes depuis Spark vers le driver Python
G_giant = nx.Graph()
for row in topicGraph.edges.collect():
    if row['src'] in giant_ids and row['dst'] in giant_ids:
        G_giant.add_edge(row['src'], row['dst'])

print(f"Nœuds CCG (NetworkX) : {G_giant.number_of_nodes()}")
print(f"Arêtes CCG (NetworkX): {G_giant.number_of_edges()}")
print(f"Coefficient de clustering global : {nx.transitivity(G_giant):.4f}")
print(f"Coefficient de clustering moyen  : {nx.average_clustering(G_giant):.4f}")
Question
Comparez ces valeurs à la densité du graphe. Est-ce étonnant que le coefficient de clustering soit bien supérieur à la densité ? Que suggère cela sur la structure du réseau ?
Partie 3 : Centralités
Centralité de degré
Les nœuds de fort degré ont déjà été identifiés. Vérifions si les tags généraux dominent et si on peut les filtrer.
# Tags de très fort degré : sont-ils informatifs ?
hub_threshold = 500
hubs = topicGraph.degrees.filter(f"degree > {hub_threshold}")
print(f"Nœuds avec degré > {hub_threshold} : {hubs.count()}")
hubs.orderBy(desc('degree')).show(20, truncate=False)
Question
Ces hubs sont-ils des termes médicaux spécifiques ou des termes génériques ? Pour une analyse thématique, faut-il les filtrer ?
Centralité d’intermédiarité
Le calcul exact de l’intermédiarité sur l’ensemble du graphe a une complexité
\(O(nm)\) (environ 3 milliards d’opérations ici) et nécessite de
maintenir en mémoire les chemins depuis chaque nœud source. On utilise
l”approximation de Brandes : on tire aléatoirement k sources et on
extrapole. Avec k=200 sources sur env. 14 000 nœuds le calcul dure
quelques secondes et la mémoire supplémentaire reste négligeable.
# Estimation par k sources aléatoires (approximation de Brandes)
k_sources = 200    # augmenter pour plus de précision
betweenness = nx.betweenness_centrality(G_giant, k=k_sources, normalized=True)

top_betw = sorted(betweenness.items(), key=lambda x: x[1], reverse=True)[:15]
print(f"{'Tag':40s} {'Betweenness':>12}")
print("-" * 55)
for tag, score in top_betw:
    print(f"{tag:40s} {score:12.6f}")
Question
Les nœuds de forte intermédiarité sont-ils les mêmes que les nœuds de degré élevé ? Quelle interprétation médicale peut-on donner aux nœuds qui ont une intermédiarité élevée malgré un degré modéré ?
PageRank
pr_results = topicGraph.pageRank(resetProbability=0.15, tol=0.01)
pr_results.vertices.orderBy(desc('pagerank')).show(15, truncate=False)
Exercice
Comparez les classements obtenus par degré, intermédiarité et PageRank. Construisez un tableau (ou DataFrame Pandas) des 20 premiers nœuds selon chaque mesure, et identifiez les tags qui apparaissent dans les trois classements.
Partie 4 : Détection de communautés
Label Propagation avec GraphFrames
GraphFrames implémente nativement l’algorithme de propagation d’étiquettes, ce qui permet de travailler directement sur le graphe avec Spark.
# Détection par Label Propagation (5 itérations)
lp_result = topicGraph.labelPropagation(maxIter=5)
lp_result.cache()
# Nombre de communautés détectées
n_communities_lp = lp_result.select("label").distinct().count()
print(f"Nombre de communautés (Label Propagation) : {n_communities_lp}")
# Taille des 20 plus grandes communautés
comm_sizes_lp = (lp_result
    .groupBy("label")
    .agg(F.count("id").alias("taille"))
    .orderBy(desc("taille")))
comm_sizes_lp.show(20)
Question
Combien de communautés obtient-on ? La distribution des tailles est-elle équilibrée ou y a-t-il quelques très grandes communautés et beaucoup de petites ?
# Contenu de la plus grande communauté : quels tags ?
top_label = comm_sizes_lp.first()['label']
print(f"Plus grande communauté (label={top_label}), quelques membres :")
lp_result.filter(f"label = {top_label}").select("id").show(30, truncate=False)
Exercice
Refaites le calcul avec maxIter=10. Le nombre de communautés change-t-il ?
Les tailles sont-elles différentes ? Label Propagation est-il stable ?
Louvain avec NetworkX
Pour obtenir une partition de meilleure qualité on applique l’algorithme de
Louvain sur la CCG avec NetworkX. La bibliothèque python-louvain (module
community) est nécessaire, si elle n’est pas déjà disponible alors elle
est installée :
import sys
try:
  import community as community_louvain
except:
  !{sys.executable} -m pip install python-louvain
  import community as community_louvain
import community as community_louvain

# Application de Louvain sur la CCG NetworkX
partition = community_louvain.best_partition(G_giant)
# partition : dict {nœud -> id_communauté}

n_comm_louvain = len(set(partition.values()))
print(f"Nombre de communautés (Louvain) : {n_comm_louvain}")

# Calcul de la modularité du partitionnement
Q = community_louvain.modularity(partition, G_giant)
print(f"Modularité Q = {Q:.4f}")
# Distribution des tailles
from collections import Counter
sizes = Counter(partition.values())
sizes_sorted = sorted(sizes.items(), key=lambda x: x[1], reverse=True)

print(f"{'Rang':>4} | {'Id communauté':>14} | {'Taille':>8}")
print("-" * 35)
for k, (cid, sz) in enumerate(sizes_sorted[:20]):
    print(f"{k+1:4d} | {cid:14d} | {sz:8d}")
Question
Comparez le nombre de communautés et la valeur de modularité entre Label Propagation et Louvain. Laquelle des deux partitions semble être de meilleure qualité ?
Interprétation thématique des communautés
Pour donner du sens aux communautés, on extrait les tags les plus fréquents de chacune.
# Construction d'un DataFrame communauté → liste de tags
import pandas as pd

# Tags les plus fréquents de chaque communauté Louvain
# On utilise topicCounts pour pondérer par la fréquence dans les articles
node_comm = pd.DataFrame([
    {'id': node, 'communaute': cid}
    for node, cid in partition.items()
])

# Fréquences des tags (depuis topicCounts calculé plus tôt)
freq_df = pd.DataFrame(topicCounts.items(), columns=['id', 'freq'])
node_comm = node_comm.merge(freq_df, on='id', how='left')

# Top 10 des *tags* par communauté (triés par fréquence)
top_tags_by_comm = (node_comm
    .sort_values('freq', ascending=False)
    .groupby('communaute')
    .head(10)
    .groupby('communaute')['id']
    .apply(list)
    .reset_index()
    .rename(columns={'id': 'top_tags'}))

# Affichage des 10 plus grandes communautés
top_comm_ids = [cid for cid, _ in sizes_sorted[:10]]
for cid in top_comm_ids:
    tags = top_tags_by_comm[top_tags_by_comm.communaute == cid]['top_tags'].values
    if len(tags) > 0:
        print(f"\nCommunauté {cid} (taille {sizes[cid]}) :")
        print("  ", ", ".join(tags[0][:8]))
Question
Pouvez-vous identifier une thématique médicale dominante pour chacune des 10 plus grandes communautés ? Les communautés vous semblent-elles thématiquement cohérentes ?
Exercice
Calculez la modularité du partitionnement de Label Propagation en utilisant NetworkX et comparez-la à celle de Louvain. Pour cela, il faut convertir le résultat de Label Propagation (stocké dans un DataFrame Spark) en un dictionnaire Python.
Robustesse : suppression des hubs
Les hubs (tags très généraux comme « Research », « Disease ») connectent de nombreux autres tags sans être thématiquement informatifs. On examine l’impact de leur suppression sur la structure du graphe.
# Liste des hubs à supprimer (seuil de 500 défini plus haut)
hub_ids = set(hubs.select("id").rdd.flatMap(lambda x: x).collect())
print(f"Nombre de hubs supprimés : {len(hub_ids)}")

# Sous-graphe sans les hubs
G_no_hubs = G_giant.copy()
G_no_hubs.remove_nodes_from(hub_ids)

# Nouvelles composantes connexes
ccs = sorted(nx.connected_components(G_no_hubs), key=len, reverse=True)
print(f"Nombre de composantes connexes après suppression : {len(ccs)}")
print(f"Taille de la plus grande : {len(ccs[0])}")
print(f"Taille de la 2e          : {len(ccs[1]) if len(ccs) > 1 else 'N/A'}")
Question
La suppression des hubs fragmente-t-elle la CCG ? Est-ce cohérent avec la propriété des réseaux sans échelle de robustesse aux pannes aléatoires mais vulnérabilité aux attaques ciblées (sur les hubs) ?
Bibliographie
Karau, H., Konwinski, A., Wendell, P. et Zaharia, M. Learning Spark. O’Reilly, 2015.
Ryza, S., Laserson, U., Owen, S. and Wills, J. Advanced Analytics with Spark. O’Reilly, 2015.
Kastrin, A. et al. Large-Scale Structure of a Network of Co-Occurring MeSH Terms: Statistical Analysis of Macroscopic Properties. PLOS ONE, 2014.
Blondel, V. D. et al. Fast unfolding of communities in large networks. Journal of Statistical Mechanics, 2008.