Cours - Fouille de données textuelles (2/2) : Transformers et modèles de langage
Supports complémentaires :
[Diapositives du cours : 2 par page] [Diapositives du cours : 1 par page]
Dans le cours précédent nous avons décrit les représentations classiques de texte, du modèle vectoriel avec pondérations TF-IDF aux plongements lexicaux (Word2Vec, GloVe, FastText). Toutes ces représentations souffrent d’une limitation fondamentale : elles associent à chaque mot un vecteur unique, indépendant du contexte dans lequel le mot apparaît, ce qui ne permet pas au contexte de lever l’éventuelle ambiguïté.
Ce cours présente les représentations contextuelles fondées notamment sur l’architecture transformer [VSP17] et les grands modèles de langage (Large Language Models, LLM) qui en sont issus. Les lecteurs sont supposés connaître les réseaux de neurones multicouches (feed forward) et les réseaux récurrents.
Limites des approches précédentes
Avant l’émergence des transformers, les représentations contextuelles les plus performantes reposaient sur les réseaux récurrents de type LSTM (Long Short-Term Memory). Un LSTM parcourt la séquence soit de gauche à droite soit bidirectionnellement, en maintenant un état caché qui « résume » les tokens précédents. ELMo [PNI18] exploite des LSTM bidirectionnels pour produire des représentations contextualisées : le vecteur qui représente un mot dans une phrase inclut une représentation de son contexte dans cette phrase. A deux contextes différents pour un même mot correspondent donc des représentations différentes du mot, permettant de lever une éventuelle ambiguïté.
Deux limites structurelles des réseaux récurrents ont motivé l’invention des transformers :
Dépendances longue portée : l’état caché d’un LSTM doit propager l’information d’un token jusqu’à des tokens très éloignés dans la séquence. Cette propagation est imparfaite, ce qui rend difficile la modélisation de relations entre mots distants.
Non parallélisable : le calcul de l’état caché au temps \(t\) dépend de l’état au temps \(t-1\). L’entraînement est donc séquentiel et difficile à distribuer sur GPU, ce qui limite fortement le passage à l’échelle.
L’architecture transformer [VSP17] résout ces deux problèmes en remplaçant la récurrence par un mécanisme d”attention calculé en parallèle sur toute la séquence.
L’architecture Transformer
Le transformer original [VSP17] est une architecture encodeur-décodeur envisagée pour la traduction automatique. Ses composants fondamentaux — l’attention et l’encodage positionnel — sont depuis mis en œuvre dans de nombreuses variantes.
Le mécanisme d’attention
L’idée centrale de l’attention est de permettre à chaque position d’une séquence de « regarder » (ou considérer) directement toutes les autres positions, avec une pondération qui reflète leur pertinence pour la position courante.
Pour chaque token, trois vecteurs sont calculés par transformation linéaire de son encodage (embedding) :
Query (\(Q\)) : « ce que je cherche »
Key (\(K\)) : « ce que je contiens »
Value (\(V\)) : « ce que je transmets »
L’attention entre une query et toutes les keys est calculée par produit scalaire normalisé suivi de softmax (le calcul est fait pour un ensemble de queries à la fois, d’où l’expression matricielle) :
où \(d_k\) est la dimension des vecteurs query et key (la normalisation par \(\sqrt{d_k}\) évite des valeurs de produits scalaire trop élevées pour les grandes dimensions, donc la saturation de softmax qui a pour conséquence des gradients trop petits). Le résultat final est une somme pondérée des vecteurs value (de dimension \(d_v\)), les poids reflétant la pertinence de chaque token de la séquence (key) pour la position courante (query).
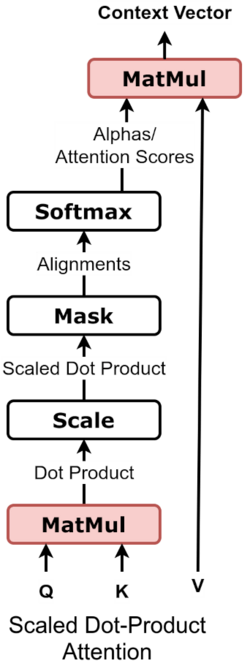
Fig. 53 Mécanisme d’attention : chaque token interroge l’ensemble de la séquence via le produit scalaire Query·Key, puis agrège les vecteurs Value en proportion de ces scores (source de l’illustration : dvgodoy, CC BY 4.0 via Wikimedia Commons)
Lorsque queries, keys et values proviennent de la même séquence, on parle de self-attention (ou attention intra-séquence). Dans un encodeur, la self-attention permet à chaque token d’intégrer le contexte de toute la phrase en un seul calcul matriciel entièrement parallélisable.


Attention avec têtes multiples (multi-head attention)
Plutôt qu’une seule fonction d’attention, le transformer utilise \(h\) fonctions d’attention en parallèle, les sorties étant concaténées puis reprojetées :
Chaque tête peut ainsi spécialiser son attention sur un aspect différent des relations entre tokens : syntaxe, coréférence, sémantique, etc.
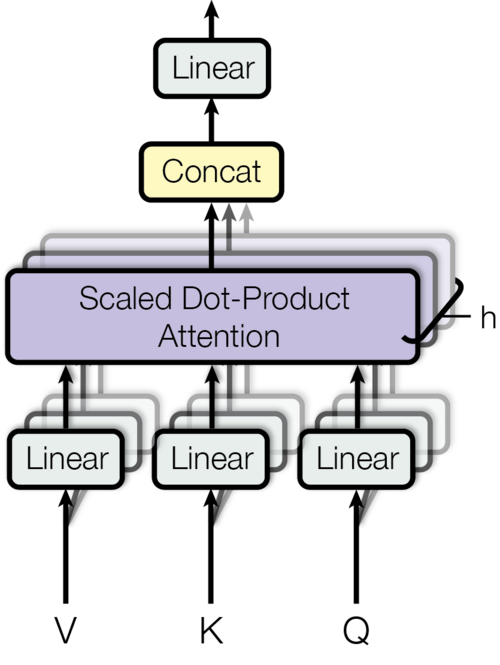
Fig. 54 Multi-head attention : plusieurs têtes capturent différents types de relations entre tokens (source de l’illustration : Google, CC BY-SA 4.0, via Wikimedia Commons)
Encodage positionnel (positional encoding)
Contrairement aux LSTM, la self-attention est invariante à l’ordre des tokens (permuter les tokens ne change pas les scores d’attention), or l’ordre est important. Il est donc nécessaire d”injecter l’information de position dans les encodages des tokens d’entrée. Pour chaque token, la position est encodée sur un vecteur de même dimension que l’encodage en entrée de l’attention et ce vecteur est additionné à l’encodage du token.
Le transformer original employait des fonctions sinusoïdales pour encoder la position absolue du token dans la séquence d’entrée :
où \(d_{\text{model}}\) est la dimension de l’encodage, \(0 \le i < d_{\text{model}}/2\), \(pos\) est la position du token dans la séquence et 10000 est la constante employée dans le papier d’origine [VSP17]. On observe que les valeurs des positions paires dans le vecteur sont données par la fonction sinus et les valeurs des positions impaires par la fonction cosinus.
Les modèles récents utilisent en général des encodages positionnels appris (learned positional embeddings) ou des encodages relatifs (RoPE, ALiBi).
Bloc transformer et architecture complète
Le transformer complet empile \(N\) blocs encodeurs et \(N\) blocs décodeurs, comme dans la Fig. 55.
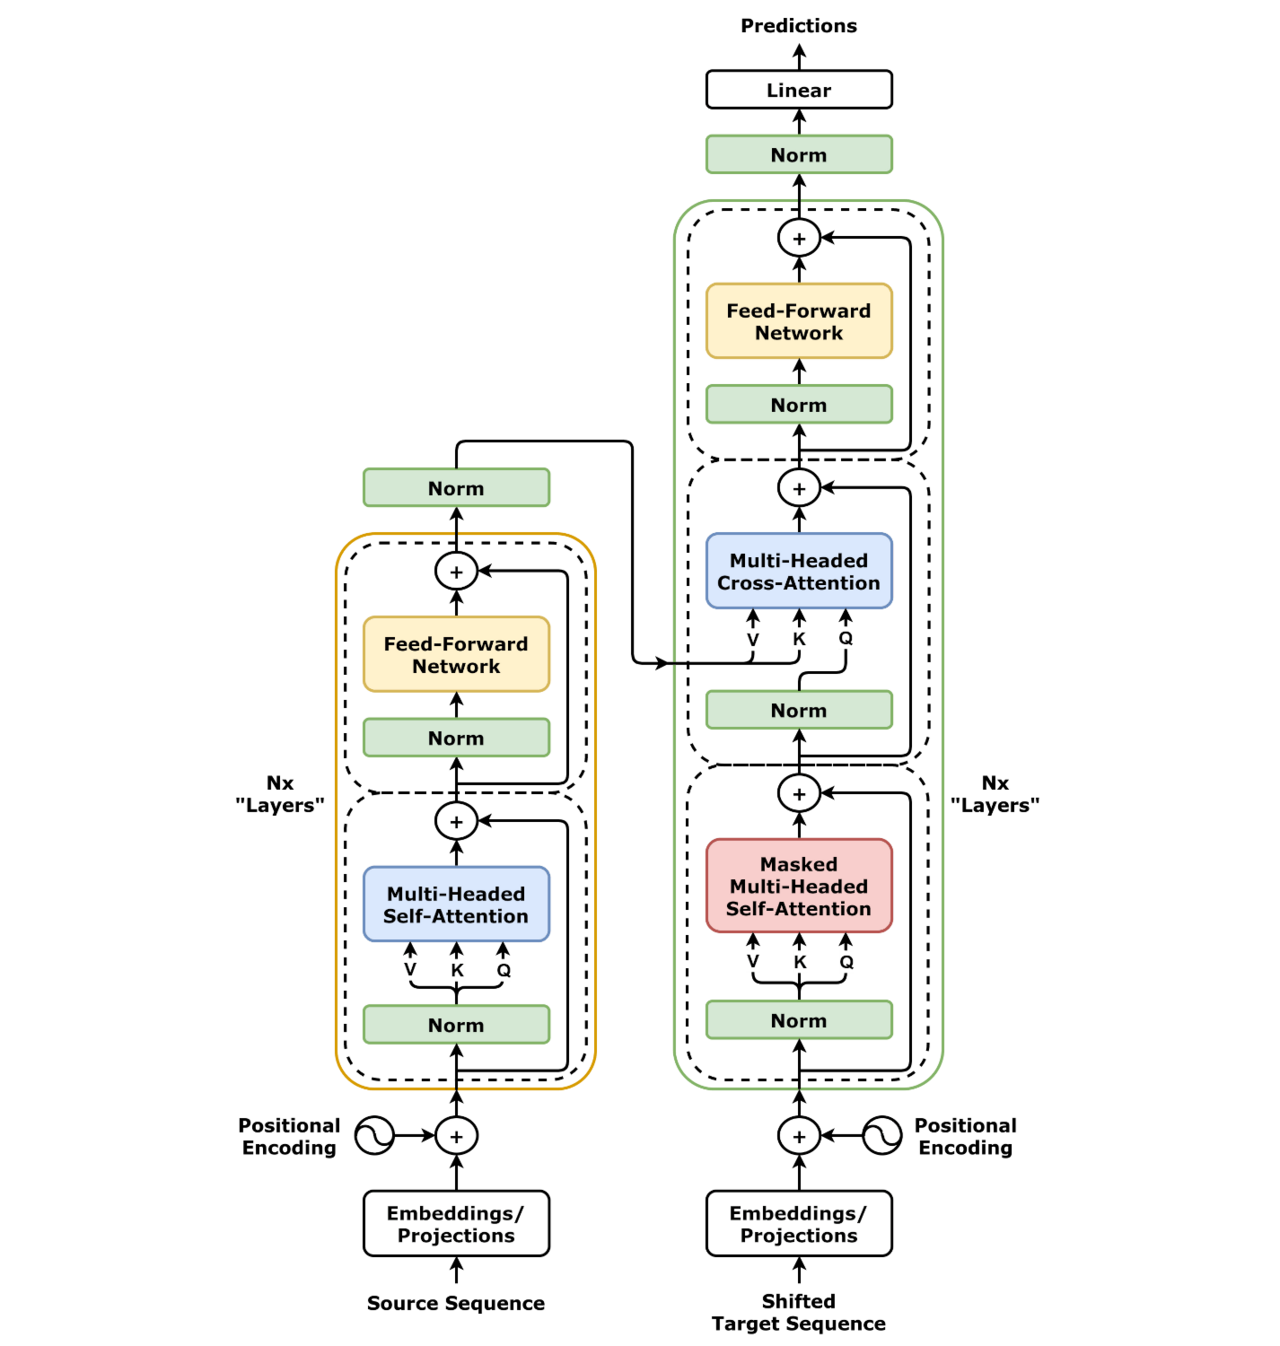
Fig. 55 Architecture complète d’un transformer. Le côté gauche est l’encodeur, le côté droit le décodeur. (source de l’illustration via Wikimedia Commons)

Un bloc de l’encodeur combine :
Une couche de multi-head self-attention avec connexion résiduelle et normalisation des activations (layer norm).
Un réseau feed-forward à deux couches (expansion puis contraction de la dimension) avec connexion résiduelle et normalisation des activations.
Un bloc du décodeur introduit en plus, entre la couche multi-head self-attention et le réseau feed-forxard, une couche de cross-attention avec Key et Value provenant de la sortie de l’encodeur.
Il est utile de noter qu’à chaque moment une séquence entière de tokens (correspondant à une ou plusieurs phrases) est introduite en entrée d’un transformer (sous une forme matricielle), la sortie associée de l’encodeur (transmise sur les entrées V et K de la couche multi-head self-attention de chaque bloc du décodeur) est donc également une matrice qui concerne la séquence entière.
Modèles de langage pré-entraînés
Un modèle de langage (ou modèle de langue, language model) est un modèle statistique de la distribution de composantes (caractères, tokens, mots) dans une langue, permettant surtout de prédire la composante suivante étant données les composantes précédentes (voir cette définition).
L’architecture transformer a conduit à une famille de modèles de langage pré-entraînés qui partagent une même approche de construction : pré-entraînement auto-supervisé sur de très grandes quantités de texte, ensuite adaptation par fine-tuning supervisé à des tâches spécifiques. On parle alors de grands modèles de langage (Large Language Models, LLM).
Tokenisation par sous-mots
Avant l’encodage, le texte est découpé en sous-mots (subword tokens) par des algorithmes comme BPE (Byte Pair Encoding) ou WordPiece. Ces algorithmes construisent un vocabulaire de taille fixe (typiquement 30 000 à 50 000 entrées) en fusionnant itérativement les paires de caractères les plus fréquentes. Le mot « imprévisible » pourrait être découpé en { « im », « #pré », « #visi », « #ble » }.
Cette représentation offre deux avantages : les mots hors vocabulaire peuvent être représentés à partir de leurs sous-mots et le vocabulaire reste de taille contrôlée.
BERT
BERT (Bidirectional Encoder Representations from Transformers, [DCL18]) emploie seulement la partie encodeur d’un transformer, pré-entraînée de façon bidirectionnelle sur deux tâches non supervisées :
Masked Language Model (MLM) : 15 % des tokens sont sélectionnés aléatoirement, parmi eux 80% sont masqués, 10% sont remplacés par d’autres tokens aléatoirement et 10% ne sont pas modifés ; le modèle doit prédire les tokens ainsi sélectionnés à partir du contexte gauche et droit. Cela force l’encodeur à intégrer le contexte complet de chaque token. Pour cette tâche, un réseau feed-forward de classification multi-classe est ajouté en sortie de l’encodeur et traite une à une chaque ligne de la matrice de sortie correspondant à un des 15% de tokens sélectionnés.
Next Sentence Prediction (NSP) : le modèle prédit si deux phrases se suivent dans le texte original. Cette tâche permet de capturer des relations inter-phrases. Pour cette tâche, la première phrase commence par un token particulier,
[CLS](classify), et est séparée de la seconde (concaténée en entrée à la première) par un autre token particulier,[SEP](separate). Aussi, un réseau feed-forward de classification binaire ([IsNext]ou[NotNext]) est ajouté en sortie de l’encodeur et prend comme entrée la ligne correspondant au token[CLS]de la matrice de sortie.
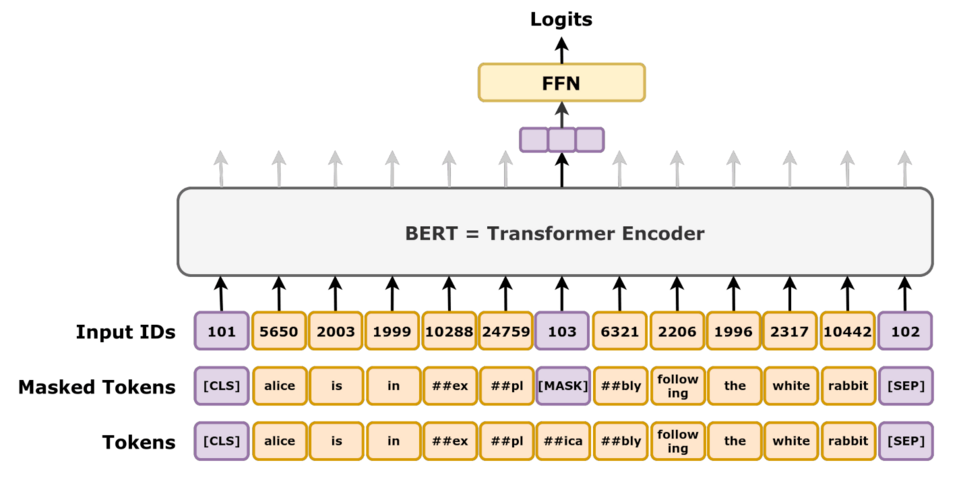
Fig. 56 Pré-entraînement BERT sur la prédiction de tokens masqués (MLM) (source de l’illustration : Daniel Voigt Godoy, CC BY 4.0 via Wikimedia Commons)
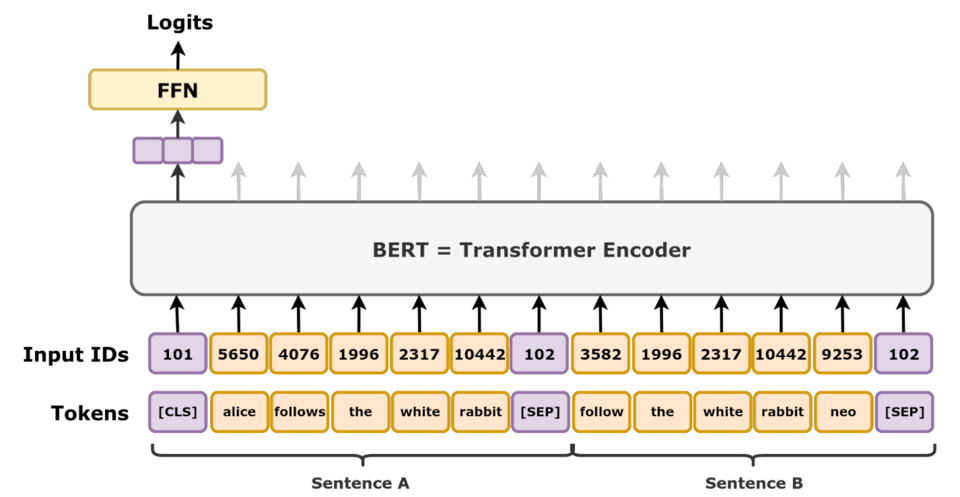
Après pré-entraînement, BERT est fine-tuned de façon supervisée sur plusieurs tâches (classification de phrase, détection d’entités nommées, question-réponse, inférence textuelle), en ajoutant à chaque fois des couches spécifiques à la tâche au-dessus des représentations produites par l’encodeur. Ce fine-tuning est beaucoup moins coûteux que le pré-entraînement et requiert des données nettement moins volumineuses, mais ces données doivent être annotées (apprentissage supervisé).
Après entraînement, les vecteurs obtenus en sortie de l’encodeur pour les tokens de la phrase présentée en entrée peuvent être employés dans différentes tâches de fouille de textes ou de prédiction à partir de textes.
Deux versions ont été proposées initialement : BERT base contient 12 blocs d’encodeur avec 12 têtes d’attention par bloc, les vecteurs sont de dimension 768 (110 millions de paramètres), alors que BERT large contient 24 blocs avec 16 têtes par bloc, la dimension des vecteurs est de 1024 (340 millions de paramètres). De nombreuses variantes ont été développées ultérieurement, les plus notables étant :
RoBERTa : BERT ré-entraîné plus longtemps, sur plus de données, sans la tâche NSP, avec des séquences plus longues, pour obtenir de meilleures performances.
DistilBERT : version distillée de BERT, avec 40 % moins de paramètres et étant 60 % plus rapide, conserve 97 % des performances ; variante utile pour réduire le coût de déploiement.
CamemBERT / FlauBERT : variantes entraînées sur des corpus français, recommandées pour le traitement du français.
Famille GPT et modèles génératifs
BERT emploie la partie encodeur du transformer, avec un pré-entraînement MLM durant lequel le contenu de la phrase est fourni à la fois pour la partie qui précède et la partie qui succède le token masqué ; cette vision globale de la phrase était supposée assurer un « débit » d’information plus élevé durant l’apprentissage. Les modèles de la famille GPT exploitent plutôt la partie décodeur du transformer (sans les blocs cross-attention car la partie encodeur est absente), avec comme tâche de pré-entraînement la modélisation autorégressive du langage (Eq. (10)), c’est à dire la prédiction du token suivant à partir de tous les précédents. Bien que très simple, sur des corpus très grands cette tâche conduit à des modèles capables de générer du texte cohérent, tenant compte d’un contexte antérieur très long, et d’accomplir ainsi des tâches variées.
A cause de cette particularité d’architecture de la famille GPT et de la nature de la tâche de pré-entraînement, les représentations contextuelles de mots obtenues par GPT prennent en compte seulement le contexte qui précède le mot visé, alors que celles obtenues par BERT prennent en compte à la fois les mots qui précèdent le mot visé et les mots qui lui succèdent dans la phrase.
Quelques éléments concernant l’évolution de la famille GPT :
GPT [RNS18] (2018) : 117 M paramètres, entraîné sur BooksCorpus (~800 M mots).
GPT-2 [RWC19] (2019) : 1,5 Md paramètres, entraîné sur WebText (~40 GB de pages Reddit filtrées). Capable de générer des textes relativement difficles à distinguer de textes écrits par un humain.
GPT-3 [BMR20] (2020) : 175 Md paramètres, entraîné sur ~570 GB de textes (CommonCrawl filtré, Wikipedia, livre). Introduit la notion d”apprentissage en contexte (in-context learning ou few-shot) : le modèle résout une tâche à partir de quelques exemples dans le prompt, sans mise à jour de ses paramètres.
GPT-4, Gemini, Claude, Llama, Mistral, etc. (2023-) : la course aux LLM s’accélère, avec des modèles propriétaires et open source qui atteignent des niveaux de performance remarquables sur des benchmarks très variés.
Adaptation aux tâches : fine-tuning et instruction tuning
Un LLM pré-entraîné sur la prédiction du token suivant n’est pas directement utilisable comme assistant. Deux étapes d’adaptation sont généralement appliquées.
Fine-tuning supervisé (SFT)
Le modèle est entraîné sur un ensemble de paires [instruction, réponse souhaitée] annotées par des humains. Cela oriente le modèle vers un comportement d’assistant plutôt que de simple générateur de texte. Le nombre de paramètres mis à jour peut être réduit par des techniques comme LoRA (Low-Rank Adaptation) qui n’ajustent que des matrices de faible rang dans les paramètres, rendant le fine-tuning accessible sans ressources GPU massives.
Apprentissage par renforcement avec retour humain (RLHF)
L’étape RLHF (Reinforcement Learning from Human Feedback) [OWJ22] permet d’aligner dans une certaine mesure le modèle sur les préférences humaines :
Des paires de réponses sont générées par le modèle et évaluées par des annotateurs humains.
Un modèle de récompense est entraîné pour prédire la préférence humaine.
Le LLM est fine-tuned par apprentissage par renforcement pour maximiser la récompense prédite.
RLHF est la technique clé qui différencie, en termes d’utilité et de sécurité, ChatGPT/GPT-4 d’un simple GPT pré-entraîné.
Embeddings de phrases et RAG
Embeddings de phrases contextuels
BERT produit directement des représentations contextuelles (tenant compre du contexte bidirectionnel) au niveau des tokens. Pour obtenir un des représentations contextuelles (embeddings) de phrase ou de document avec BERT, plusieurs stratégies existent :
Utilisation du token [CLS] : BERT ajoute un token spécial
[CLS]en début de séquence, dont la représentation finale est souvent employée comme embedding de la phrase entière (stratégie mise en œuvre pour le fine-tuning de classification).Moyenne des tokens (mean pooling) : moyenne des représentations contextuelles (BERT) des tokens de la séquence.
Sentence-BERT (SBERT) [RG19] : fine-tuning de deux encodeurs BERT siamois sur des tâches de similarité sémantique (régression sur la distance cosinus). Les embeddings résultants sont bien mieux adaptés à la recherche par similarité sémantique que les embeddings BERT bruts. SBERT est mise en œuvre pour la recherche sémantique et les systèmes de recommandation basés sur la similarité de texte.
Retrieval-Augmented Generation (RAG)
Les LLM possèdent des « connaissances » figées à leur date d’entraînement et peuvent produire des hallucinations (informations statistiquement plausibles mais inexactes). L’approche génération à enrichissement contextuel (Retrieval-Augmented Generation, RAG) pallie ces limitations en couplant un LLM à une base de connaissances externe interrogeable.
Le principe, illustré dans la figure suivante, comporte deux phases :
Indexation (hors ligne) : les documents de la base externe sont découpés en fragments (chunks), chaque fragment est encodé par un modèle de embedding (SBERT ou similaire), et les vecteurs sont stockés dans une base de données vectorielles.
Interrogation (en ligne) : la question est encodée par le même modèle, les \(k\) fragments les plus similaires sont récupérés par recherche ANN, et fournis comme contexte au LLM qui génère la réponse ancrée dans ces sources.
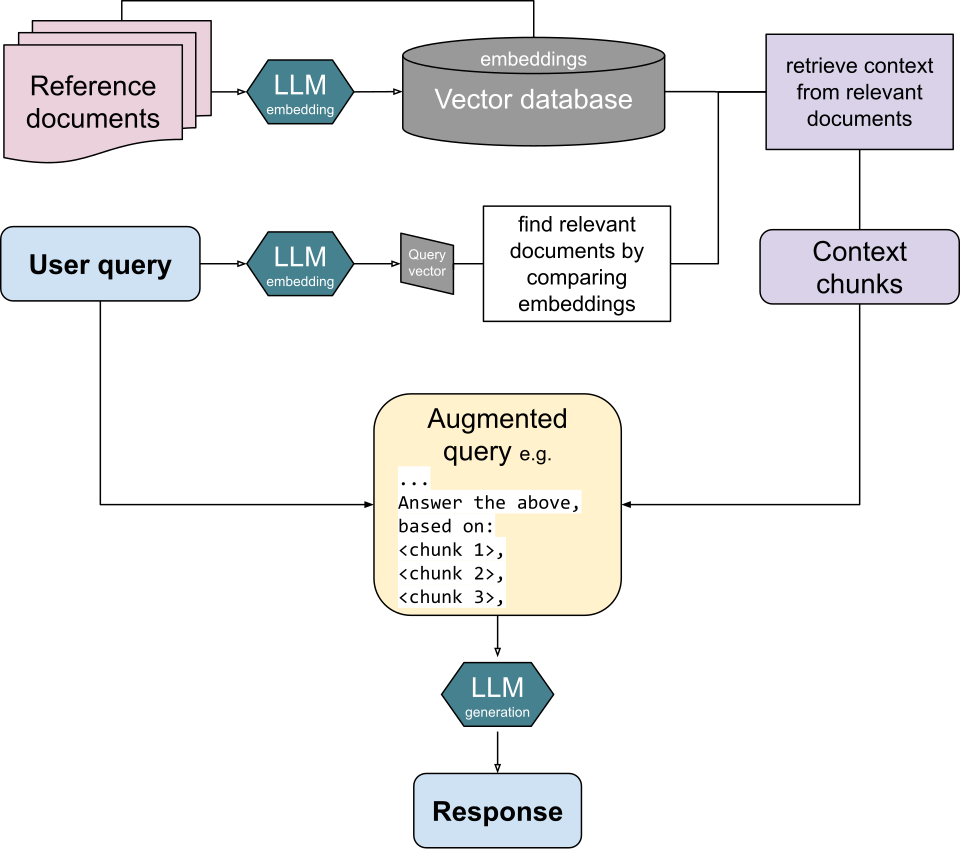
Fig. 57 Pipeline RAG : indexation hors ligne (haut) et interrogation en ligne (bas). Source de l’image : Turtlecrown, CC BY-SA 4.0, via Wikimedia Commons
La génération à enrichissement contextuel permet de doter un LLM de connaissances spécifiques (base documentaire externe ou interne à l’organisation, données récentes non vues à l’entraînement) sans réentraînement. La qualité des réponses dépend fortement de la qualité du modèle de embedding et de l’index ANN pour retrouver les fragments les plus pertinents.
Limites et enjeux éthiques
Les LLM soulèvent des questions importantes qui ne doivent pas être ignorées dans un contexte d’usage réel.
Utilisation pour l’encodage de textes :
Droit d’auteur et données d’entraînement. La légalité de l’entraînement sur des corpus web massifs est contestée dans de nombreuses juridictions. Plusieurs procès sont en cours contre des éditeurs de LLM.
Coût environnemental. L’entraînement d’un LLM consomme des quantités considérables d’énergie et d’eau (pour le refroidissement des serveurs). L’inférence à grande échelle présente également un coût environnemental non négligeable.
Biais. Les LLM reproduisent et amplifient les biais présents dans leurs données d’entraînement (biais de genre, de nationalité, de culture). Ces biais peuvent se manifester dans des tâches de recrutement automatisé, de modération de contenu ou de traduction.
Le dernier chapitre de ce cours aborde de façon plus détaillée les aspects éthiques de la fouille de données massives.
Pour la génération de texte, en plus des aspects déjà mentionnés :
Hallucinations. Les LLM produisent parfois des informations plausibles mais fausses (noms, dates, citations, faits) avec une grande assurance. Ce phénomène est inhérent au mécanisme de génération probabiliste et ne peut pas être éliminé complètement avec les méthodes connues aujourd’hui, seulement atténué (avec RAG, vérification factuelle).
Potentiel de mauvais usage. La génération de textes convaincants facilite la désinformation, le hameçonnage, la propagande à grande échelle et l’usurpation d’identité textuelle. Ces risques ont conduit certains éditeurs à restreindre l’accès aux modèles les plus puissants.
Brown, T. B., B. Mann, N. Ryder, M. Subbiah, J. Kaplan, et al. Language models are few-shot learners. Advances in Neural Information Processing Systems 33, 2020.
Conneau, A., D. Kiela, H. Schwenk, L. Barrault, and A. Bordes. Supervised learning of universal sentence representations from natural language inference data. CoRR, abs/1705.02364, 2017.
Cer, D., Y. Yang, S.-y. Kong, N. Hua, N. Limtiaco, et al. Universal sentence encoder for English. In Proc. EMNLP 2018: System Demonstrations, pp 169–174, 2018.
Devlin, J., M.-W. Chang, K. Lee, and K. Toutanova. BERT: Pre-training of deep bidirectional transformers for language understanding. In Proc. NAACL-HLT 2019, pages 4171–4186, 2019.
Ouyang, L., J. Wu, X. Jiang, D. Almeida, et al. Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems 35, 2022.
Peters, M. E., M. Neumann, M. Iyyer, M. Gardner, C. Clark, K. Lee, and L. Zettlemoyer. Deep contextualized word representations. In Proc. NAACL, 2018.
Pennington, J., R. Socher, and C. D. Manning. GloVe: Global vectors for word representation. In EMNLP, pages 1532–1543, 2014.
Reimers, N. and I. Gurevych. Sentence-BERT: Sentence embeddings using siamese BERT-networks. CoRR, abs/1908.10084, 2019.
Radford, A., K. Narasimhan, T. Salimans, and I. Sutskever. Improving language understanding by generative pre-training. OpenAI, 2018.
Radford, A., J. Wu, R. Child, D. Luan, D. Amodei, and I. Sutskever. Language models are unsupervised multitask learners. OpenAI blog, 1(8):9, 2019.