Cours - Aspects éthiques dans la fouille de données (1/2)
Supports complémentaires :
[Diapositives du cours : 2 par page] [Diapositives du cours : 1 par page]
Ce chapitre a pour objectif de sensibiliser les personnes qui suivent ce cours aux aspects éthiques des activités de fouille de données. Dans cette première séance nous présentons la problématique générale, les formes que peut prendre l’absence d’équité et les critères qui permettent de la caractériser quantitativement. La seconde séance est consacrée à la typologie et aux sources des biais, aux méthodes de détection de l’iniquité et aux méthodes de correction.
Dans la séance de travaux pratiques associée des métriques d’équité sont évaluées pour différents modèles obtenus sur des données réelles.
Pourquoi l’éthique ?
En préambule il est utile de rappeler quelques définitions importantes :
Éthique : « Science qui traite des principes régulateurs de l’action et de la conduite morale. » (déf. CNRTL)
Moral : « Qui concerne les règles ou principes de conduite, la recherche d’un bien idéal, individuel ou collectif, dans une société donnée. » (déf. CNRTL)
Équité : « (Principe impliquant l”) appréciation juste, (le) respect absolu de ce qui est dû à chacun. » (déf. CNRTL)
Discrimination : « Traitement différencié, inégalitaire, appliqué à des personnes sur la base de critères variables. » (déf. CNRTL, voir aussi [MMSLG19], [Neil16])
Loyauté : « Fidélité manifestée par la conduite aux engagements pris, au respect des règles de l’honneur et de la probité. » (déf. CNRTL)
Dans toute activité humaine il est important de s’intéresser aux principes régulateurs de l’action et de la conduite morale. Cette préoccupation n’est-elle pas toujours suffisante dans le domaine de la construction et de l’utilisation de modèles prédictifs à partir de données ? Plusieurs travers (en anglais, souvent appelés bias) sont régulièrement constatés. En voici quelques-uns :
COMPAS (Correctional Offender Management Profiling for Alternative Sanctions) est utilisé aux États-Unis par des juges pour évaluer le risque de récidive et prendre des décisions de libération conditionnelle. Une étude a trouvé que l’outil défavorise les afro-américains par rapport aux caucasiens de profil similaire.
Pour un algorithme qui affiche des annonces d’emploi en sciences, technologie, ingénierie et mathématiques, conçu pour ignorer le genre de la personne qui regarde, une étude a trouvé que les publicités étaient montrées plus rarement aux femmes qu’aux hommes… pour une raison de coût, le public féminin étant une cible publicitaire plus chère que le public masculin.
Un établissement bancaire emploie un outil d’aide à la décision pour accorder ou refuser un crédit. Cet outil exclut toute variable interdite mais exploite un grand nombre d’autres variables. Parmi celles-ci, le code postal (entre autres) qui est très corrélé à la « race » [1] et assez corrélé à la religion.
Une société qui a mis en place un réseau social exploite les informations gratuitement fournies par ses utilisateurs, ainsi que leurs échanges sur le réseau, pour optimiser la vente d’espaces publicitaires. Elle vend également à des tiers des informations concernant ses utilisateurs. En situation de quasi-monopole, cette société peut maximiser ses gains tout en offrant un service basique à la grande majorité des utilisateurs.
Une société de vente de services en ligne adapte au client la tarification de son offre avec pour seul objectif la maximisation de ses bénéfices. Pour cela, elle utilise des données collectées gratuitement auprès de ses clients, ainsi que des données achetées à des data brokers.
Un utilisateur s’informe grâce à un média en ligne. Le site choisit les messages proposés à chaque utilisateur de façon à maximiser le temps de consultation (et donc ses recettes publicitaires), ce qui passe par la maximisation de l’adhésion (et non de la diversité, ni de la véracité). En conséquence, l’utilisateur peut évoluer vers un état d’aliénation dans lequel il perçoit la réalité de façon très déformée.
Un réseau social vend des informations sensibles concernant les utilisateurs (ainsi que les non utilisateurs mentionnés dans les posts des utilisateurs !) à des employeurs actuels ou potentiels, sans que cela soit explicitement mentionné dans les conditions d’utilisation du réseau. Cela a des conséquences sur l’emploi et/ou sur les demandes d’emploi de ces personnes.
Un comparateur de produits et de services modifie l’ordre de présentation des résultats pour privilégier les fournisseurs avec lesquels il a des liens capitalistiques ou, plus largement, des liens d’affaires, sans l’indiquer clairement.
Comment pouvons-nous catégoriser ces travers ? Les points 1, 2 et 3 mettent en évidence des discriminations (absence d’équité). Dans les points 4 et 5 on constate une absence d’équité dans le partage des « gains » entre l’utilisateur d’un service et le fournisseur du service. Enfin, les points 6, 7 et 8 mettent en évidence une absence de « loyauté » (respect de ce qui est explicitement ou implicitement promis) dans la relation entre l’utilisateur et le fournisseur.
A la lecture de cette liste, chacun peut facilement constater que tous ces travers ne semblent pas être d’une gravité équivalente. L’absence de sensibilisation et la banalisation jouent un rôle important dans notre perception de la gravité.
Principaux sujets de préoccupation
Pourquoi faut-il s’intéresser à ces problèmes ? Un aspect important est le fait que la législation intègre déjà un certain nombre de règles qui visent à les éviter ou à les résoudre.
Au-delà de la réglementation en vigueur, la préoccupation morale pour les moyens et les finalités d’une action est naturelle. La prise de conscience se manifeste d’abord comme une préoccupation morale, avant d’inspirer éventuellement une évolution de la réglementation. Si la morale n’a pas un caractère universel et immuable, il y a néanmoins des droits fondamentaux reconnus par l’ONU dans la Déclaration universelle des droits de l’homme.
La Déclaration universelle des droits de l’homme (ONU, 10/12/1948) prévoit notamment :
« Chacun peut se prévaloir de tous les droits et de toutes les libertés proclamés dans la présente Déclaration, sans distinction aucune, notamment de race, de couleur, de sexe, de langue, de religion, d’opinion politique ou de toute autre opinion, d’origine nationale ou sociale, de fortune, de naissance ou de toute autre situation. »
La Charte des droits fondamentaux de l’UE (art. 21) interdit « toute discrimination fondée notamment sur le sexe, la race, la couleur, les origines ethniques ou sociales, les caractéristiques génétiques, la langue, la religion ou les convictions, les opinions politiques ou toute autre opinion, l’appartenance à une minorité nationale, la fortune, la naissance, un handicap, l’âge ou l’orientation sexuelle ».
Aux États-Unis, la réglementation distingue le disparate treatment (utilisation intentionnelle d’une variable protégée) et le disparate impact (inéquité produite indirectement, notamment via des variables proxy). Pour éviter le disparate treatment, des listes de variables protégées sont imposées dans plusieurs domaines. La Fig. 113 liste les variables protégées par le Fair Housing Act (FHA) et l”Equal Credit Opportunity Act (ECOA).
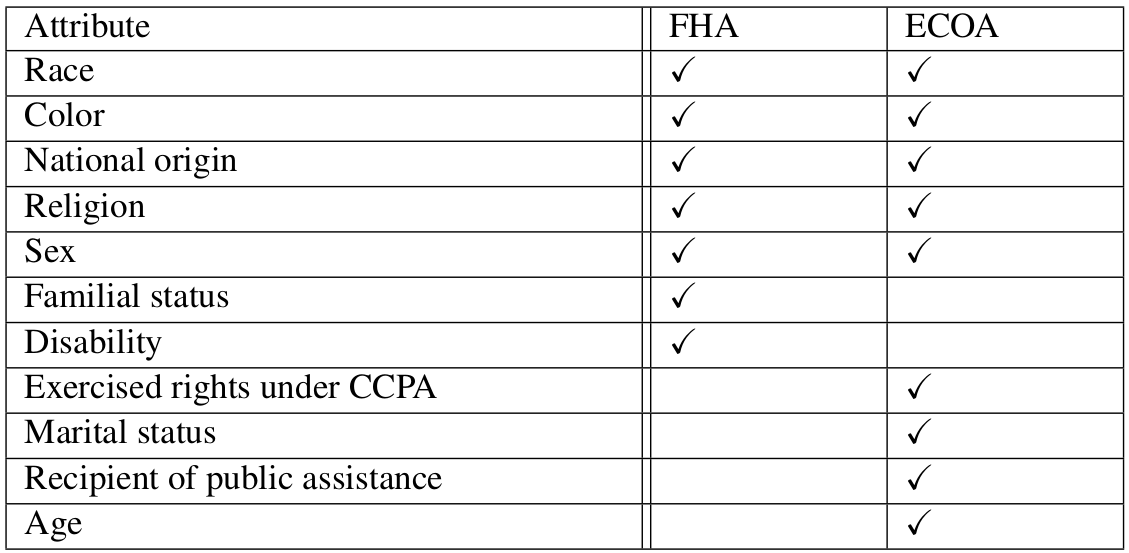
Fig. 113 Variables protégées par Fair Housing Act (FHA) et Equal Credit Opportunity Act (ECOA)
Nature des problèmes constatés
Différentes références (comme [BHN18]) proposent la classification suivante des problèmes éthiques liés à l’exploitation des données :
Absence d’équité (ou présence de discrimination) dans la prise de décision : partialité ou favoritisme envers un individu ou un groupe sur la base de caractéristiques inhérentes ou acquises. C’est le principal sujet d’étude concernant l’exploitation des données pour la prise de décision et le thème central de ces deux séances. La notion d’équité peut s’exprimer de multiples façons et certaines définitions peuvent être incompatibles entre elles (voir plus loin).
Absence d’équité dans le partage des gains issus de l’exploitation des données. La prise de conscience est en cours, mais la réglementation est encore peu avancée sur ce point.
Absence de loyauté : non respect du « contrat », explicite ou implicite, établi par un service avec ses utilisateurs. La réglementation est en évolution : le RGPD impose une explicitation du contrat dans l’utilisation des données personnelles.
Autres problèmes concernent la prise de décision automatique (voir [CERNA]) : conduite autonome, armement autonome, etc.
Dans la suite nous nous intéressons à l’évaluation et au renforcement de l’équité dans la prise de décision. Au-delà de la seule fouille de données, la lecture de [Poi25] (chapitre 7, PDF libre en ligne) donne une perspective plus large concernant l’impact social de l’intelligence artificielle.
Biais et discrimination
Le sujet le plus abordé dans les travaux de recherche et dans la réglementation actuelle est la recherche d’équité, entendue comme absence de discrimination.
Historiquement, la préoccupation pour la non discrimination s’est manifestée à travers deux notions :
L”équité individuelle, qui vise à décider de façon similaire pour des individus qui sont similaires par rapport à l’objectif considéré.
L”équité de groupe, qui vise à une forme de parité statistique entre les décisions concernant les différents groupes (définis par les différentes valeurs des attributs protégés [2] : sexe, « race », etc.). Les critères examinés dans la section suivante permettent de mieux appréhender la multiplicité des expressions de la notion de parité statistique.
Il est très important de comprendre que des conflits peuvent apparaître dans la mise en œuvre de ces deux notions. Considérons, par exemple, l’emploi d’un outil automatique d’analyse de CV qui sélectionne les candidat·e·s pour des entretiens d’embauche. Supposons que l’employeur constate qu’un groupe protégé [3] est désavantagé par l’outil et décide alors d’équilibrer les taux de sélection pour assurer l’équité de groupe. En conséquence, un·e candidat·e d’un groupe non protégé peut contester sa non-sélection, montrant que des candidat·e·s du groupe protégé ayant les mêmes qualifications ont pourtant été sélectionné·e·s (et n’ont donc pas été traité·e·s de façon similaire, l’équité individuelle n’a ainsi pas été respectée).
Critères observationnels
Nous pouvons maintenant examiner plusieurs critères qui permettent de caractériser quantitativement la notion d’équité. Introduisons d’abord quelques notations et des exemples illustratifs.
Notations :
\(X\) : variables explicatives disponibles pour la prise de décision ;
\(A\) : variable(s) représentant explicitement les attributs protégés ; on considère que \(A = a\) correspond au groupe « favorisé » et \(A = b\) au groupe « défavorisé » ;
\(Y\) : variable expliquée (ou cible) ;
\(R\) : score (variable quantitative) employé dans la prise de décision, ou directement la décision (variable binaire).
Pour mieux comprendre ces critères, considérons trois situations où un outil prédictif aide à la prise de décision :
Accord de prêt : \(Y\) correspond au remboursement du prêt (\(Y=1\) pour prêt remboursé, \(Y=0\) pour prêt non remboursé), \(R\) correspond au score (si continu) ou à la décision (accorder ou non le prêt) si binaire (\(R=1\) pour accordé, \(R=0\) pour non accordé). On comprend que si \(R=0\) (le prêt n’est pas accordé) alors \(Y\) restera inconnu. Donc, pour construire le modèle comme pour l’évaluer, il faut accepter toutes les candidatures.
Embauche (éventuellement en période d’essai) : \(Y=1\) si l’employé donne satisfaction, \(Y=0\) sinon. R correspond au score (si continu) ou à la décision (embaucher ou non) si binaire (\(R=1\) pour embauché, \(R=0\) pour non embauché). On comprend que si \(R=0\) (la personne n’est pas embauchée) alors \(Y\) restera inconnu. Donc, pour construire le modèle comme pour l’évaluer, il faut accepter toutes les candidatures.
Libération conditionnelle : \(Y\) correspond à la récidive (\(Y=0\) pour récidive, \(Y=1\) pour non récidive), \(R\) correspond au score (si continu) ou à la décision (libérer ou non) si binaire (\(R=1\) pour libéré, \(R=0\) pour non libéré). On comprend que si \(R=0\) (le détenu n’est pas libéré) alors \(Y\) restera inconnu. Donc, pour construire le modèle comme pour l’évaluer, il faut accepter toutes les candidatures.
Il est important de constater que, dans tous ces exemples, il est très peu probable d’obtenir \(Y \perp\kern-5pt\perp A\), c’est à dire \(P(Y=1|A=a) = P(Y=1|A=b)\). L’absence d’indépendance entre la variable cible et les attributs protégés est le cas habituel dans les données réelles, et cela a des conséquences directes sur la possibilité de respecter les critères d’équité, comme nous le verrons.
Trois critères considérés représentatifs (voir par ex. [BHN18]) pour caractériser quantitativement la notion d’équité sont :
Indépendance ou parité démographique (demographic parity) : \(R \perp\kern-5pt\perp A\). Le score est indépendant des attributs protégés. Pour \(R\) binaire : même taux d’acceptation dans tous les groupes.
Séparation (equalized odds) : \(R \perp\kern-5pt\perp A \,\, | \, Y\). Le score et les attributs protégés sont indépendants conditionnellement [4] à la variable cible. Pour \(R\) et \(Y\) binaires : même taux de faux positifs et de vrais positifs dans tous les groupes.
Suffisance : \(Y \perp\kern-5pt\perp A \,\, | \, R\). La cible et les attributs protégés sont indépendants conditionnellement au score. Pour \(R\) et \(Y\) binaires : mêmes valeurs prédictives positive et négative dans tous les groupes.
Le tableau suivant présente une matrice de confusion (la variable \(R\) est binaire) avec les définitions associées.
Positifs (P : \(Y=1\)) |
Négatifs (N : \(Y=0\)) |
||
|---|---|---|---|
Prédits positifs (PP : \(R=1\)) |
Vrais positifs (VP) |
Faux positifs (FP) |
Valeur prédictive positive = \(\frac{VP}{PP}\) |
Prédits négatifs (PN : \(R=0\)) |
Faux négatifs (FN) |
Vrais négatifs (VN) |
Valeur prédictive négative = \(\frac{VN}{PN}\) |
Taux faux négatifs TFN = \(\frac{FN}{P}\) (TFN = 1 − TVP) |
Taux faux positifs TFP = \(\frac{FP}{N}\) (TFP = 1 − TVN) |
Critère d’indépendance
Le critère d’indépendance (ou de parité démographique) peut s’exprimer par :
Dans le cas général : information mutuelle nulle entre \(R\) et \(A\), ou \(I(A;R)=0\).
Pour \(R\) binaire : \(P(R=1|A=a) = P(R=1|A=b)\).
Ses déclinaisons concrètes sur les trois exemples :
La proportion de candidats auxquels le prêt est accordé est la même dans le groupe favorisé et dans le groupe défavorisé.
La proportion de candidats embauchés est la même dans les deux groupes.
La proportion de détenus libérés conditionnellement est la même dans les deux groupes.
Insuffisances. Ce critère présente des limites importantes. Premièrement, si \(Y\) et \(A\) ne sont pas indépendants (ce qui est le cas habituel), alors le score « parfait » \(R = Y\) ne peut pas satisfaire le critère d’indépendance : respecter ce critère implique nécessairement de s’écarter du prédicteur optimal. Deuxièmement, respecter le critère d’indépendance ne suffit pas à garantir l’absence de discrimination. Par exemple, on peut s’assurer d’un taux d’acceptation identique dans les deux groupes tout en appliquant une sélection rigoureuse (sur la base du score) dans le groupe favorisé et un choix aléatoire dans le groupe défavorisé. Les membres acceptés du groupe défavorisé obtiendront vraisemblablement de moins bons résultats en moyenne, ce qui peut être utilisé a posteriori pour justifier un traitement différencié.
Si le critère d’indépendance ne peut pas être parfaitement satisfait, on peut chercher à satisfaire une version relaxée. Par exemple, avec \(\epsilon > 0\) mais petit :
Écart de disparité faible : \(P(R=1|A=b) \geq P(R=1|A=a)-\epsilon\).
Ratio de disparité démographique proche de 1 : \(\frac{P(R=1|A=b)}{P(R=1|A=a)} \geq 1-\epsilon\).
Information mutuelle faible : \(I(A;R) \leq \epsilon\).
Critère de séparation
Le terme « séparation » dans le nom de ce critère vient du fait que dans le modèle graphique associé \(Y\) sépare \(R\) de \(A\). L’intuition est que l’absence d’indépendance entre \(R\) et \(A\) peut être acceptable lorsque \(Y\) et \(A\) ne sont pas indépendants, mais pas au-delà de ce qui est justifié par la cible \(Y\).
Pour \(R\) et \(Y\) binaires, le critère de séparation ou égalisation des chances (equalized odds) s’exprime :
\(P(R=1|Y=1,A=a) = P(R=1|Y=1,A=b)\) (même taux de vrais positifs), et
\(P(R=1|Y=0,A=a) = P(R=1|Y=0,A=b)\) (même taux de faux positifs).
Déclinaisons sur les trois exemples :
Parmi ceux qui rembourseront le prêt, le taux d’accord de prêt est la même dans les deux groupes (même taux de « perte de chance »). Et parmi ceux qui ne rembourseront pas, même taux d’accord de prêt (mêmes erreurs de type 1).
Parmi ceux qui donneront satisfaction, même taux d’embauche dans les deux groupes ; et parmi ceux qui ne donneront pas satisfaction, même taux d’embauche.
Parmi ceux qui ne récidiveront pas, même taux de libération dans les deux groupes ; et parmi ceux qui récidiveront, même taux de libération.
Difficulté d’application. Pour évaluer ce critère, il faut avoir accès à la valeur de \(Y\) or, lorsque la règle de sélection est appliquée, cela n’est possible que si \(R=1\).
Ce critère peut également être relaxé :
Contrainte uniquement sur le taux de faux négatifs quand « positif » signifie opportunité (ex. embauche) : les faux négatifs sont les opportunités non accordées.
Contrainte uniquement sur le taux de faux positifs quand « positif » signifie pénalité (ex. maintien en prison) : les faux positifs sont les pénalités injustifiées.
Seuil \(> 0\) sur l’écart entre le taux considéré pour \(A=a\) et celui pour \(A=b\).
Critère de « suffisance »
Pour le critère de suffisance, dans le modèle graphique associé \(R\) sépare \(Y\) de \(A\). La signification est que la valeur prédictive ne doit pas dépendre du groupe. Pour \(R\) et \(Y\) binaires :
\(P(Y=1|R=1,A=a) = P(Y=1|R=1,A=b)\) : même valeur prédictive positive, et
\(P(Y=0|R=0,A=a) = P(Y=0|R=0,A=b)\) : même valeur prédictive négative.
Déclinaisons sur les trois exemples :
Parmi ceux à qui le prêt a été accordé, la même proportion le remboursera dans les deux groupes (le score \(R\) est également prédictif de la cible \(Y\) dans les deux groupes).
Parmi ceux qui ont été embauchés, la même proportion donnera satisfaction dans les deux groupes.
Parmi ceux qui ont été libérés, la même proportion ne récidivera pas dans les deux groupes.
Lien avec la calibration. Le score \(R\) est calibré si, pour toute valeur \(r\) que peut prendre \(R\), \(P(Y=1|R=r) = r\), c’est à dire que parmi les observations de score \(r\), une fraction égale à \(r\) sont positives (\(Y=1\)). Par calibration par groupe on entend cette condition satisfaite séparément pour chaque valeur de \(A\). La calibration par groupe implique la suffisance ; la suffisance implique la calibration par groupe à une transformation monotone du score près.
Comme pour le critère de séparation, l’évaluation de ce critère exige un accès à \(Y\) or, lorsque la règle de sélection est appliquée, cela est possible seulement si \(R=1\).
Relations entre les trois critères
Les relations d’incompatibilité suivantes sont valables dans le cas habituel où \(A\) et \(Y\) ne sont pas indépendants (c’est-à-dire le taux de positifs \(Y=1\) est différent entre les groupes) :
Indépendance ↔ Séparation : si \(A \not\!\perp\!\!\!\perp Y\) et \(Y\) est binaire, alors \(R \perp\kern-5pt\perp A\) et \(R \perp\kern-5pt\perp A \,\, | \, Y\) ne peuvent pas être satisfaites simultanément.
Indépendance ↔ Suffisance : si \(A \not\!\perp\!\!\!\perp Y\), alors \(R \perp\kern-5pt\perp A\) et \(Y \perp\kern-5pt\perp A \,\, | \, R\) ne peuvent pas être satisfaites simultanément.
Séparation ↔ Suffisance : si \(A \not\!\perp\!\!\!\perp Y\) et toutes les probabilités jointes \((A,R,Y)\) sont positives, alors \(R \perp\kern-5pt\perp A \,\, | \, Y\) et \(Y \perp\kern-5pt\perp A \,\, | \, R\) ne peuvent pas être satisfaites simultanément.
Nous pouvons donc constater que, dans les conditions courantes (\(A\) et \(Y\) ne sont pas indépendantes), plusieurs critères ne peuvent pas être satisfaits simultanément de façon stricte. Il est en revanche envisageable de rechercher des compromis grâce aux relaxations mentionnées pour chacun des trois critères. Par ailleurs, le choix du critère d’équité à respecter (ou à privilégier dans le compromis entre plusieurs critères) doit être guidé par la nature de l’application et les types d’erreurs jugés les plus préjudiciables.
Solon Barocas, Moritz Hardt, and Arvind Narayanan. Fairness and Machine Learning Limitations and Opportunities. 2018.
CERNA Collectif. Research Ethics in Machine Learning. Technical report.
Ninareh Mehrabi, Fred Morstatter, Nripsuta Saxena, Kristina Lerman, and Aram Galstyan. A survey on bias and fairness in machine learning, 2019.
Cathy O’Neil. Weapons of Math Destruction: How Big Data Increases Inequality and Threatens Democracy. Crown Publishing Group, USA, 2016.
Poibeau, T. 2025. Understanding Conversational AI: Philosophy, Ethics and Social Impact of Large Language Models. Pp. 149–175. London: Ubiquity Press.