Ce chapitre aborde le passage à l’échelle de la recherche par similarité. Après la définition des différents types de recherche par similarité, nous listons les principales applications et examinons le principe de la réduction de complexité, ainsi le problème posé par la malédiction de la dimension. Nous présentons enfin différentes méthodes qui permettent de réduire de façon significative la complexité de la recherche par similarité à large échelle.
La recherche par similarité vise à trouver, à partir d’une donnée requête, les données les plus similaires présentes dans une base de données. Les mesures de similarité employées dépendent de la nature des données. Lorsque les données sont des vecteurs, la similarité est en général définie à partir d’une métrique (mesure de distance) vectorielle ; noter que la similarité diminue lorsque la distance augmente.
Pour des données vectorielles, les types de recherche en général employés peuvent être définis de la façon suivante (\(\mathbf{q}\) est la requête à laquelle il faut trouver, dans une base \(\mathcal{D}\), des données similaires) :
La recherche par intervalle (range query) :
\(Range_r(\mathbf{q}) = \{\mathbf{x} \in \mathcal{D} | \forall i, \left|x_i - q_i\right| \leq r_i\}\)
La recherche dans un rayon (sphere query) :
\(Sphere_{\epsilon}(\mathbf{q}) = \{\mathbf{x} \in \mathcal{D} | d(\mathbf{x},\mathbf{q}) \leq \epsilon\}\)
La recherche des k plus proches voisins (kppv, kNN) :
\(kNN(\mathbf{q}) = \{\mathbf{x} \in \mathcal{D} | \left|kNN(\mathbf{q})\right| = k \wedge \forall \mathbf{y} \in \mathcal{D}-kNN(\mathbf{q}), d(\mathbf{y},\mathbf{q}) > d(\mathbf{x},\mathbf{q})\}\)
On peut facilement constater qu’une recherche exhaustive aurait une complexité \(O(N)\) (linéaire en \(N\)), \(N\) étant le nombre de données de \(\mathcal{D}\).
La recherche par similarité est l’opération centrale de nombreuses applications :
Systèmes de recommandation : retrouver des articles, films ou produits similaires à un profil utilisateur.
Déduplication et détection de quasi-copies à grande échelle.
Recherche sémantique : retrouver des documents similaires à une requête en langage naturel, indépendamment des mots exacts employés.
Systèmes RAG (Retrieval-Augmented Generation) : augmenter un modèle de langage (voir le chapitre correspondant de ce cours) avec des connaissances externes en lui fournissant les documents les plus pertinents issus d’une base documentaire.
Par ailleurs, une recherche par similarité efficace peut être très utile pour réduire le coût d’opérations de construction de modèles prédictifs et de prédiction avec ces modèles. En effet, la position d’une frontière de décision dépend localement surtout des données d’apprentissage les plus proches ; aussi, la prédiction pour une nouvelle donnée dépend principalement (parfois exclusivement) des données étiquetées les plus proches.
Réduction de la complexité de la recherche par similarité
Le principe général de la réduction de l’ordre de complexité grâce à la similarité est de regrouper au préalable les données par similarité et de focaliser progressivement la recherche, en évitant le plus possible les opérations impliquant des données issues de groupes éloignés. Des structures de données particulières, les index multidimensionnels ou métriques, permettent de mettre en œuvre ces regroupements et de sélectionner efficacement, pour chaque donnée (déjà présente dans la base ou nouvelle) vue comme « requête », les données suffisamment similaires pour intervenir dans les calculs.
Pour que cette approche générale soit valide, deux hypothèses importantes doivent être satisfaites :
Très peu de données sont similaires à la requête. En effet, la complexité de la recherche ne peut pas être inférieure à la taille du résultat obtenu. Si une partie importante des données doit se retrouver dans le résultat, la complexité ne peut pas être réduite.
Les données similaires à la requêtes sont bien plus similaires que les autres. Les méthodes sont basées sur l’élimination, à un coût aussi faible que possible, d’un maximum de données éloignées de la requête. Cela sera d’autant plus facile que les différences de proximité entre les données sont fortes. Cette hypothèse conditionne donc l’efficacité de la méthode de réduction de complexité.
La plupart des structures d’index ont été conçues pour la recherche « exacte » : toutes les données qui satisfont la condition de similarité sont retournées dans les résultats et tous les résultats satisfont la condition de similarité. Certaines méthodes peuvent être modifiées pour faire plutôt une recherche « approximative », plus efficace que la recherche exacte et satisfaisante dans de nombreux cas. D’autres méthodes ont été conçues dès le départ pour la recherche approximative et n’ont pas de variante « exacte ». En anglais on emploie pour ces méthodes l’expression générale Approximate Nearest Neighbors (ANN), ou « plus proches voisins approximatifs ».
Nous avons choisi de présenter de façon assez détaillée le hachage sensible à la similarité car, suivant les fonctions de hachage employées, il peut s’appliquer à différents types de données et est par ailleurs (partiellement) implémenté dans Spark.
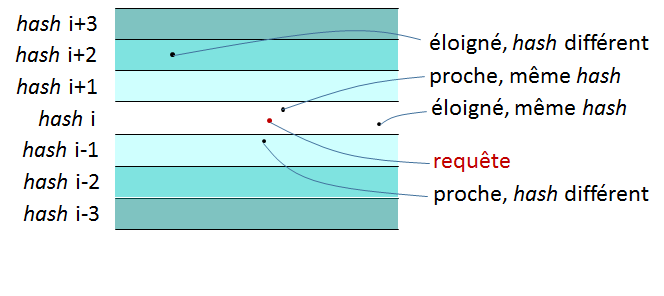
Le hachage classique associe à chaque donnée \(v \in \mathcal{D}\) une valeur entière (hash) qui identifie une page mémoire où est stockée cette donnée. Les fonctions de hachage classiques cherchent à disperser uniformément les données afin de’uniformiser le remplissage des différentes pages, ce qui implique que deux données très similaires peuvent avoir des hash très différents. Cette propriété est souhaitable pour les recherches par identité (complexité \(O(1)\)), d’ailleurs ce hachage est largement employé dans les bases de données relationnelles, mais rend le hachage classique inadapté à la recherche par similarité.
Le hachage sensible à la similarité (Locality-Sensitive Hashing, LSH) [GIM99] est une adaptation du hachage à la recherche par similarité. Il repose sur le principe inverse : deux données proches doivent avoir une forte probabilité d’obtenir le même hash, tandis que deux données éloignées doivent avoir une forte probabilité d’obtenir des hash différents.
Définition de LSH :
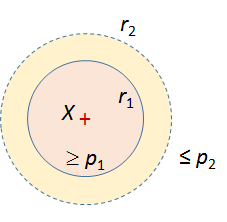
Soit \(\mathcal{D}\) un domaine doté d’une métrique \(d_\mathcal{H}\) et \(\mathcal{Q}\) un ensemble de hash. \(\mathcal{H}=\{h:\mathcal{D} \rightarrow \mathcal{Q}\}\) est un ensemble de fonctions de hachage\((r_1, r_2, p_1, p_2)\)-sensibles (avec \(r_2 > r_1 > 0\), \(p_1 > p_2 > 0\)) si :
Autrement dit, la probabilité de collision est élevée (\(\geq p_1\)) entre données proches (distance \(\leq r_1\)) et faible (\(\leq p_2\)) entre données éloignées (distance \(> r_2\)).
Pour la recherche par similarité, LSH est employé de la façon suivante :
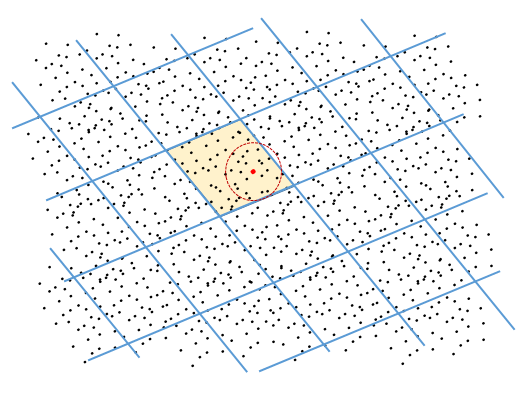
En amont (avant toute requête) : calculer le hash de chaque donnée de la base et stocker les données de même hash dans une même page (ou bucket) ; utiliser des pages de débordement si nécessaire.
Pour chaque requête\(\mathbf{q}\) : calculer \(h(\mathbf{q})\), lire la page correspondante et retourner toutes les données de cette page (éventuellement après filtrage par calcul de distances).
La complexité de la recherche est \(O(1)\) par requête.
Fig. 27 Données bidimensionnelles, fonction de hachage et requête
Les résultats obtenus avec LSH sont une approximation des résultats d’une recherche exhaustive : des données proches de la requête mais se trouvant dans une page voisine ne sont pas retournées (« faux négatifs »), alors que des données de la même page mais éloignées de la requête peuvent l’être (« faux positifs »). En effet, comme l’indique la définition de LSH, les garanties sont probabilistes.
Les fonctions LSH sont définies en fonction de la métrique employée.
LSH pour la métrique euclidienne. Pour \(\mathcal{D} \subset \mathbb{R}^m\) avec la métrique \(L_2\), une famille de fonctions \((r_1, r_2, p_1, p_2)\)-sensibles est :
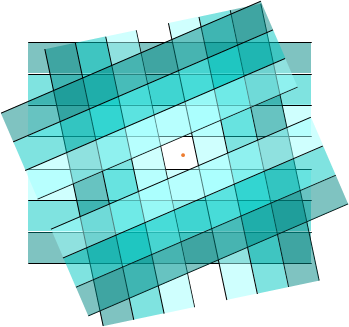
avec \(\mathbf{a} \in \mathbb{R}^m\) de composantes tirées indépendamment suivant \(\mathcal{N}(0,1)\), \(b\) tiré selon la loi uniforme dans \([0, 1)\) et \(w \in \mathbb{R}^+\). Géométriquement, chaque fonction élémentaire correspond à une famille de droites (hyperplans) parallèles qui découpent l’espace en bandes de largeur \(w\).
Fig. 28 Fonction LSH élémentaire dans \(\mathbb{R}^2\)
LSH pour la distance cosinus. Pour deux vecteurs \(\mathbf{x}, \mathbf{y} \in \mathcal{D} \subset \mathbb{R}^m\), la distance cosinus est \(d_{\cos}(\mathbf{x}, \mathbf{y}) = \arccos \frac{\mathbf{x}^T \cdot \mathbf{y}}{\left\|\mathbf{x}\right\| \cdot \left\|\mathbf{y}\right\|}\), c’est à dire l’angle (mesuré en degrés ou en radians) entre les deux vecteurs \(\mathbf{x}, \mathbf{y}\). Considérons maintenant les fonctions de hachage élémentaires \(h \in \mathcal{H}_{\cos}\), \(h:\mathbb{R}^m \rightarrow \{0, 1\}\) définies par
avec \(\mathbf{v} \in \mathbb{R}^m\) tiré suivant la loi uniforme sur l’hypersphère unité (\(\|\mathbf{v}\| = 1\)). L’ensemble \(\mathcal{H}_{\cos}\) est un ensemble de fonctions de hachage \((r_1, r_2, 1-\frac{r_1}{180}, 1-\frac{r_2}{180})\)-sensibles (les angles et les distances cosinus entre vecteurs, donc \(r_1, r_2\) également, sont ici mesurés en degrés). Une telle fonction élémentaire associe une valeur de hash égale à 0 aux données situées d’un côté de l’hyperplan de vecteur normal \(\mathbf{v}\) (et passant par l’origine des axes) et à 1 aux données situées de l’autre côté.
LSH pour la similarité de Jaccard (MinHash). Dans de nombreux cas, les données (observations) sont des sous-ensembles d’un grand ensemble fini. Par exemple, un texte est un sous-ensemble de l’ensemble des mots d’une langue. Le profil d’achat d’un client est un sous-ensemble de l’ensemble des articles disponibles (dans le présent et le passé). Parfois, les ensembles sont représentés à travers leurs fonctions caractéristiques et comparés grâce à la distance de Hamming (voir ci-dessus). Dans d’autres cas, les occurrences des éléments sont pondérées et les comparaisons font appel à la distance cosinus (nous y reviendrons dans le chapitre suivant). Souvent, les (sous-)ensembles sont comparés directement grâce à l’indice (ou la similarité) de Jaccard.
Considérons un ensemble total \(\mathcal{E}\), le domaine qui nous intéresse est \(\mathcal{D} = \mathcal{P}(\mathcal{E})\), l’ensemble des parties de \(\mathcal{E}\). L’indice de Jaccard entre deux sous-ensembles quelconques \(\mathcal{A},\mathcal{B} \in \mathcal{P}(\mathcal{E})\) est
c’est à dire le rapport entre le nombre d’éléments communs entre \(\mathcal{A}\) et \(\mathcal{B}\) et le nombre d’éléments de leur réunion. Cet indice varie entre 0 (aucun élément commun) et 1 (\(\mathcal{A} = \mathcal{B}\)). On note que \(d_J(\mathcal{A},\mathcal{B}) = 1 - s_J(\mathcal{A},\mathcal{B})\) est une métrique sur \(\mathcal{P}(\mathcal{E})\).
Des fonctions LSH adaptées aux ensembles peuvent être définies sur la base de cet indice de Jaccard. On fixe un ordre des éléments de \(\mathcal{E}\) et on note par \(\pi\) une permutation des éléments de \(\mathcal{E}\). La figure suivante montre un exemple de permutation pour un ensemble dont les éléments sont notés par \(a, b, c, d\ldots\) :
\[\begin{split}\pi = \Big(\begin{array}{ccccc}a & b & c & d & \ldots\\c & d & a & b & \ldots\end{array}\Big)\end{split}\]
Les fonctions de hachage élémentaires \(h_{\pi} : \mathcal{P}(\mathcal{E}) \rightarrow \mathcal{E}\), \(h_{\pi}(\mathcal{A}) = \min \pi(\mathcal{A})\), forment une famille de fonctions \((r_1, r_2, p_1, p_2)\)-sensibles. Nous avons noté par \(\min \pi(\mathcal{A})\) l’élément de \(\mathcal{A}\) qui se retrouve premier après cette permutation.
Le tableau suivant montre le résultat de la permutation considérée ci-dessus sur trois ensembles \(\mathcal{A}, \mathcal{B}, \mathcal{C}\). Ainsi, \(\min \pi(\mathcal{A}) = c = \min \pi(\mathcal{B})\) et \(\min \pi(\mathcal{C}) = b\).
Examinons de plus près la probabilité de collision. Soit \(x\) le nombre d’éléments communs entre \(\mathcal{A}\) et \(\mathcal{B}\), c’est à dire \(|\mathcal{A} \cap \mathcal{B}|\). Soit \(y\) le nombre d’éléments spécifiques à \(\mathcal{A}\) ou à \(\mathcal{B}\), c’est à dire \(|(\mathcal{A}-\mathcal{B}) \cup (\mathcal{B}-\mathcal{A})|\). Alors, l’indice de Jaccard entre \(\mathcal{A}\) et \(\mathcal{B}\) est \(s_J(\mathcal{A},\mathcal{B}) = \frac{x}{x+y}\). Aussi, pour toute fonction \(h_{\pi}\), la probabilité de trouver en premier après la permutation \(\pi\) un élément commun plutôt qu’un élément spécifique est \(\frac{x}{x+y}\). Donc, \(p(h_{\pi}(\mathcal{A}) = h_{\pi}(\mathcal{B})) = \frac{x}{x+y}\). Ainsi, pour toute fonction \(h_{\pi}\) et quels que soient les ensembles \(\mathcal{A},\mathcal{B} \in \mathcal{P}(\mathcal{E})\), la probabilité de collision est égale à l’indice de Jaccard entre les deux ensembles. Cette famille de fonctions LSH est à la base de l’algorithme MinHash, largement utilisé pour la détection de quasi-copies de documents.
Une seule fonction élémentaire n’est généralement pas assez sélective. Deux stratégies de composition permettent d’améliorer les résultats :
Composition ET (table de hachage). On regroupe \(n\) fonctions élémentaires indépendantes en une table de hachage dont le hash est le n-uplet des hash individuels. Deux données sont en collision dans la table si et seulement si elles sont en collision par rapport à chacune des \(n\) fonctions. Pour un indice de Jaccard \(s\), la probabilité de collision passe de \(s\) avec une seule fonction MinHash à \(s^n\) avec \(n\) fonctions indépendantes. Cela réduit les faux positifs mais augmente les faux négatifs.
Fig. 29 Composition de 3 fonctions élémentaires (ET logique). Illustration avec fonctions LSH pour la distance euclidienne
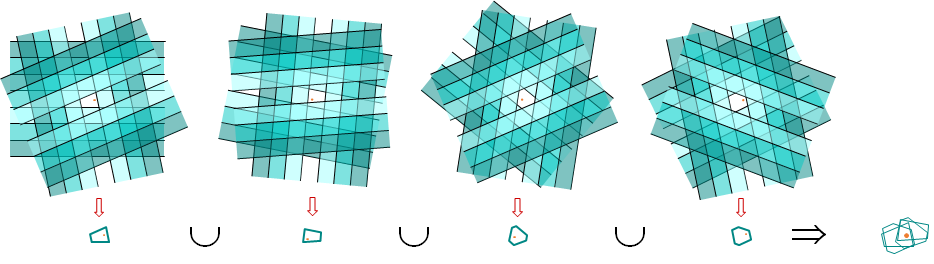
Composition OU (tables multiples). On utilise \(t\) tables indépendantes et on retourne la réunion des résultats des tables. Deux données sont en collision si elles le sont dans au moins une table. La probabilité de collision passe de \(s^n\) avec une table de fonctions MinHash à \(1 - (1 - s^n)^t\) avec \(t\) tables indépendantes. Cela augmente le rappel au prix d’un espace de stockage et d’un temps de requête plus élevés.
Fig. 30 Composition de 4 tables de hachage (OU logique). Illustration avec fonctions LSH pour la distance euclidienne
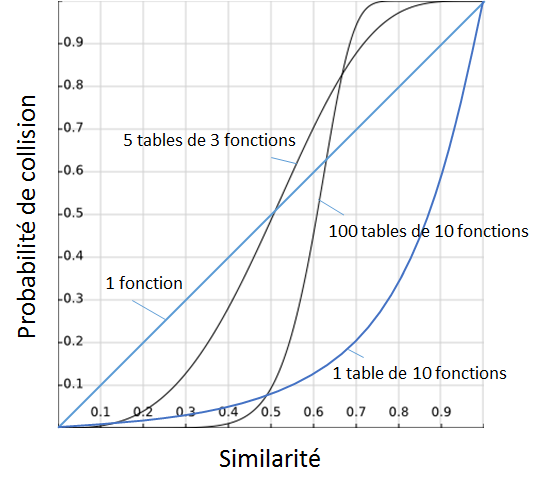
Effet d’amplification. La combinaison des deux stratégies (ET dans chaque table, OU entre les tables) produit une courbe de probabilité de collision qui tend vers une fonction à seuil, comme illustré dans la Fig. 31 pour fonctions MinHash : les données dont la similarité dépasse un seuil \(s^*\) sont presque certainement retournées, les autres presque certainement non.
Fig. 31 Courbes de probabilité de collision selon la stratégie d’amplification (\(n\) fonctions par table, \(t\) tables)
Le seuil \(s^*\) peut être ajusté en modifiant \(n\) et \(t\). En revanche, augmenter \(t\) augmente linéairement l’espace occupé et le temps de recherche.
Généralisation :
Les calculs ont été réalisés ci-dessus pour des fonctions MinHash mais cette méthode d’amplification de fonctions LSH est générale. Soit une famille de fonctions de hachage \((r_1, r_2, p_1, p_2)\)-sensibles (avec \(r_2 > r_1 > 0\), \(p_1 > p_2 > 0\)), voir la définition dans les équations lshrrpp. L’objectif de l’amplification est de rapprocher \(p_2\) (la probabilité de collision entre données dissimilaires) de 0 et \(p_1\) (la probabilité de collision entre données similaires) de 1. Le regroupement de \(n\) fonctions dans de nouvelles fonctions \(h_{\texttt{AND}}\) (appelées jusqu’ici tables de hachage) revient à faire un ET logique entre les collisions par rapport aux \(n\) fonctions : \(h_{\texttt{AND}}(x) = h_{\texttt{AND}}(y)\) si et seulement si \(h_i(x) = h_i(y)\) pour tout \(i\), \(1 \leq i \leq n\). On constate que ces nouvelles fonctions \(h_{\texttt{AND}}\) sont \((r_1, r_2, p^n_1, p^n_2)\)-sensibles. Faire la réunion des résultats de \(t\) fonctions revient à un OU logique entre les \(t\) fonctions : \(h_{\texttt{OR}}(x) = h_{\texttt{OR}}(y)\) si et seulement si \(h_i(x) = h_i(y)\) pour au moins une valeur de \(i\), \(1 \leq i \leq t\). Les nouvelles fonctions \(h_{\texttt{OR}}\) sont \((r_1, r_2, 1 - (1 - p_1)^t, 1 - (1 - p_2)^t)\)-sensibles. Enfin, faire la réunion des résultats de \(t\) fonctions \(h_{\texttt{AND}}\) (c’est à dire la réunion des résultats de plusieurs tables de hachage) engendre de nouvelles fonctions \(h_{\texttt{OR,AND}}\) qui sont \((r_1, r_2, 1 - (1 - p^n_1)^t, 1 - (1 - p^n_2)^t)\)-sensibles.
Pour limiter le nombre de tables tout en maintenant un rappel élevé, Multi-probe LSH[LJW07] propose d’interroger, pour chaque table, non seulement la page de la requête mais aussi les pages voisines selon un taux d’échantillonnage décroissant avec la distance à la requête. À rappel constant, le nombre de tables peut ainsi être réduit d’un ordre de grandeur.
Les données massives sont souvent caractérisées par un nombre élevé de variables, dont certaines peuvent exiger un nombre élevé de dimensions pour être représentées. C’est le cas, par exemple, pour une variable nominale qui a de nombreuses modalités ou pour une variable de type « ensemble » pour laquelle l’ensemble total est de grande cardinalité.
La grande dimension de la représentation des données engendre des difficultés regroupées sous le nom de « malédiction de la dimension » (ou « fléau de la dimension », curse of dimensionality). Ces difficultés peuvent être majeures et concernent aussi bien la modélisation statistique des données que l’efficacité des algorithmes d’organisation ou de recherche dans ces données. Nous résumons ici quelques-unes de ces difficultés :
A nombre de données fixé, la densité diminue exponentiellement avec la dimension. Les données deviennent « rares » ou « isolées » dans l’espace. Il n’est plus possible d’estimer la densité de façon fiable et différents tests statistiques deviennent inexploitables. Le nombre de données devrait augmenter de façon exponentielle avec la dimension pour conserver les capacités de modélisation.
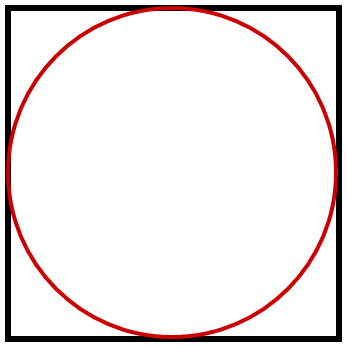
Les données uniformément distribuées dans des volumes en dimension \(d\) sont proches des hypersurfaces externes (de dimension \(d-1\)). Par exemple, si on considère une (hyper-)sphère inscrite dans un (hyper-)cube, comme dans la figure suivante (illustration en 2D), le rapport entre le volume de l’hypersphère et le volume de l’hypercube diminue rapidement avec l’augmentation de la dimension, comme indiqué dans le tableau qui suit. Cela implique que la plupart des données de l’hypercube ne sont pas dans l’hypersphère mais plutôt dans les « coins » de l’hypercube. Supposons qu’on utilise LSH pour la distance euclidienne afin de retourner les données situées dans un rayon autour d’une requête qui serait le centre de l’hypersphère. On constate que la plupart des données du même bucket que la requête (bucket qui sera, dans le meilleur des cas, un hyper-parallélépipède) ne seront pas dans l’hypersphère et devront être filtrées par des calculs de distance pour conserver une bonne précision (éliminer les faux positifs). Quand la dimension augmente, le nombre de données à filtrer sera beaucoup plus grand que celui des données utiles.
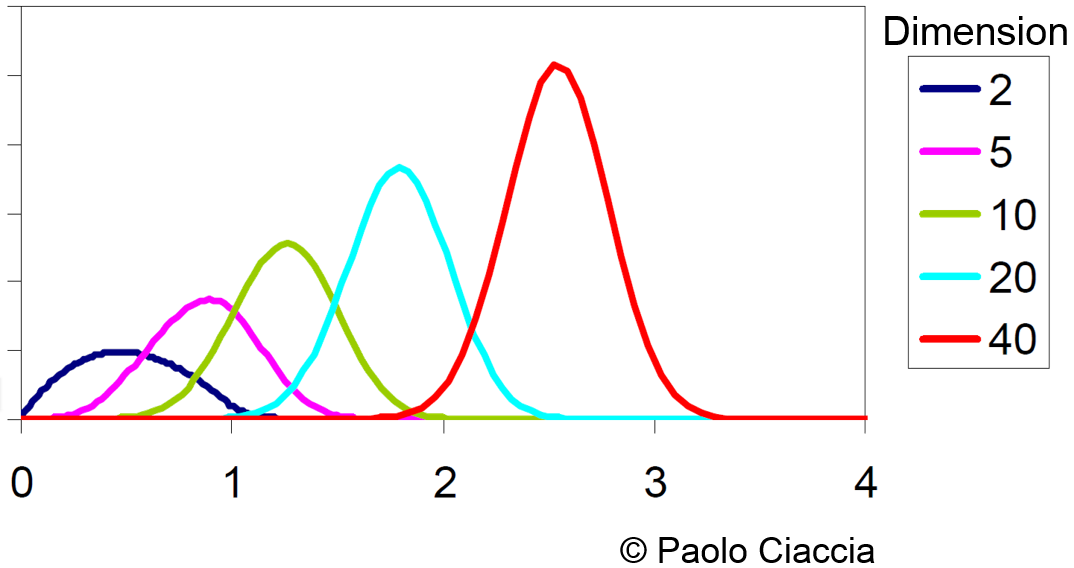
La variance de la distribution des distances entre données diminue avec l’augmentation de la dimension (voir la figure suivante). Cette difficulté, qui est une des manifestations de la « concentration des mesures », peut rendre inexploitable la décision sur la base des k plus proches voisins car la représentativité de ces voisins pour une donnée devient comparable à la représentativité des autres données. Aussi, il devient difficile de trouver des regroupements dans les données (les données à l’intérieur d’un groupe ne sont pas tellement plus proches entre elles que des données d’autres groupes), donc l’intérêt de la classification automatique diminue. Enfin, l’hypothèse « les données similaires à la requête sont bien plus similaires que les autres » devient fausse et les index perdent leur efficacité dans la réduction de la complexité de la recherche.
Fig. 33 Concentration des mesures pour des données qui suivent une distribution uniforme
Il est important de mentionner ici deux facteurs modérateurs de la malédiction de la dimension :
La distribution des données a une grande importance dans la gravité de la malédiction de la dimension. Plus la distribution des données est non uniforme, plus élevée est la dimension à partir de laquelle les capacités de modélisation et l’efficacité des index diminuent de façon sensible.
La dimension des données peut éventuellement être réduite par différentes méthodes, comme nous l’avons vu dans un chapitre précédent. La dimension qui compte est la « dimension intrinsèque » des données, qui peut être bien plus faible que la dimension apparente. Plusieurs définitions formelles existent pour la notion de « dimension intrinsèque », certaines proposent des estimateurs opérationnels.
Avec l’essor des modèles d’apprentissage profond, en particulier les transformers utilisés dans les grands modèles de langage (Large Language Models, LLM), il est courant de représenter des objets hétérogènes (textes, images, sons, graphes) sous forme de vecteurs denses de grande dimension (typiquement 512 à 4096), qui sont des plongements vectoriels (embeddings en anglais). Ces vecteurs sont produits par un modèle (encoder) et reflètent une similarité sémantique : deux objets sémantiquement proches produisent des vecteurs proches selon la distance cosinus ou euclidienne. Les bases de données vectorielles (vector databases), conçues pour indexer et interroger efficacement (recherche du plus proche voisin approximatif, ANN) des collections de vecteurs de haute dimension, peuvent ainsi être employées partout où une bonne technique d’encodage existe.
Plusieurs familles d’algorithmes sont employées dans les bases de données vectorielles pour la recherche ANN. Rappelons que les données sont dans ce cas des vecteurs denses de dimension élevée (mais fixée).
LSH. Le hachage sensible à la similarité, présenté dans la section précédente, est l’une des premières approches utilisées pour la recherche ANN. Sa complexité sous-linéaire et sa facilité de mise en œuvre distribuée en font une option attractive pour des bases très volumineuses.
IVF (Inverted File Index). Cette méthode quantifie préalablement l’espace avec \(k\) centroïdes (par k-means ou une technique similaire), puis assigne chaque vecteur au centroïde le plus proche. Pour répondre à la requête on identifie les centroïdes les plus proches (on en examine en général plusieurs, contrôlé par nprobe) et on cherche exhaustivement parmi les vecteurs qui leur sont assignés. La qualité de la recherche dépend fortement du choix de \(k\) et de nprobe.
PQ (Product Quantization). La quantification par produit [JDS11] compresse les vecteurs en découpant chaque vecteur en \(m\) sous-vecteurs de dimension \(d/m\), chaque sous-vecteur étant quantifié indépendamment avec un petit dictionnaire de \(2^{b}\) codes (sur \(b\) bits). Cela permet de stocker les vecteurs sur \(m \times b\) bits au lieu de \(d \times 32\) bits et de calculer des distances approximatives très rapidement à partir des codes. IVF et PQ sont souvent combinés (IVF-PQ) pour obtenir un index compact et rapide.
ScaNN (Scalable Approximate Nearest Neighbors). Développé par Google [AABG20], ScaNN est une méthode qui combine une quantification anisotrope (qui privilégie les erreurs « parallèles » au vecteur de la requête, moins gênantes que les erreurs « orthogonales » pour le classement final) avec un rééquilibrage des partitions. Elle est utilisée en production pour des milliards de vecteurs.
HNSW (Hierarchical Navigable Small World). L’algorithme HNSW [MY16] construit un graphe hiérarchique à plusieurs couches sur les vecteurs de la base les points).
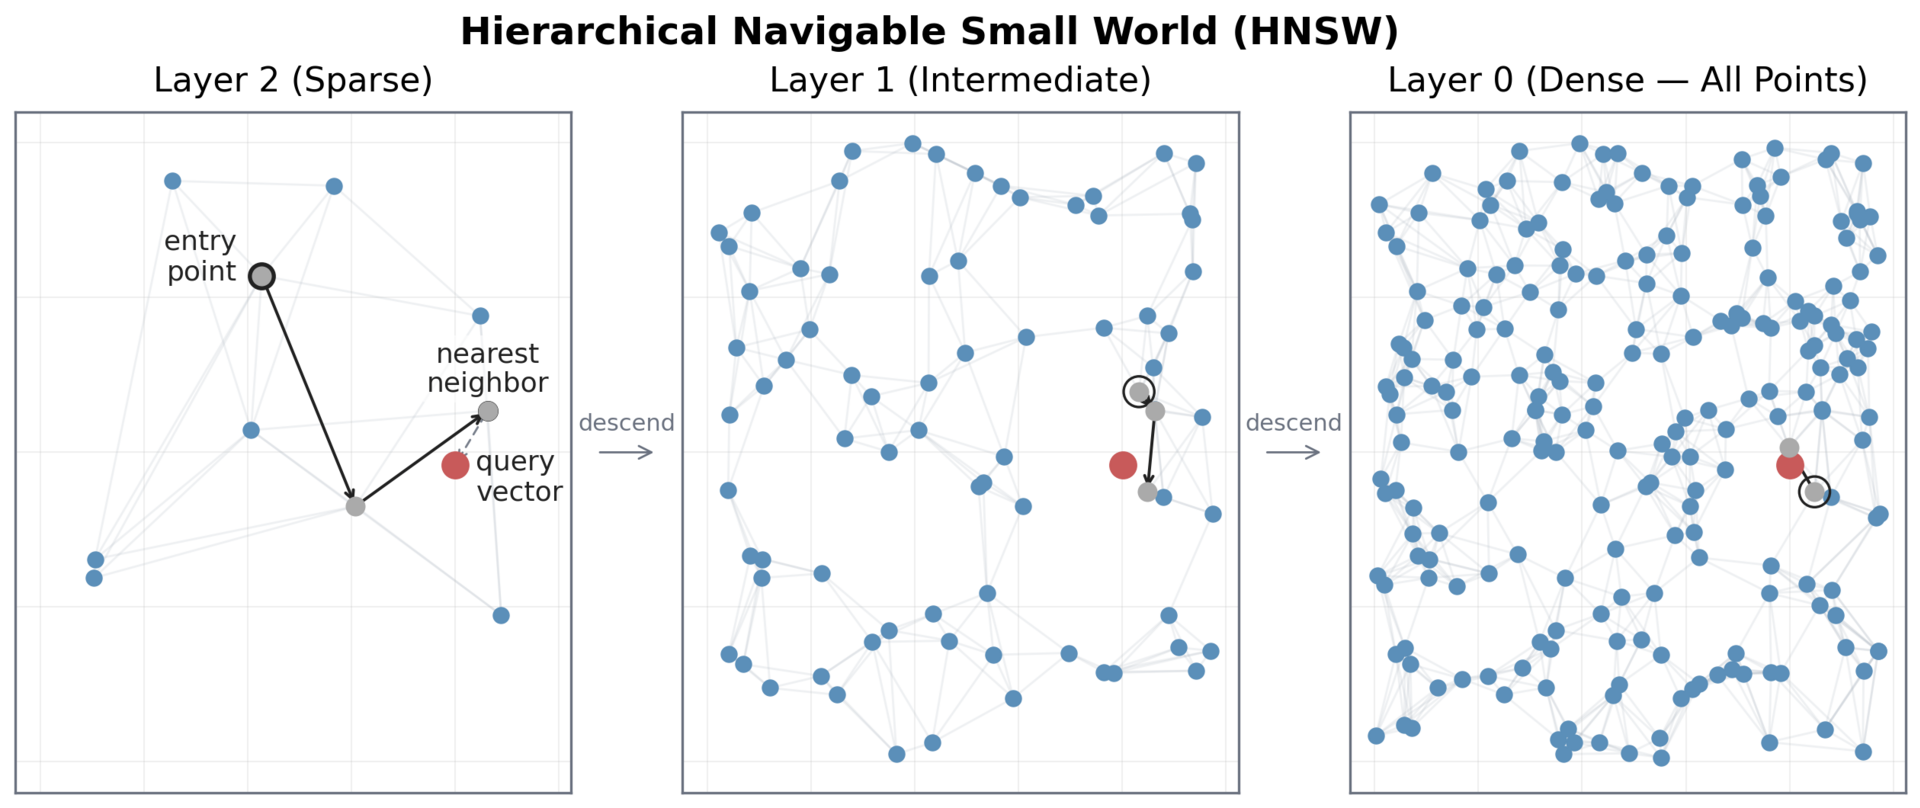
Les points sont répartis sur plusieurs couches superposées, comme indiqué dans la :refnum:`hnsw`. La couche 0, en bas, contient tous les points avec un graphe de voisinage dense. Chaque couche au-dessus ne contient qu’un sous-ensemble aléatoire des points de la couche inférieure, avec des arêtes plus longues (comme des autoroutes qui permettent de traverser l’espace en peu de sauts, alors que la couche 0 ne gère que les déplacements locaux). Pour la recherche des plus proches voisins du point requête, on part d’un point d’entrée fixe dans la couche la plus haute, et on se déplace de façon gloutonne vers le voisin le plus proche de la requête. Dès qu’aucun voisin n’apporte d’amélioration dans une couche, on descend d’un niveau en gardant ce meilleur candidat comme point de départ, et on répète l’opération. Le processus converge ainsi progressivement jusqu’à la couche 0, où une recherche plus fine (contrôlée par un paramètre) renvoie les k plus proches voisins approximatifs. HNSW offre en pratique un très bon compromis précision/vitesse et est aujourd’hui l’algorithme le plus utilisé dans les bases de données vectorielles.
Fig. 34 Structure hiérarchique HNSW à trois couches : couche 2 creuse (sparse), couche 1 intermédiaire, couche 0 dense ; la requête arrive par la couche creuse, suit les chemins de navigation dans chaque couche pour trouver le plus proche voisin dans la couche, descend progressivement vers la couche dense et retourne le plus proche voisin trouvé. Source de l’image
Une base de données vectorielles intègre, autour de l’index ANN, plusieurs autres composants :
Stockage persistant des vecteurs et des métadonnées associées (identifiant, attributs filtrables, horodatage, etc.).
Filtrage hybride : possibilité de combiner une condition sur les métadonnées (par ex. « langue = français ») avec la recherche par similarité vectorielle, sans perte majeure de performance.
Mise à jour en ligne (upsert, suppression) : les index ANN classiques sont difficiles à mettre à jour de façon incrémentale ; les bases de données vectorielles proposent des mécanismes de gestion des mises à jour (parfois par reconstruction périodique de l’index en arrière-plan).
Réplication et partitionnement (sharding) pour passer à l’échelle sur un cluster.
Interface de requête (API REST, SDK Python, etc.) et intégration avec des frameworks d’IA (LangChain, LlamaIndex, etc.).
Fig. 35 Architecture d’une base de données vectorielles, avec le flux d’indexation (documents, encodeur, index ANN et stockage des vecteurs) et le flux de requête (requête, encodeur, recherche ANN, filtre hybride, résultats classés) ; l’encodeur est commun aux deux flux
Les principales solutions actuelles peuvent être regroupées en trois catégories :
Bases de données vectorielles natives : Pinecone, Weaviate, Qdrant, Milvus/Zilliz. Ces systèmes ont été conçus dès le départ pour la recherche vectorielle et proposent des fonctionnalités avancées (filtrage, réplication, API cloud).
Extensions vectorielles de bases existantes : pgvector (PostgreSQL), Redis Search, Elasticsearch dense vector. Ces solutions permettent d’ajouter la recherche vectorielle dans une infrastructure existante au prix d’une moindre performance à très grande échelle.
Bibliothèques d’indexation : FAISS (Facebook AI Research), Annoy (Spotify), ScaNN (Google). Ce sont des bibliothèques bas niveau sans gestion de persistance ni de métadonnées ; elles sont souvent utilisées comme moteur d’index à l’intérieur des bases de données vectorielles natives.
Le choix d’un index ANN et de ses paramètres met en jeu trois variables :
Rappel (recall@k) : proportion des vrais \(k\) plus proches voisins effectivement retournés parmi les \(k\) candidats proposés (la recherche étant approximative).
Latence de requête : temps moyen pour répondre à une requête. Dans certaines applications la latence n’est pas critique et on s’intéresse plutôt au débit dans le traitement d’un flux de requêtes.
Empreinte mémoire : taille de l’index en mémoire vive.
Il est important de noter que ces variables sont interdépendantes. Par exemple, pour augmenter le rappel il sera nécessaire d’augmenter la latence (ou réduire le débit) à empreinte mémoire donnée.
Pour une application donnée, le choix du bon index et de ses paramètres exige une évaluation empirique sur des données représentatives. En effet, les performances relatives des index dépendent de la taille de la base, de la distribution des données, des ressources (notamment mémoire) disponibles, etc. Le site ANN Benchmarks propose une comparaison systématique des principaux algorithmes sur des jeux de données publics, selon les trois axes précédents.
Gionis, A., P. Indyk, R. Motwani. Similarity search in high dimensions via hashing. Dans Proceedings of the 25th International Conference on Very Large Data Bases, VLDB’99, pages 518–529. Morgan Kaufmann Publishers Inc., 1999.
Lv, Q., W. Josephson, Z. Wang, M. Charikar, K. Li. Multi-probe LSH: Efficient indexing for high-dimensional similarity search. Dans Proceedings of the 33rd International Conference on Very Large Data Bases, VLDB’07, pages 950–961. VLDB Endowment, 2007.
Malkov, Y. A., D. A. Yashunin. Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs. IEEE Transactions on Pattern Analysis and Machine Intelligence, 42(4):824–836, 2020.
Jégou, H., M. Douze, C. Schmid. Product quantization for nearest neighbor search. IEEE Transactions on Pattern Analysis and Machine Intelligence, 33(1):117–128, 2011.
Guo, R., P. Sun, E. Lindgren, et al. Accelerating Large-Scale Inference with Anisotropic Vector Quantization. Dans Proceedings of the 37th International Conference on Machine Learning, ICML 2020.
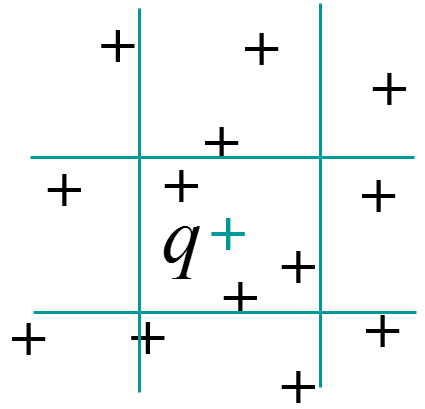
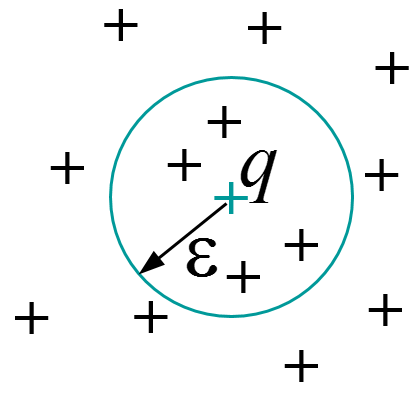
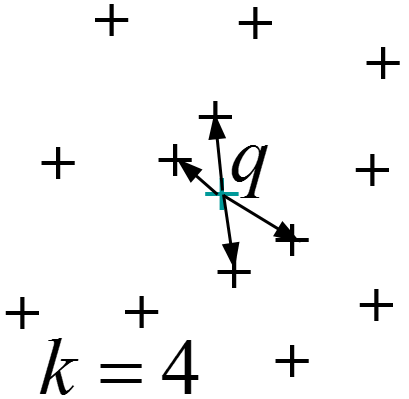


 \[\begin{split}\begin{array}{|c|l|} \hline \textrm{Dimension} & \textrm{Volume sphère / volume cube englobant}\\ \hline 1 & 1\\ 2 & 0,78732\\ 4 & 0,329707\\ 6 & 0,141367\\ 8 & 0,0196735\\ 10 & 0,00399038\\ \hline \end{array}\end{split}\]