Cours - Graphes et réseaux sociaux : détection de communautés
Supports complémentaires :
[Diapositives du cours : 2 par page] [Diapositives du cours : 1 par page]
Introduction
Une communauté dans un graphe est un sous-ensemble de nœuds fortement interconnectés entre eux, et faiblement connectés au reste du réseau. Cette notion, intentionnellement informelle, reflète une réalité observée dans de nombreux systèmes : élèves d’une même classe, collaborateurs d’un même laboratoire, pages web d’un même domaine thématique, protéines d’un même complexe moléculaire.
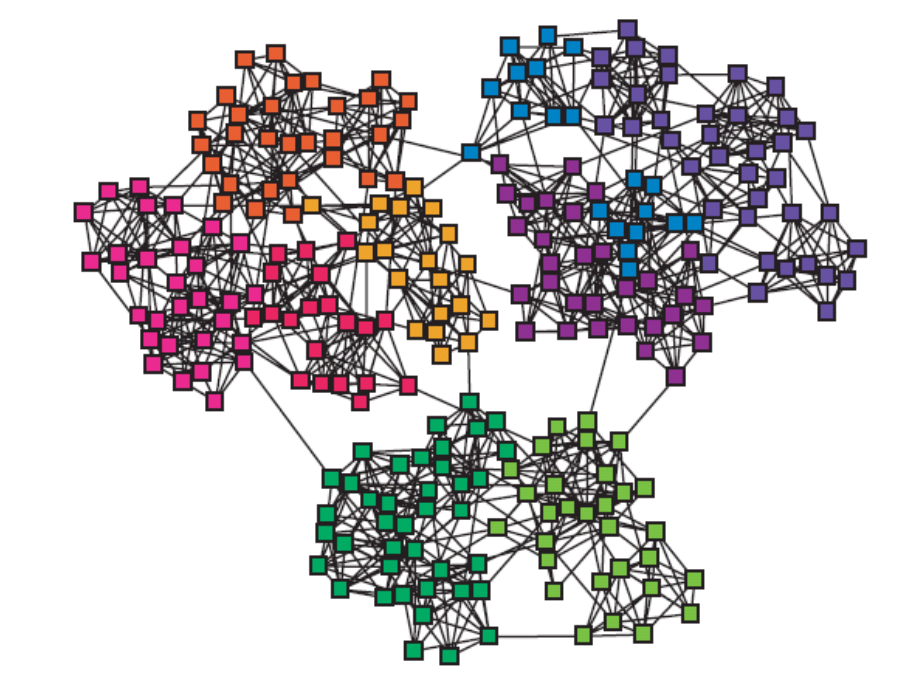
Fig. 68 Partitionnement d’un graphe en communautés non recouvrantes
Les communautés peuvent être non recouvrantes (chaque nœud appartient à exactement une communauté, Fig. 68) ou recouvrantes (un nœud peut appartenir à plusieurs communautés simultanément, par ex. une personne peut avoir plusieurs groupes d’amis sans lien entre eux, Fig. 69).
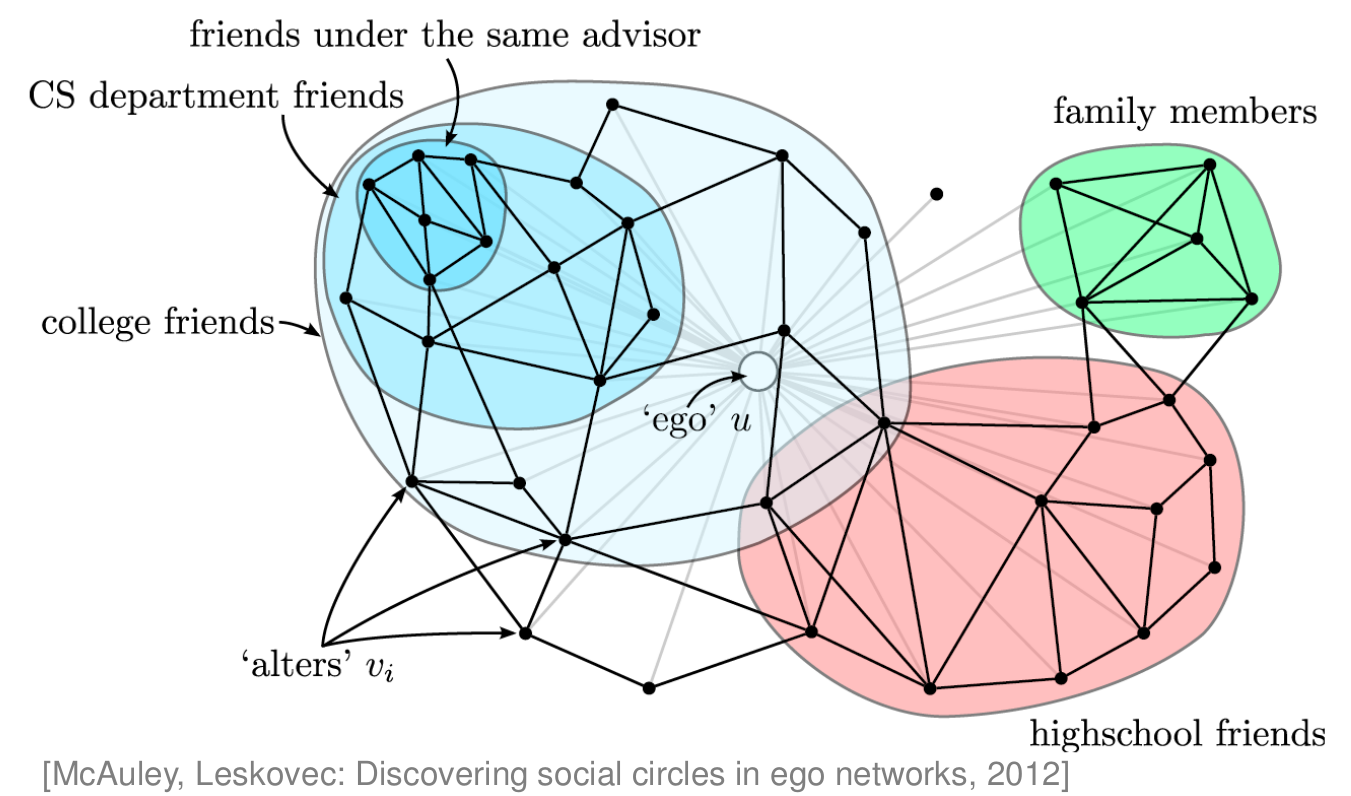
Fig. 69 Réseau égocentré : communautés recouvrantes autour d’un individu
Les applications sont nombreuses : segmentation d’utilisateurs pour la recommandation (voir cette section), identification de groupes à risque dans un réseau épidémiologique, détection de modules fonctionnels dans les réseaux biologiques, analyse de marchés financiers, détection de communautés de pages web thématiques.
Note
Nous nous limitons ici aux graphes statiques. Le suivi temporel des communautés (fusion/scission entre instants \(t\) et \(t+1\)) reste un sujet de recherche actif.


Mesurer la qualité d’un partitionnement : la modularité
Avant de présenter les algorithmes il faut se donner une métrique permettant de comparer des partitionnements de graphes. La modularité [BGLL08], notée \(Q\) dans (11), indique dans quelle mesure un partitionnement place davantage de liens à l’intérieur des communautés que ce qu’on attendrait dans un graphe aléatoire de même structure de degrés.
Formellement, pour un graphe de \(m\) arêtes partitionné en communautés \(S\), en notant \(A_{ij}\) la matrice d’adjacence et \(k_i\) le degré du nœud \(i\) :
Le terme \(\frac{k_i k_j}{2m}\) est la probabilité d’existence d’une arête entre \(i\) et \(j\) dans le modèle configurationnel (graphe aléatoire préservant la distribution de degrés). La modularité est positive si les communautés sont plus denses que ce modèle aléatoire, négative sinon.
Interprétation pratique :
\(Q \approx 0\) : absence de structure communautaire significative ;
\(Q > 0{,}3\) : structure communautaire notable ;
\(Q > 0{,}7\) : structure communautaire forte (rare en pratique).
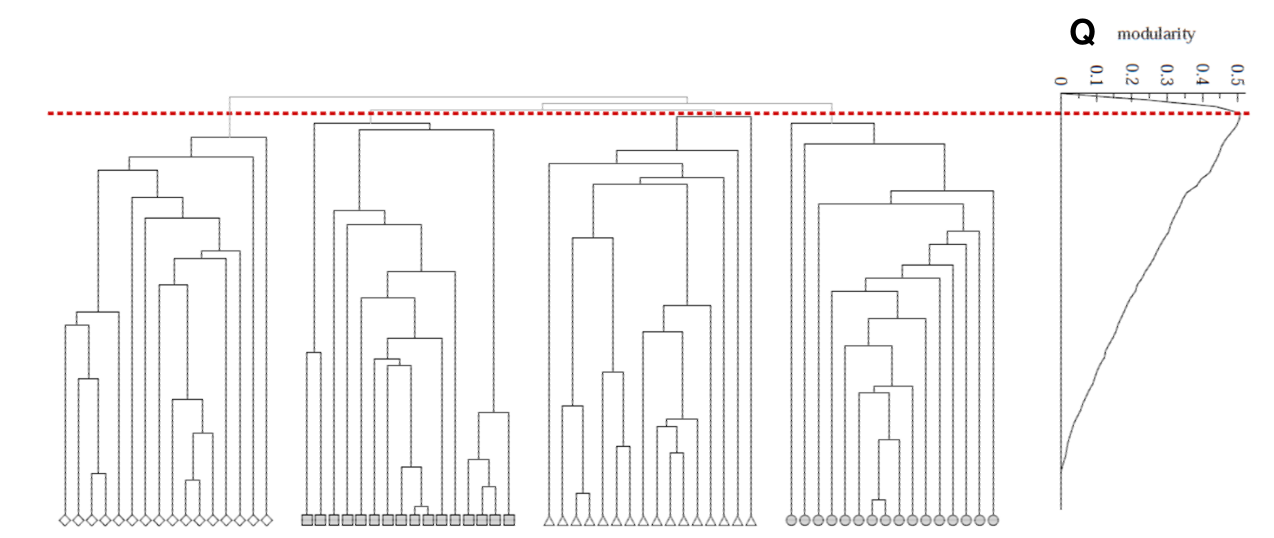
Fig. 70 Illustration : sélection du meilleur niveau de partitionnement hiérarchique grâce à la modularité
Limite de résolution. La modularité présente un biais connu : elle peut ne pas détecter de petites communautés. Par exemple, sur un anneau de cliques (Fig. 71), si les cliques sont suffisamment petites par rapport au graphe global, la partition optimale au sens de \(Q\) regroupe les cliques deux à deux plutôt que de les séparer. Ce problème est inhérent à la métrique \(Q\), indépendamment des algorithmes qui l’optimisent.
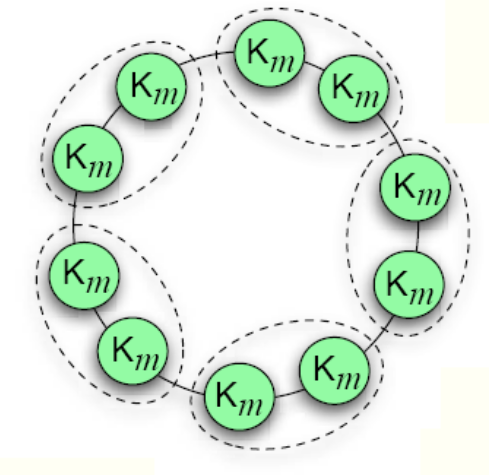
Fig. 71 Anneau de cliques : la modularité peut rater les petites communautés
Approches par coupure spectrale
Partitionner un graphe peut s’exprimer comme un problème d’optimisation sur ses arêtes. La coupe (cut) entre deux ensembles de nœuds, \(A\) et \(B\), est le nombre d’arêtes ayant une extrémité dans chaque groupe :
Minimiser la coupe seulze conduit à des partitions dégénérées (isoler un nœud unique minimise trivialement la coupe). On préfère la coupe normalisée (normalized cut, [SM00]), qui normalise par le volume de chaque partie (\(\mathrm{vol}(A)\) = somme des degrés des nœuds de \(A\)) :
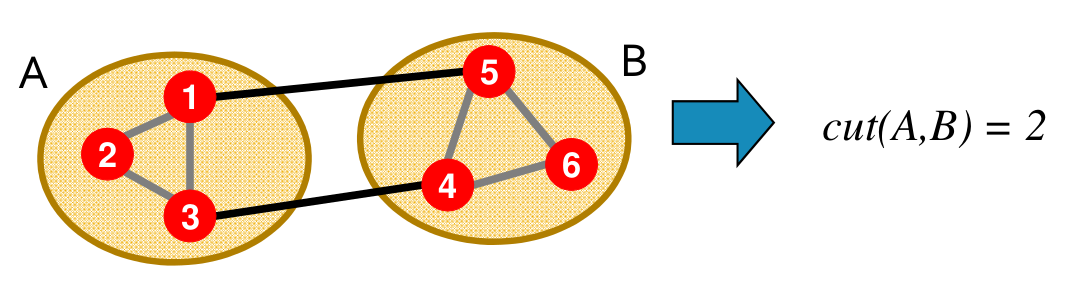
Fig. 72 Calcul de la coupe
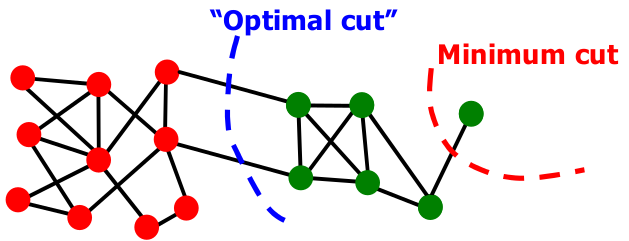
Fig. 73 Minimiser la coupe (cut) seule favorise des partitions déséquilibrées
La minimisation de la coupe normalisée est NP-difficile en général. Cependant, une propriété remarquable lie ce problème à l”analyse spectrale de la matrice laplacienne \(L = D - A\) : le vecteur propre associé à la deuxième plus petite valeur propre (appelé vecteur de Fiedler) fournit une bonne approximation de la partition optimale. On seuille ce vecteur pour obtenir la partition.
Cette approche se généralise à \(k\) communautés : on calcule les \(k\) premiers vecteurs propres de \(L\), on représente chaque nœud par son vecteur de coordonnées spectrales et on applique un algorithme de clustering (k-means) dans cet espace. C’est le clustering spectral, qui est particulièrement performant sur les graphes dont les communautés sont non convexes ou présentent des densités hétérogènes.
Complexité : le calcul des vecteurs propres est en \(O(n^3)\) en général (ou \(O(kn^2)\) avec des méthodes itératives). Le clustering spectral ne passe pas directement à l’échelle sur les très grands graphes sans approximations (e.g. approximation de Nyström, Laplacien normalisé creux).
Approche divisive : Girvan-Newman
L’algorithme de Girvan et Newman (2002) adopte une démarche descendante : il retire itérativement les arêtes les plus « inter-communautaires » pour révéler les groupes.
Le principe repose sur la centralité d’intermédiarité des arêtes : une arête qui appartient à de nombreux plus courts chemins entre paires de nœuds est probablement un pont entre communautés. L’algorithme :
Calculer la centralité d’intermédiarité de chaque arête ;
Retirer l’arête de plus forte centralité d’intermédiarité ;
Recalculer les centralités (car les chemins se redistribuent suite à l’opération précédente) ;
Répéter jusqu’à ce qu’il n’y ait plus d’arête.
On obtient une décomposition hiérarchique (dendrogramme) du graphe. On sélectionne le niveau de coupe maximisant la modularité.
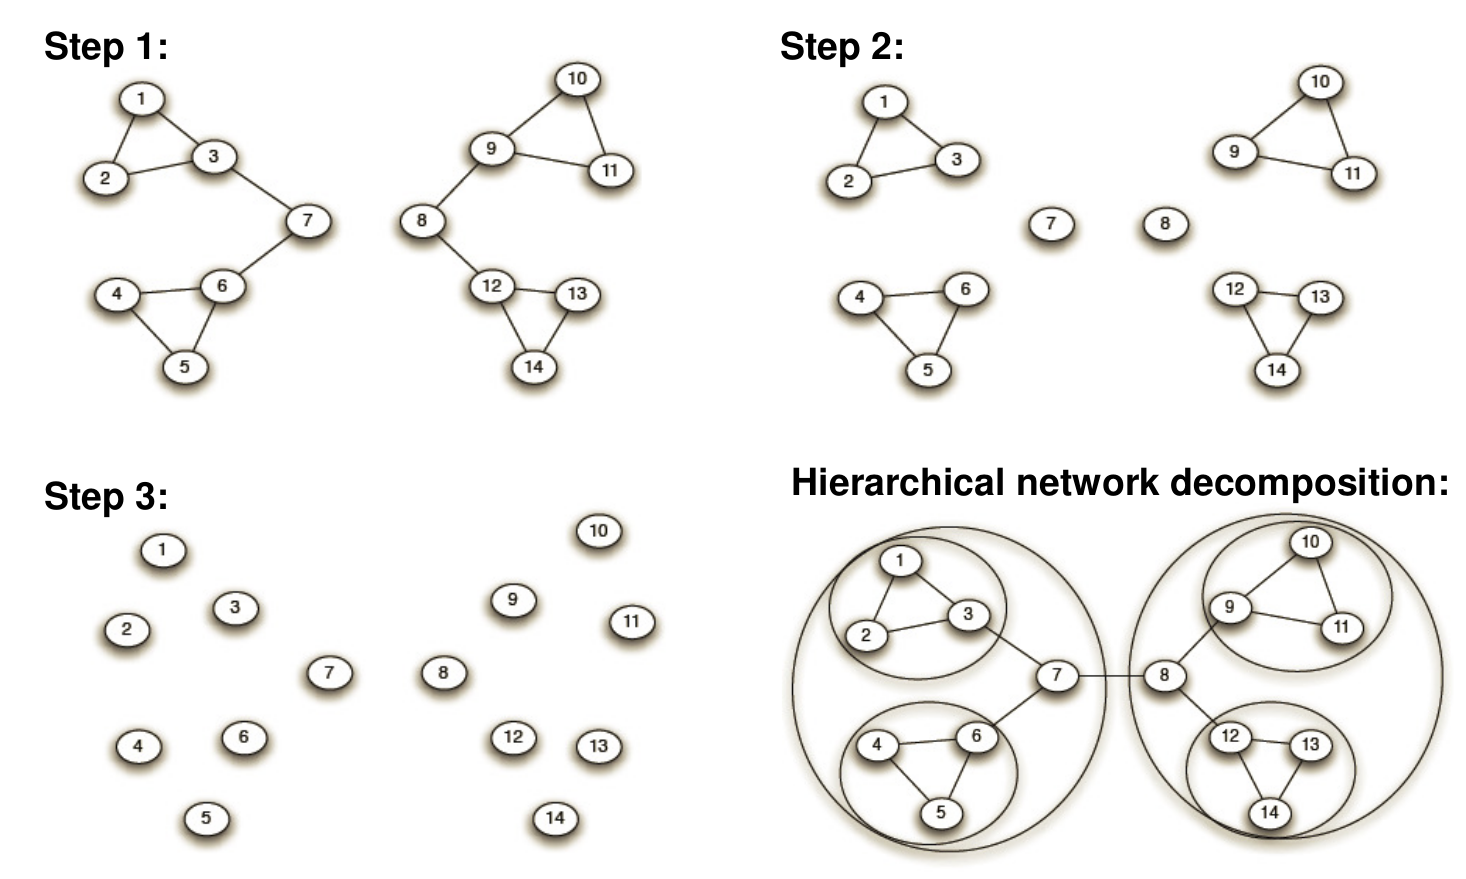
Fig. 74 Étapes de l’algorithme de Girvan-Newman
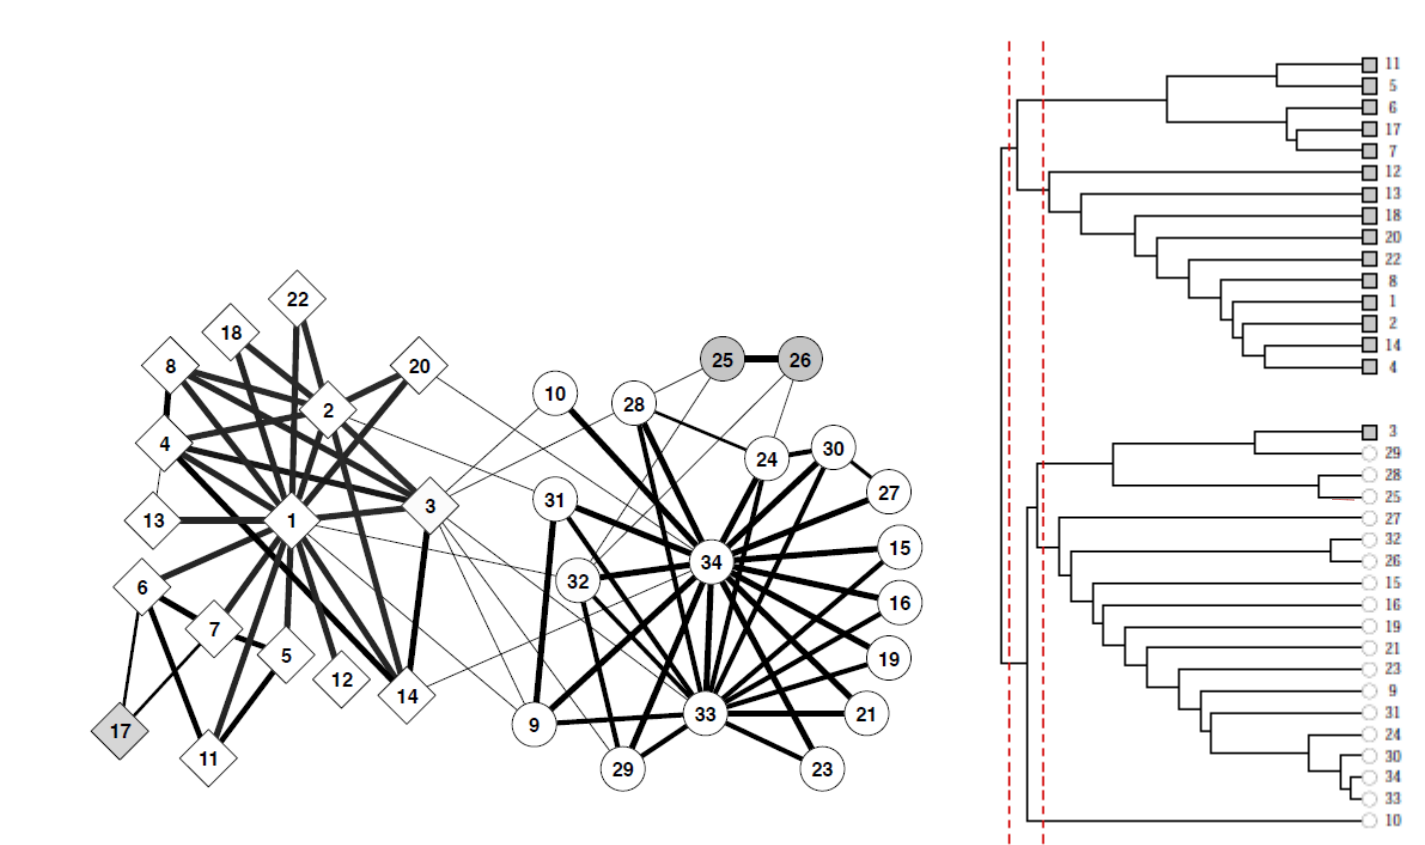
Fig. 75 Application de l’algorithme de Girvan-Newman au graphe du Karaté-Club de Zachary
Complexité de Girvan-Newman : \(O(m^2 n)\), voire \(O(m^3)\) pour les graphes creux. Cela le rend impraticable au-delà de quelques milliers de nœuds. Il reste utile comme référence et pour les graphes de taille modérée.
Optimisation de la modularité : l’algorithme de Louvain
L’algorithme de Louvain [BGLL08] est l’algorithme de détection de communautés le plus utilisé en pratique sur les grands graphes. Il optimise la modularité de façon « gloutonne » (greedy) en deux phases alternées.
Phase 1 : optimisation locale. Au début, chaque nœud est sa propre communauté. On parcourt les nœuds dans un ordre aléatoire et pour chaque nœud \(i\) on évalue le gain de modularité qu’apporterait son déplacement dans la communauté de chacun de ses voisins. On effectue ensuite le déplacement qui maximise ce gain (s’il est positif). On itère jusqu’à stabilité.
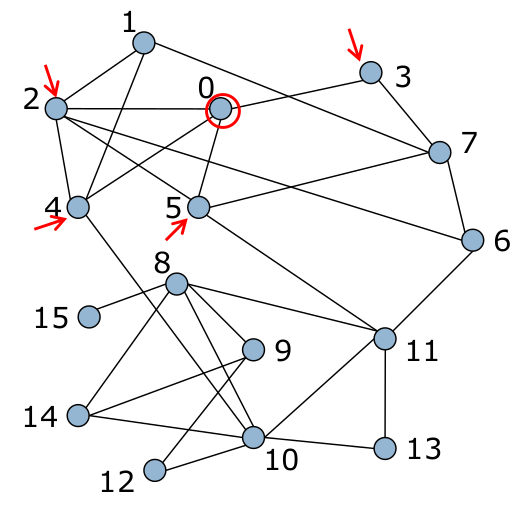
Fig. 76 Phase 1 : état initial, chaque nœud est sa communauté
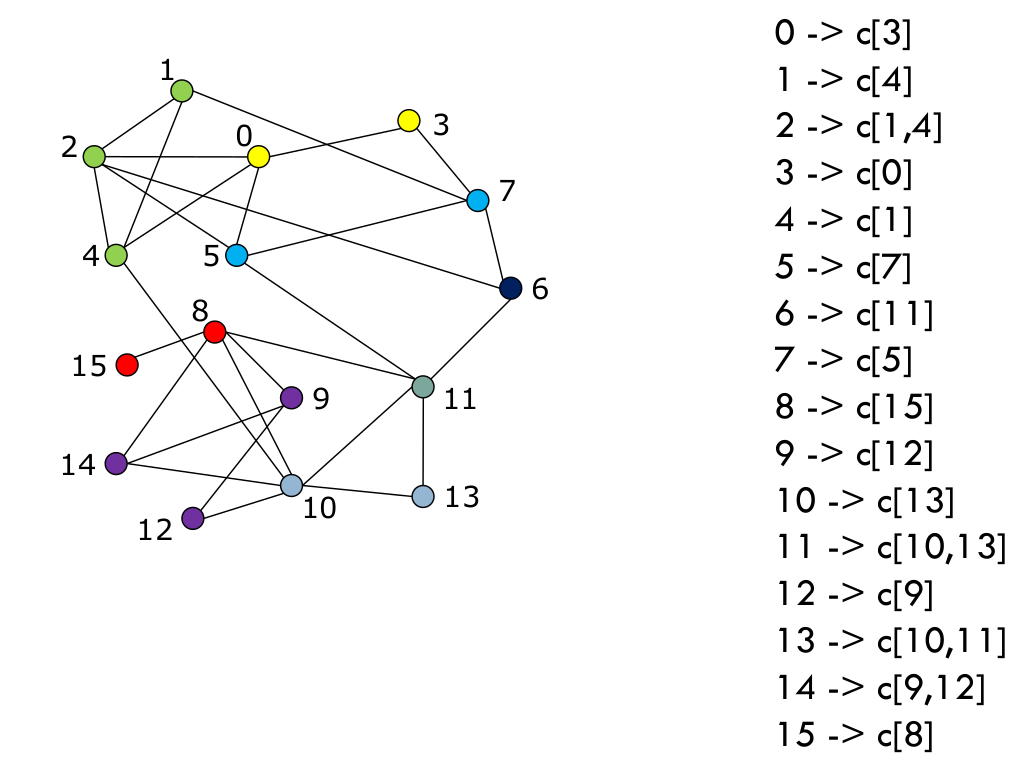
Fig. 77 Phase 1 : après convergence locale, chaque couleur correspond à une communauté
Phase 2 : condensation. On construit un nouveau graphe dont les nœuds sont les communautés trouvées en phase 1. Les arêtes entre ces super-nœuds sont valuées par le nombre d’arêtes entre les communautés correspondantes. Les liens internes à une communauté forment des boucles.
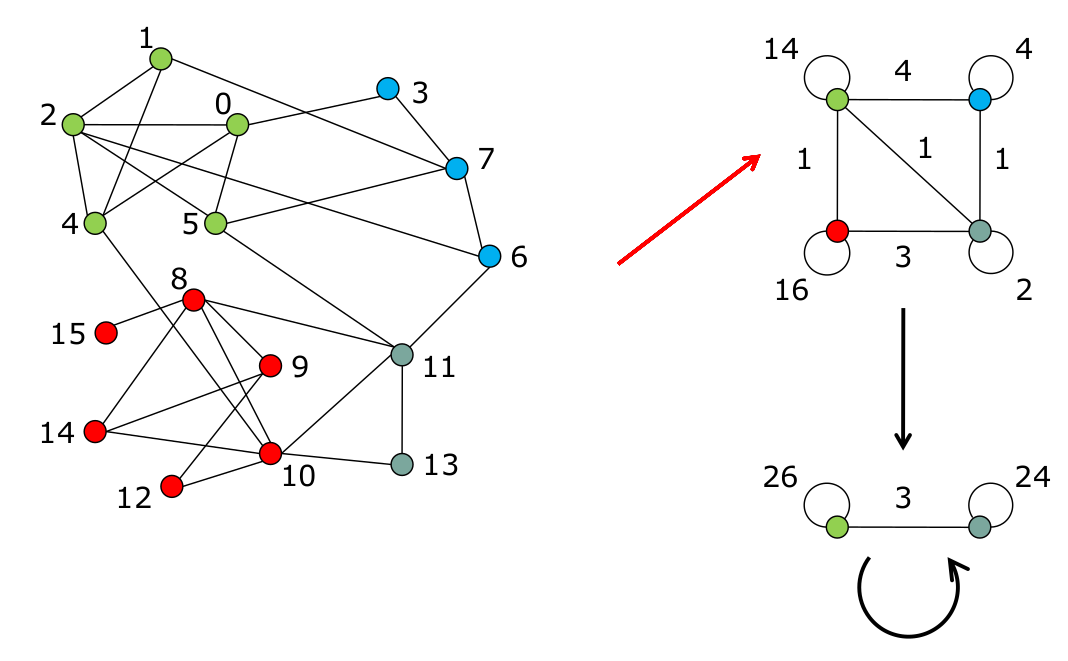
Fig. 78 Phase 2 : condensation en super-nœuds
On répète les deux phases sur ce graphe condensé jusqu’à stabilité globale. Le résultat est une hiérarchie de communautés : les niveaux supérieurs correspondent à des méga-communautés, les niveaux inférieurs à des sous-groupes plus fins.
Propriétés importantes :
Non déterministe : l’ordre de parcours des nœuds en phase 1 est aléatoire ; deux exécutions sur le même graphe peuvent donc donner des partitions différentes (mais de modularité comparable).
Complexité : quasi-linéaire en pratique, \(O(m \log m)\) sur des graphes creux. Applicable à des graphes de plusieurs milliards de nœuds.
Limite de résolution : hérite de celle de la modularité (cf. supra).
Leiden : une amélioration de Louvain
L’algorithme de Leiden [TSWL19] (2019) corrige un défaut structurel de Louvain : ce dernier peut produire des communautés mal connectées (des nœuds d’une même communauté ne pouvant se rejoindre que via d’autres communautés).
Leiden ajoute une phase de partitionnement local (local moving avec raffinement) entre les deux phases de Louvain. Concrètement, après la phase 1 de Louvain, les communautés sont subdivisées en sous-communautés candidates et seuls les déplacements qui améliorent la connectivité interne sont validés.
Garanties théoriques : Leiden garantit que toutes les communautés produites
sont bien connectées et fournit des partitions d’aussi bonne ou meilleure
modularité que Louvain, à complexité comparable. Il est disponible dans la
bibliothèque Python leidenalg et dans NetworkX.
Propagation d’étiquettes
L’algorithme de propagation d’étiquettes (Label Propagation Algorithm, LPA) [RAK07] est l’une des approches les plus simples et les plus rapides :
Initialisation : chaque nœud reçoit une étiquette unique (son propre identifiant).
À chaque itération, chaque nœud adopte l’étiquette la plus fréquente dans son voisinage (en cas d’égalité, tirage aléatoire).
On s’arrête quand chaque nœud a l’étiquette majoritaire de son voisinage.
Les nœuds portant la même étiquette à convergence forment une communauté.
Propriétés :
Complexité : quasi-linéaire, \(O(m)\) par itération, converge en général en quelques itérations.
Non déterministe : les égalités étant résolues aléatoirement, les résultats varient entre exécutions.
Pas d’hypothèse sur le nombre de communautés, qui est déterminé automatiquement.
Limitation : les résultats sont moins stables que pour Louvain/Leiden, surtout sur les graphes peu structurés. Utile comme première exploration rapide ou pour les graphes très larges.
La propagation d’étiquettes est implémentée nativement dans GraphFrames (méthode
labelPropagation), ce qui le rend directement utilisable dans un
environnement Spark.
Communautés recouvrantes : DEMON et BigCLAM
Toutes les méthodes précédentes produisent des partitions non recouvrantes. Or, dans les réseaux sociaux réels, un individu appartient souvent à plusieurs communautés (famille, collègues, club sportif, etc.).
DEMON (Democratic Estimate of the Modular Organization of a Network, [CPCL12]) est une méthode locale et distribuée :
Pour chaque nœud \(u\), on extrait son égo-réseau (le sous-graphe induit par ses voisins).
On détecte des communautés dans cet égo-réseau par propagation d’étiquettes.
Les communautés locales de tous les nœuds sont agrégées par un schéma de fusion : deux communautés locales sont fusionnées si elles partagent plus d’une fraction \(\epsilon\) de leurs membres.
Avantage : chaque étape étant locale, le calcul est parallélisable. DEMON est
disponible dans la bibliothèque Python cdlib.
BigCLAM (CLuster Affiliation Model for Big Networks, [YL13]) adopte une approche probabiliste : on suppose que chaque nœud appartient à un ensemble de communautés avec une certaine force d’appartenance, la probabilité d’une arête entre \(u\) et \(v\) vaut
où \(F_{uc} \geq 0\) est la force d’appartenance de \(u\) à la communauté \(c\). On ajuste les \(F\) par descente de gradient pour maximiser la vraisemblance du graphe observé. BigCLAM passe à l’échelle sur les grands graphes grâce à des optimisations exploitant les matrices creuses. BigCLAM est disponible dans la bibliothèque SNAP de Stanford.
Synthèse comparative
Algorithme |
Type |
Complexité |
Déterministe ? |
Passage à l’échelle |
|---|---|---|---|---|
Girvan-Newman |
Divisif |
\(O(m^2 n)\) |
Oui |
Non (petits graphes) |
Spectral |
Partitionnement |
\(O(kn^2)\) |
Oui |
Limité |
Louvain |
Optimisation Q |
\(O(m\log m)\) |
Non |
Oui (milliards) |
Leiden |
Optimisation Q+ |
\(O(m\log m)\) |
Non |
Oui |
Label Propagation |
Propagation |
\(O(m)\) |
Non |
Oui (natif Spark) |
DEMON |
Recouvrantes/local |
\(O(n m_{\text{ego}})\) |
Non |
Oui (parallèle) |
BigCLAM |
Recouvrantes/probab. |
\(O(nk)\) |
Non |
Oui |
Recommandations pratiques :
Pour une exploration rapide sur grand graphe, préférer Label Propagation (natif GraphFrames) ;
Pour la meilleure qualité sur grand graphe, préférer Louvain (
python-louvain/community) ou Leiden (leidenalg) ;Pour des communautés recouvrantes choisir DEMON ou BigCLAM (
cdlib) ;Ppour de petits graphes ou un besoin de référence choisir Girvan-Newman (dans NetworkX).
Références
Blondel, V. D., Guillaume, J.-L., Lambiotte, R., Lefebvre, E. Fast unfolding of communities in large networks. Journal of Statistical Mechanics: Theory and Experiment 2008 (10), P10008. https://arxiv.org/pdf/0803.0476v2.pdf
Coscia, M., Rossetti, G., Giannotti, F., Pedreschi, D. DEMON: a local-first discovery method for overlapping communities. KDD 2012.
Leskovec, J., Rajaraman, A. and Ullman, J. D. Mining of Massive Datasets. Cambridge University Press, 2011. http://www.mmds.org
Raghavan, U. N., Albert, R., Kumara, S. Near linear time algorithm to detect community structures in large-scale networks. Physical Review E 76, 036106 (2007).
Shi, J. and Malik, J. Normalized Cuts and Image Segmentation. IEEE PAMI 2000. https://people.eecs.berkeley.edu/~malik/papers/SM-ncut.pdf
Tang, J., Hu, X. and Liu, H. Social Recommendation: A Review. Social Network Analysis and Mining, 2013.
Traag, V. A., Waltman, L., van Eck, N. J. From Louvain to Leiden: guaranteeing well-connected communities. Scientific Reports 9, 5233 (2019). https://www.nature.com/articles/s41598-019-41695-z
Yang, J. and Leskovec, J. Overlapping Community Detection at Scale: A Nonnegative Matrix Factorization Approach. WSDM 2013.