Cours - Fouille de données textuelles (1/2)
Supports complémentaires :
[Diapositives du cours : 2 par page] [Diapositives du cours : 1 par page]
Les données textuelles constituent une source d’information d’une richesse considérable, mais leur exploitation par des méthodes automatiques se heurte à un obstacle fondamental : le fossé sémantique, c’est-à-dire l’écart entre l’interprétation qu’un ordinateur peut produire automatiquement à partir d’un texte et la signification que ce même texte a pour un lecteur humain. Les méthodes présentées dans ce cours et le suivant ne prétendent pas combler ce fossé, mais fournissent des outils permettant d’en extraire des informations utiles.
Ce premier cours couvre la chaîne classique de traitement de la langue (Natural Language Processing, NLP), de la collecte des données brutes jusqu’aux représentations vectorielles denses, en insistant sur les choix à faire à chaque étape et leur impact sur la qualité des analyses ultérieures. Le deuxième cours portera sur les transformers et les grands modèles de langage.
Note légale
La fouille de textes protégés par le droit d’auteur, même accessibles librement sur le web, est interdite (sauf accord explicite des auteurs) dans la plupart des pays européens. Le Royaume-Uni est une exception notable.
Objectifs et applications
La fouille de données textuelles vise principalement trois objectifs :
L’identification de thèmes : regrouper des (parties de) textes en thèmes inconnus a priori, en général par classification automatique appliquée à des représentations vectorielles.
Le classement de textes : affecter des (parties de) textes à des catégories prédéfinies par apprentissage supervisé pour la détection de spam, l’analyse de sentiments, la classification thématique, la détection de langue, etc.
L’extraction d’informations : mettre en correspondance des textes avec des schémas d’interprétation prédéfinis pour en extraire des variables structurées utilisables conjointement avec d’autres données.
Parmi les applications rencontrées en pratique : gestion de la relation client (catégorisation automatique des courriels, identification des motifs de plainte), surveillance de médias sociaux (tendances, analyse de sentiments sur une marque), recherche d’information à grande échelle, détection de risques sécuritaires, ou encore cartographie de concepts scientifiques entre communautés de recherche.
Pipeline de traitement NLP
Le traitement de données textuelles suit une chaîne d’étapes dont toutes ne sont pas systématiquement nécessaires ; le choix dépend de l’objectif et de la nature des données.
Collecte et pré-traitement
Les sources de données textuelles sont variées : textes élaborés grammaticalement corrects, messages SMS ou réseaux sociaux (lexique non standard, abréviations, émoticônes), transcriptions de la parole (nombreuses erreurs), listes de mots-clés (tags). La conformité lexicale et grammaticale de la source conditionne fortement la qualité des étapes suivantes.
Les pré-traitements comprennent l’uniformisation de l’encodage des caractères (particulièrement importante pour les caractères accentués), l’élimination des éléments non textuels (balises HTML, scripts, menus), et éventuellement la normalisation du langage (expansion des abréviations).
Extraction d’entités primaires (tokenisation)
Le texte est découpé en tokens (mots, signes de ponctuation, locutions) par un tokeniseur qui s’appuie sur un lexique et des règles dépendantes de la langue. Le lexique contient les lemmes de la langue et leurs variantes morphologiques, ainsi que des informations syntaxiques.
Un lemme peut être constitué d’un seul mot ou de plusieurs (mots composés comme « chauve-souris », locutions nominales comme « chemin de fer », locutions verbales comme « arrondir les angles »). La détection de locutions peut nécessiter une analyse contextuelle car une même séquence peut être une locution dans un contexte et non dans un autre (« arrondir les angles » dans un texte sur la négociation vs. dans des instructions de débavurage).
Nous verrons ultérieurement que pour certaines méthodes d’encodage vectoriel de textes les tokens correspondent plutôt à des parties de mots.
Étiquetage morpho-syntaxique (POS tagging)
Chaque token est caractérisé par sa catégorie lexicale (nom, verbe, adverbe, adjectif, préposition…) et des informations morphologiques (genre, nombre, mode, temps). L’ambiguïté est fréquente, par ex. « bien » peut être adverbe, nom, adjectif ou interjection. L’étiquetage utilise le contexte local pour lever l’ambiguïté mais des erreurs subsistent, surtout sur des textes à faible conformité grammaticale.
Exemple d’étiquetage fourni par TreeTagger sur un texte français (format mot catégorie lemme)
La          DET:ART   le
fouille     NOM       fouille
de          PRP       de
données     NOM       donnée
peut        VER:pres  pouvoir
être        VER:infi  être
définie     VER:pper  définir
comme       ADV       comme
Extraction d’entités nommées
Une entité nommée désigne de façon unique une entité du domaine : personnes (« Barack Obama »), lieux (« Mont Blanc »), organisations (« Nations Unies »), produits, dates, etc. Leur extraction est utile car elles portent souvent une information discriminante forte.
Les approches modernes font appel à l’apprentissage supervisé sur corpus annotés (modèles de type Bi-LSTM ou transformers). Les meilleurs outils atteignent 90 à 95 % d’extraction correcte pour les entités génériques ; pour des entités spécifiques à un domaine, un travail d’annotation spécifique reste nécessaire.
La résolution référentielle (ou entity linking) vise à identifier à quelle entité se réfère un pronom ou un groupe nominal anaphorique. Par exemple, Il dans « Barack Obama est le 44ème président des États-Unis. Il est né le 4 août 1961 à Honolulu » ; ou « La société de Mountain View » dans « Google […]. La société de Mountain View […] ». Elle fait appel à l’analyse syntaxique et à des bases de données d’entités.
Lemmatisation et racinisation
Pour la classification thématique, il peut être préférable de traiter comme une même unité les différentes formes d’un même lemme (« pensons », « pense », « penserons » → « penser »). Deux approches existent :
La lemmatisation remplace chaque forme dérivée par sa forme canonique (« pensons » → « penser »). Elle nécessite l’étiquetage grammatical et un lexique complet.
La racinisation (stemming) remplace chaque forme par sa racine (« pensons » → « pense »). Elle utilise des règles morphologiques simples mais produit souvent des confusions (« organ » est la racine d”« organe » et d”« organisation »).
La racinisation est souvent utilisée en anglais provoque plus souvent des confusions en français, la lemmatisation est donc préférable pour le français. Les deux opérations facilitent ensuite la construction de représentations vectorielles en réduisant le vocabulaire effectif.
Les mots à ignorer (stop words) — prépositions, conjonctions, articles, verbes auxiliaires — sont supprimés avant la construction de représentations vectorielles (pour certaines méthodes) car très fréquents dans tous les textes et donc peu discriminants.
Remarque
L’extraction d’entités nommées doit être réalisée avant la suppression des stop words car certains mots structurels font partie des entités nommées (« Musée de l’Homme »).


Représentations vectorielles classiques
Pour appliquer des méthodes de fouille à des données textuelles, il est nécessaire de les représenter sous forme vectorielle. Nous présentons ici les approches classiques, du modèle vectoriel le plus simple aux représentations dites « sémantiques ».
Modèle vectoriel et pondérations TF-IDF
La représentation la plus simple ([SMG86]) associe à chaque texte issu d’une collection \(\mathcal{T}\) fixée un vecteur de dimension \(n\) (nombre de termes distincts dans la collection \(\mathcal{T}\)). La composante du vecteur associée au terme \(i\) est nulle si ce terme est absent du document, et égale à une pondération sinon.
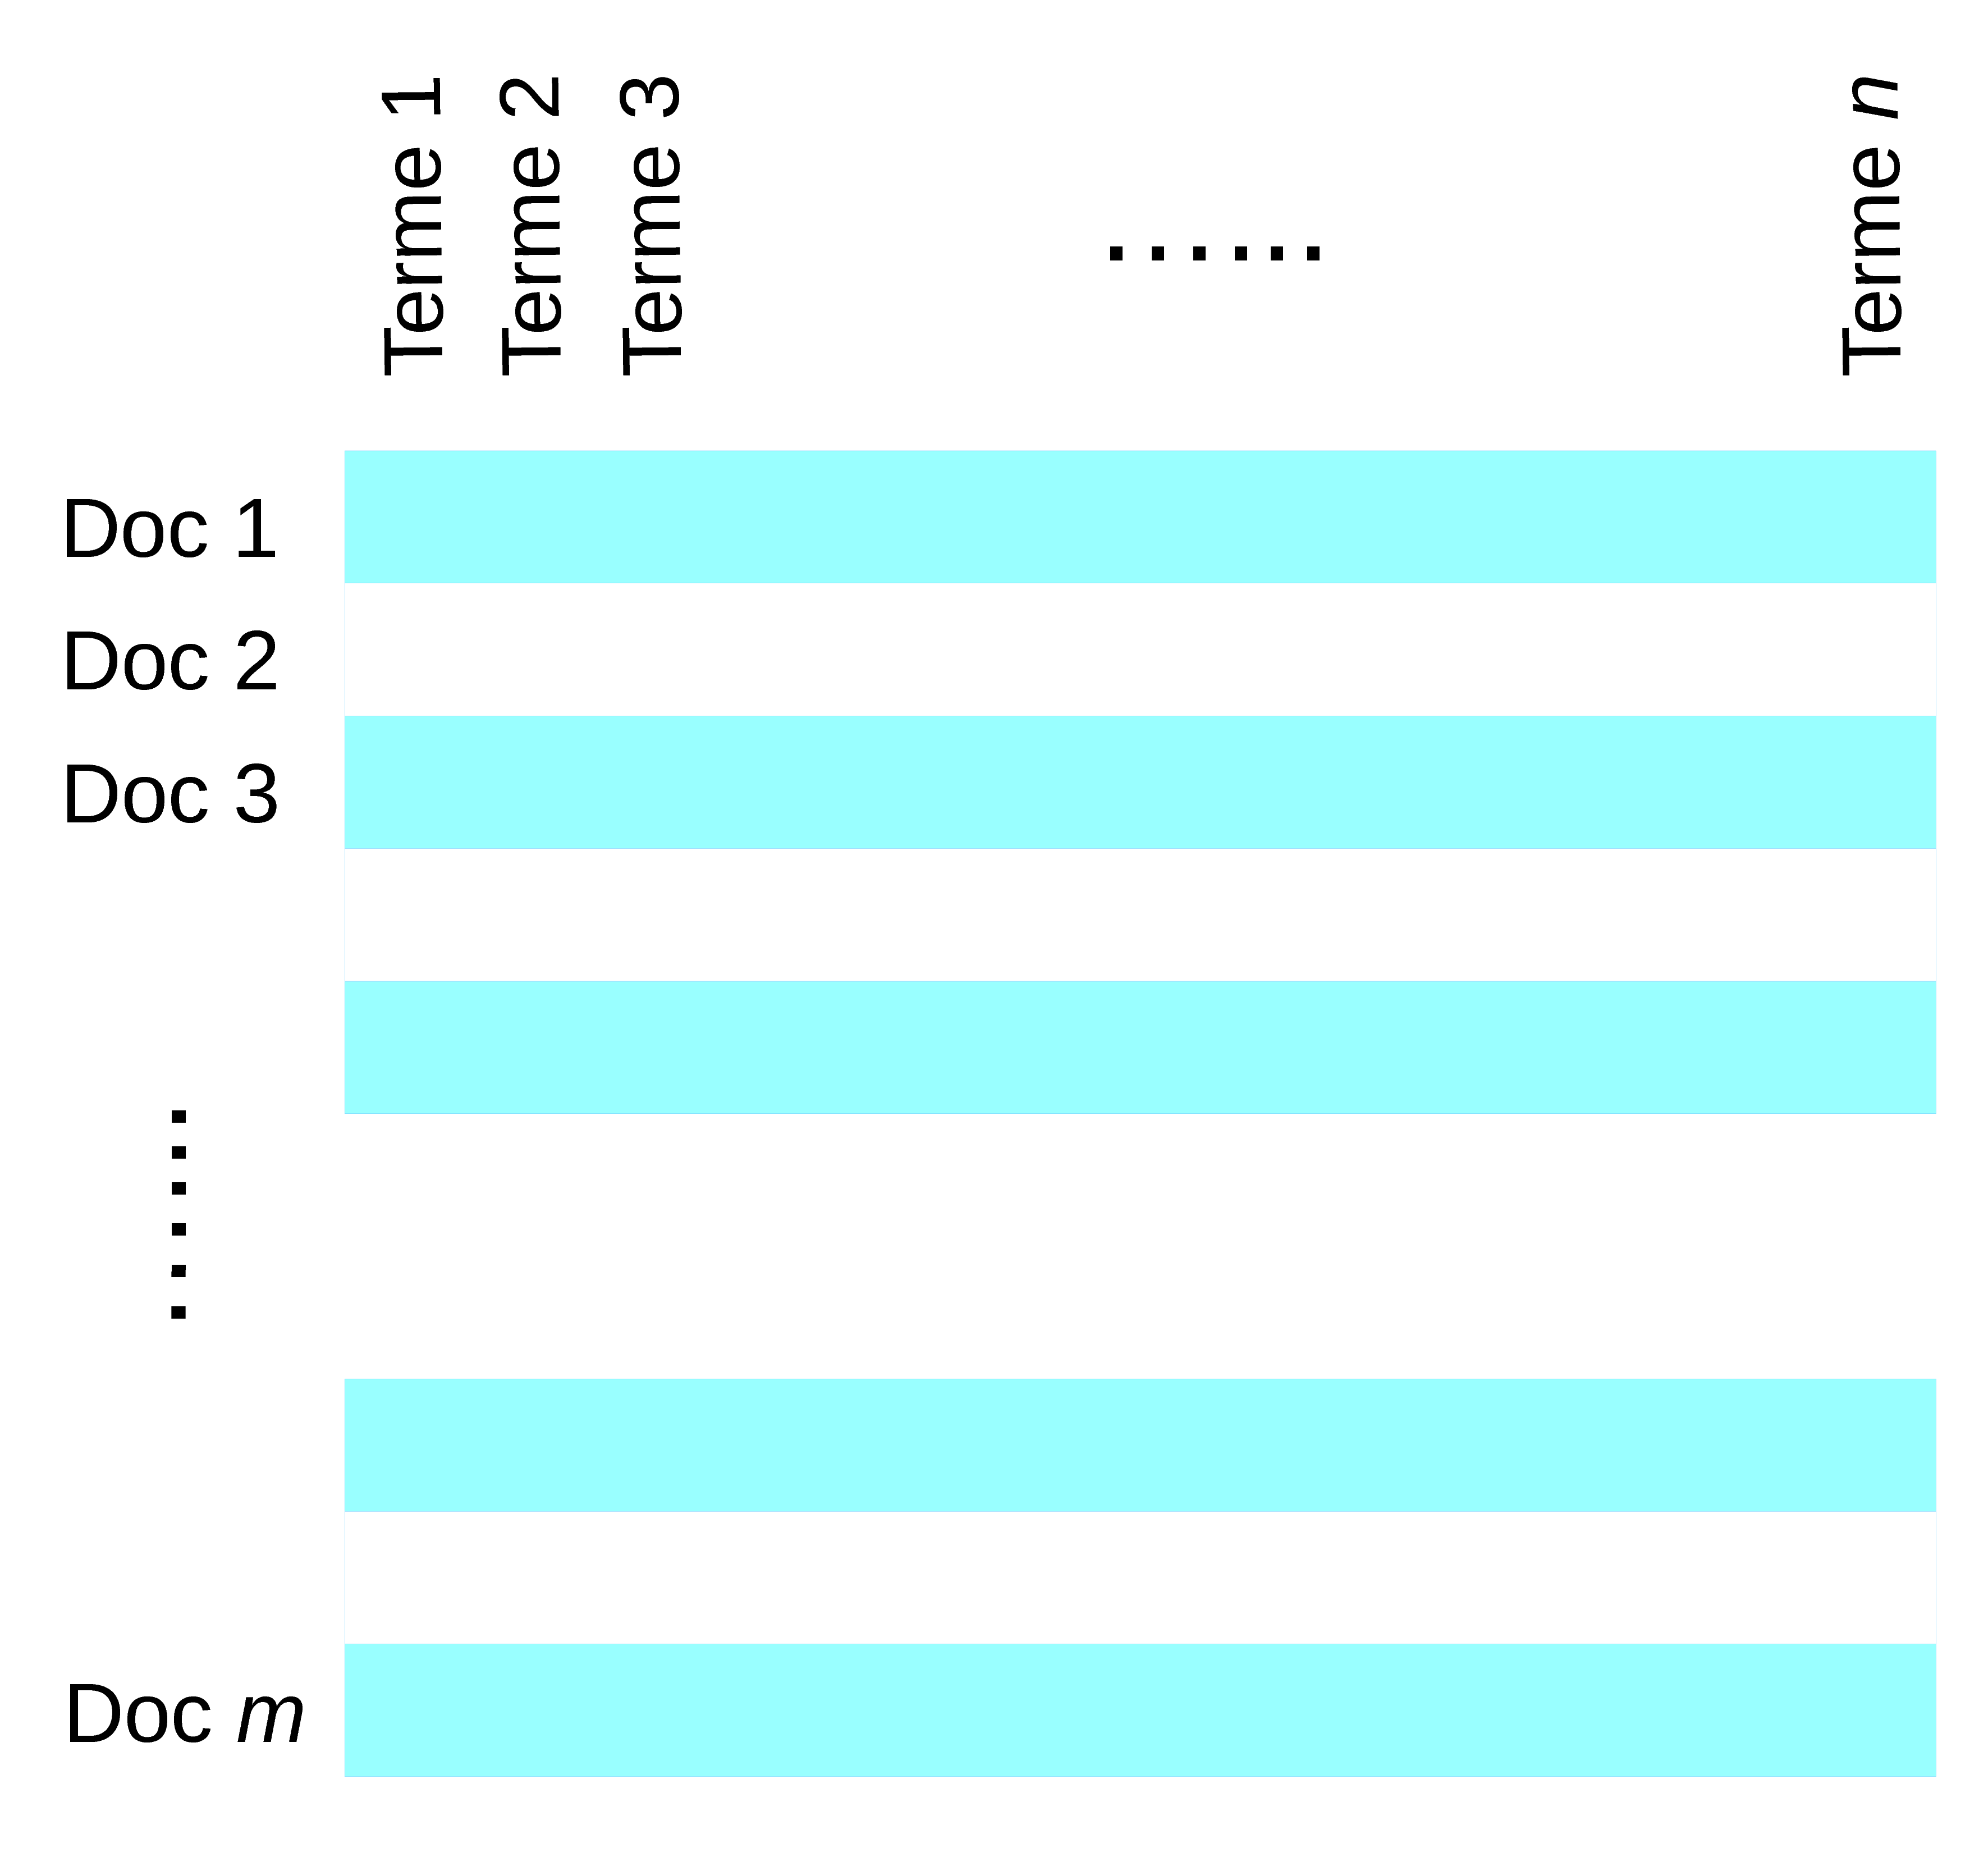
Fig. 49 Matrice documents-termes (dimension \(m \times n\), très creuse)
Ces vecteurs sont de très grande dimension (souvent \(10^4\) à \(10^5\)) et très creux (chaque texte ne contient qu’une fraction des termes du vocabulaire). La similarité entre textes s’exprime à travers leurs termes communs ; la distance cosinus est préférée à la distance euclidienne car elle est insensible à la longueur des documents.
Pour construire cette représentation vectorielle plusieurs étapes préalables sont nécessaires : l’extraction d’entités primaires, l’étiquetage grammatical, la lemmatisation (ou la racinisation, qui permet d’éviter l’étape d’étiquetage grammatical) et la suppression des « mots à ignorer » (stop words). Après ces opérations, un texte devient une succession de lemmes, incluant éventuellement locutions et entités nommées, qui sont toutes appelées « termes » ici.
La pondération TF-IDF raffine le modèle de base selon deux critères :
La fréquence du terme dans le document (term frequency, TF) : un terme qui apparaît souvent dans un document est plus caractéristique de ce document.
\[tf_{ij} = \frac{n_{ij}}{\|d_j\|}\]où \(n_{ij}\) est le nombre d’occurrences du terme \(i\) dans le document \(j\) et \(\|d_j\|\) la longueur du document.
La rareté du terme dans la collection (inverse document frequency, IDF) : un terme présent dans de nombreux documents est peu discriminant.
\[idf_i = \log\left(\frac{m}{m_i}\right)\]où \(m\) est le nombre total de documents et \(m_i\) le nombre de documents contenant le terme \(i\).
La pondération du terme \(i\) dans le document \(j\) est \(tf_{ij} \cdot idf_i\). Des variantes améliorées existent, notamment BM25 [RZ09], plus robuste pour la recherche d’information.
Ce modèle présente plusieurs limites importantes : les synonymes (« voiture » et « automobile ») occupent deux dimensions distinctes et leur proximité sémantique est inexploitable ; un terme polysémique (« avocat » dans un contexte juridique vs. culinaire) contribue indifféremment aux deux sens ; les termes rares stylistiques mais peu informatifs reçoivent un poids IDF élevé.
Analyse sémantique latente (LSA)
L’analyse sémantique latente ([DDL90]) répond en partie aux limites du modèle vectoriel en cherchant des concepts latents qui expliquent les cooccurrences de termes. Des synonymes comme « voiture » et « automobile » cooccurrent avec les mêmes termes (« moteur », « route », « carburant »…) et seront ainsi associés au même concept latent.
La LSA applique une décomposition en valeurs singulières (SVD) à la matrice documents-termes \(\mathbf{M}\) :
\(\mathbf{U}\) et \(\mathbf{V}\) sont des matrices orthogonales, \(\mathbf{S}\) est diagonale (valeurs singulières décroissantes). La SVD est liée à l’ACP : les colonnes de \(\mathbf{U}\) sont les vecteurs propres de \(\mathbf{M}\mathbf{M}^T\) et les colonnes de \(\mathbf{V}\) ceux de \(\mathbf{M}^T\mathbf{M}\).
En ne retenant que les \(k\) plus grandes valeurs singulières on obtient la meilleure approximation de rang \(k\) de \(\mathbf{M}\) :
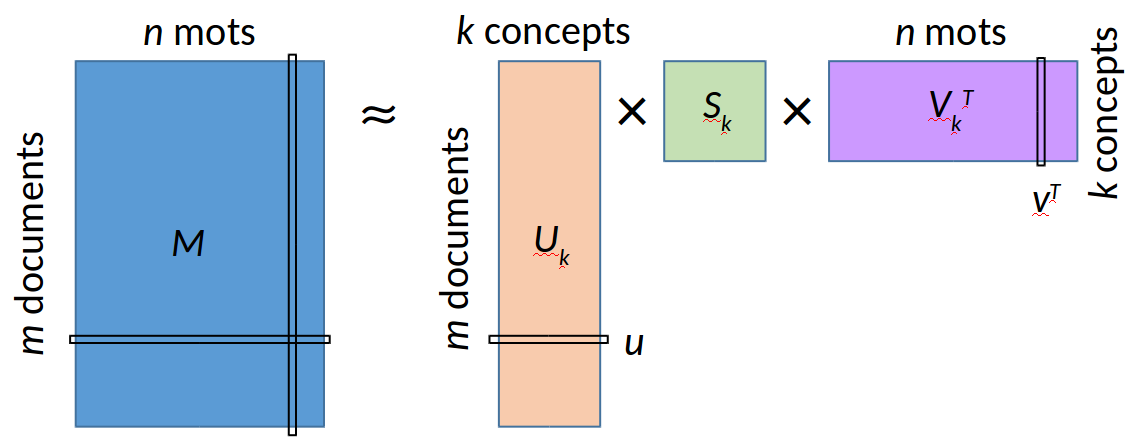
Fig. 50 Décomposition matricielle pour la LSA : les \(k\) premières colonnes de \(\mathbf{U}_k\) représentent les documents, les lignes de \(\mathbf{V}_k^T\) représentent les termes dans l’espace des concepts
Chaque document est alors représenté par un vecteur de dimension \(k\) (typiquement 100 à 500) dans l’espace des concepts latents. La réduction de rang atténue le « bruit » dû aux termes rares ou polysémiques.
Cette idée a été étendue dans l”allocation de Dirichlet latente (LDA, [BNJ03]) qui modélise chaque document comme un mélange de thèmes (topics) et chaque thème comme une distribution sur les mots, dans un cadre probabiliste. LDA est implémentée dans Spark.
Analyse sémantique explicite (ESA)
La LSA construit ses concepts à partir de la collection \(\mathcal{T}\) elle-même, ce qui introduit des biais liés aux particularités de cette collection. L”analyse sémantique explicite ([GM07]) contourne ce problème en s’appuyant sur un corpus de référence très large et général : Wikipedia (environ 2 millions d’articles en français fin 2017).
Chaque terme est représenté par un vecteur dont les dimensions correspondent aux pages Wikipedia et dont les composantes sont les pondérations TF-IDF du terme dans chaque page. La dimension de ces vecteurs est donc de l’ordre de \(10^5\) à \(10^6\).
Un document quelconque est alors représenté par le centre de gravité des vecteurs ESA de ses termes, pondérés par leurs TF-IDF dans le document :
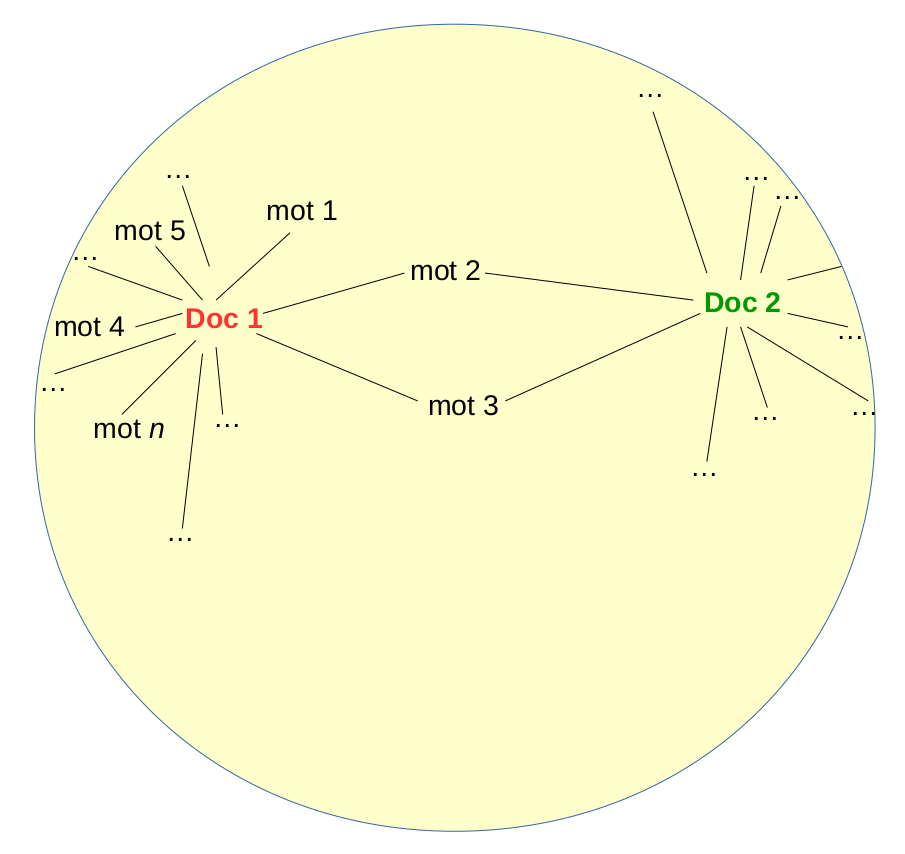
Fig. 51 Un document est représenté par le centre de gravité des vecteurs ESA de ses termes
L’avantage majeur d’ESA est que les dimensions sont interprétables (chaque dimension correspond à un concept précis de Wikipedia) et que les représentations sont indépendantes de la collection applicative. Par ailleurs, un corpus multi-langues comme Wikipedia, où de nombreux concepts (surtout les plus importants) ont des pages dans plusieurs langues, permet de définir des représentations de documents indépendantes de la langue car exprimées comme des vecteurs dans l’espace de ces concepts ; on parle de Cross-language ESA. Deux textes écrits dans des langues différentes peuvent ainsi être directement comparés.
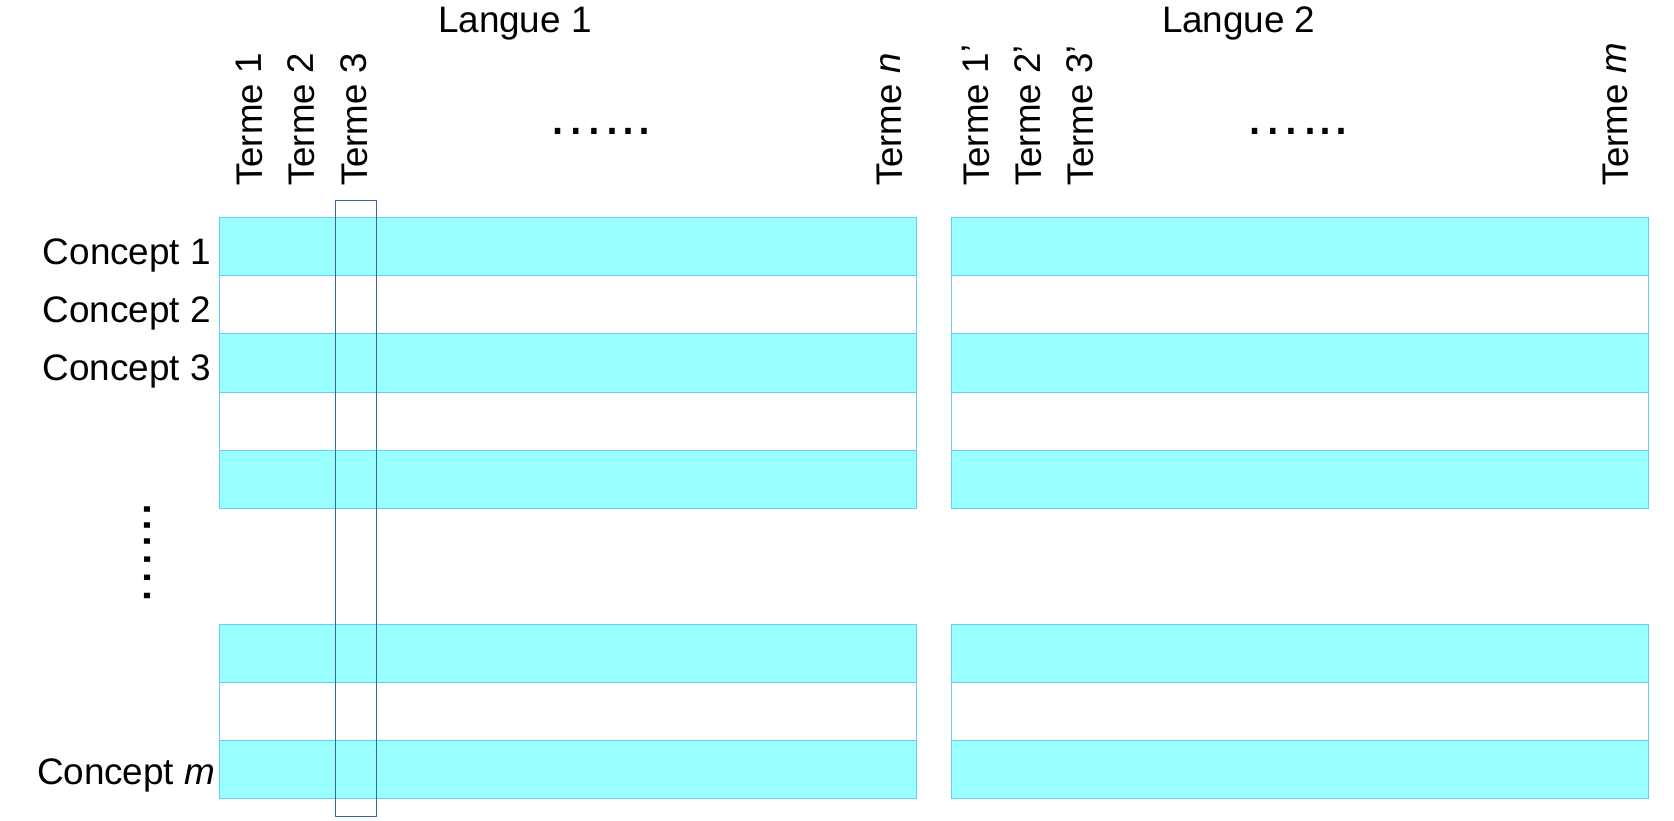
Fig. 52 Cross-language ESA : les représentations dans l’espace des concepts Wikipedia sont indépendantes de la langue
La principale limite d’ESA est le coût de construction et de mise à jour des représentations (Wikipedia évolue constamment), ainsi que les biais inhérents à Wikipedia (surreprésentation de certains domaines, variations importantes d’une langue à une autre).
Plongements lexicaux
Les représentations présentées jusqu’ici considèrent chaque document comme un simple ensemble de termes (« sac de mots » ou bag of words, BoW), sans exploiter l’ordre ni le contexte local des mots dans les phrases. Or, le contexte d’un mot (les mots qui l’entourent) caractérise à la fois son sens et son usage syntaxique. Les plongements lexicaux (word embeddings) exploitent cette information contextuelle pour produire des représentations denses de faible dimension (typiquement 100 à 300).
Word2Vec
Word2Vec ([MCC13], [MSC13]) apprend des représentations vectorielles des mots à partir de grands corpus de textes, selon le principe que des mots qui apparaissent dans des contextes similaires ont des significations similaires (hypothèse distributionnelle).
Deux architectures sont proposées :
Skip-gram : à partir d’un mot cible, prédire les mots du contexte dans une fenêtre de taille \(k\). Plus précisément, étant donnée une séquence de mots \(w_1, w_2, \ldots, w_T\), on cherche à maximiser
\[\frac{1}{T} \sum_{t=1}^{T}\sum_{j=-k}^{k} \log\, p(w_{t+j} \mid w_t)\]où \(k\) est la largeur du contexte autour de chaque mot \(w_t\) et les probabilités conditionnelles sont définies par softmax sur les produits scalaires des vecteurs des mots :
\[p(w_i | w_j ) = \frac{\exp(u_{w_i}^{\top}v_{w_j})}{\sum_{l=1}^{V} \exp(u_l^{\top}v_{w_j})}\]\(V\) étant le nombre de mots du vocabulaire, \(u_{w_i}\) la représentation « de sortie » de \(w_i\) et \(v_{w_j}\) la représentation « d’entrée » de \(w_j\). Le coût du calcul du softmax exact sur un grand vocabulaire est réduit par negative sampling : au lieu de mettre à jour tous les vecteurs, on met à jour ceux du vrai contexte et quelques exemples négatifs.
CBOW (Continuous Bag of Words) : à partir des mots du contexte, prédire le mot central. Plus rapide mais légèrement moins précis que Skip-gram.
Les représentations vectorielles résultantes \(v\) présentent des propriétés d’additivité intéressantes, par exemple :
Les mots sont regroupés par similarité sémantique et syntaxique dans l’espace vectoriel. Ces représentations sont denses et de dimension réduite, à comparer au modèle vectoriel avec pondérations TF-IDF, où les vecteurs sont de très grande dimesion et très creux).
Word2Vec peut représenter seulement les mots présents dans les données d’entraînement. Les mots hors vocabulaire reçoivent un vecteur nul dans les implémentations classiques, ce qui constitue une limite importante.
GloVe
GloVe (Global Vectors, [PSM14]) part du constat que les cooccurrences globales des mots dans des fenêtres de contexte de taille fixe fournissent déjà une information riche. GloVe construit explicitement la matrice de cooccurrences \(X_{ij}\) (nombre de fois où le mot \(j\) apparaît dans le contexte du mot \(i\)), très creuse, puis cherche à rapprocher le produit scalaire des vecteurs représentant les mots (embeddings) du logarithme de leur probabilité de cooccurrence. Les vecteurs obtenus présentent des propriétés similaires aux représentations Word2Vec (analogies, regroupement sémantique), avec de bonnes performances en pratique.
Comme Word2Vec, GloVe est limité aux mots du vocabulaire d’entraînement. Dans SparkNLP, les vecteurs GloVe pour les mots hors vocabulaire sont représentés par des vecteurs nuls, ce qui provoque une perte de performance.
Des modèles pré-entraînés GloVe sont disponibles librement pour l’anglais (6B, 42B et 840B tokens) sur le site du projet.
FastText
FastText ([BGJ17]) résout le problème des mots hors vocabulaire en changeant l”unité de base : au lieu des mots entiers, ce sont les n-grammes de caractères qui sont représentés. La représentation d’un mot est la somme des vecteurs de ses n-grammes. Par exemple, pour le mot « vecteur » les trigrammes (\(n=3\)) sont {vec, ect, cte, teu, eur}.
Cette approche présente plusieurs avantages :
Les mots hors vocabulaire peuvent être représentés par la somme des vecteurs de ses n-grammes, or ces n-grammes ont déjà été rencontrés dans le vocabulaire (si celui-ci est raisonnablement large) et leur vecteur a déjà été calculé. L’hypothèse centrale étant que la sémantique d’un mot peut s’exprimer assez bien en combinant les sémantiques de ses n-grammes de caractères.
Les variantes morphologiques d’un même mot (« apprendre », « apprend », « appris »…) partagent des n-grammes et ont donc des représentations proches.
Le modèle est particulièrement utile pour des langues à morphologie riche (arabe, finnois, turc) et pour des textes contenant des fautes d’orthographe.
FastText est disponible en pré-entraîné pour plus de 150 langues sur le site officiel.
Limites des plongements statiques
Word2Vec, GloVe et FastText produisent une représentation unique pour chaque mot, indépendamment de son contexte. Le mot « avocat », par exemple, aura le même vecteur, qu’il désigne un fruit ou une personne qui pratique un certain métier juridique. Cette limitation est problématique pour des tâches où la désambiguïsation est importante.
Les méthodes contextuelles produisent en revanche une représentation différente pour chaque occurrence d’un mot dans son contexte particulier. ELMo utilise des réseaux LSTM bidirectionnels ; BERT et GPT utilisent des architectures de type transformer. Ces méthodes seront abordées en détail dans la séance suivante.
Représentations de phrases et de documents
Les plongements lexicaux produisent des représentations pour les mots individuels. Afin de représenter des phrases ou des documents entiers, plusieurs stratégies existent.
Agrégation de vecteurs de mots
La solution la plus simple est le centre de gravité des vecteurs des mots du texte, après suppression des stop words et éventuellement pondération par TF-IDF. Cette approche est :
adaptée pour les textes courts (< 10-15 termes) avec des plongements non contextuels comme GloVe ou FastText (vocabulaire prédéfini et fixe) ;
à éviter pour les textes longs : le centre de gravité d’un grand nombre de vecteurs devient peu spécifique.
Dans SparkNLP, SentenceEmbeddings implémente cette agrégation avec différentes stratégies (moyenne, somme).
Environnements logiciels
Plusieurs suites sont disponibles pour les opérations de traitement de texte :
SparkNLP (John Snow Labs) : bien intégrée à Spark ML, propose tokenisation, étiquetage, lemmatisation, extraction d’entités nommées, analyse de sentiments, modèles pré-entraînés pour de nombreuses langues et même des domaines spécifiques. Nous l’employons dans les séances de travaux pratiques.
spaCy : bibliothèque Python très populaire, réputée facile d’emploi, avec des modèles pré-entraînés pour de nombreuses langues.
Stanford CoreNLP : suite Java, principalement pour l’anglais, l’espagnol et le chinois.
Spark intègre également des outils natifs : construction et manipulation de représentations TF-IDF (HashingTF, IDF), sélection de termes par test du \(\chi^2\) (ChiSqSelector), LDA (LDA, DistributedLDAModel), Word2Vec (Word2Vec, Word2VecModel).
Bojanowski, P., E. Grave, A. Joulin, and T. Mikolov. Enriching word vectors with subword information. Transactions of the Association for Computational Linguistics, 5:135–146, 2017.
Blei, D. M., A. Y. Ng, and M. I. Jordan. Latent Dirichlet allocation. Journal of Machine Learning Research, 3:993–1022, 2003.
Deerwester, S. C., S. T. Dumais, T. K. Landauer, G. W. Furnas, and R. A. Harshman. Indexing by latent semantic analysis. JASIS, 41(6):391–407, 1990.
Gabrilovich, E. and S. Markovitch. Computing semantic relatedness using Wikipedia-based explicit semantic analysis. In Proc. 20th IJCAI, pages 1606–1611, 2007.
Mikolov, T., K. Chen, G. Corrado, and J. Dean. Efficient estimation of word representations in vector space. CoRR, abs/1301.3781, 2013.
Mikolov, T., I. Sutskever, K. Chen, G. S. Corrado, and J. Dean. Distributed representations of words and phrases and their compositionality. In Advances in Neural Information Processing Systems 26, pages 3111–3119, 2013.
Pennington, J., R. Socher, and C. D. Manning. GloVe: Global vectors for word representation. In EMNLP, pages 1532–1543, 2014.
Robertson, S. and H. Zaragoza. The probabilistic relevance framework: BM25 and beyond. Found. Trends Inf. Retr., 3(4):333–389, 2009.
Salton, G. and M. J. McGill. Introduction to Modern Information Retrieval. McGraw-Hill, 1986.