Travaux pratiques - Détection et correction des disparités
Ce TP est prévu pour être réalisé en deux séances successives. Lors de la seconde séance il est indispensable d’exécuter à nouveau le code de la première séance pour que toutes les structures de données nécessaires soient disponibles.
Références externes utiles :
L’objectif de cette séance de TP est d’illustrer, à travers un exemple issu de données réelles, la problématique de la détection des inéquités (des disparités) présentes dans les prédictions des modèles. La seconde séance de TP sur l’équité (séance 15) s’intéresse à la correction de ces inéquités.
Récupération des données
Nous travaillerons sur les données Adult de la base UCI. Ces données ont été employées pour prédire si le revenu annuel d’un individu dépasse 50 k$ (en 1996). Consultez ce site pour une description des variables présentes.
Pour préparer les répertoires et télécharger les données, ouvrez une fenêtre terminal et entrez les commandes suivantes :
%%bash
mkdir -p tpEquite/data
wget -nc http://cedric.cnam.fr/vertigo/Cours/RCP216/docs/adult.csv -P tpEquite/data/
pyspark
Sous Windows, créez le répertoire tpEquite et le sous-répertoire data, téléchargez le fichier de données dans le sous-répertoire data, ouvrez une fenêtre invite de commandes et lancez pyspark.
Pré-traitement et examen des données
Nous utilisons la bibliothèque Pandas pour lire et pré-traiter les données avant de les transférer dans un DataFrame Spark.
import pandas as pd
import numpy as np
pandasDF = pd.read_csv('tpEquite/data/adult.csv')
pandasDF.head()
Quelles sont les variables présentes :
pandasDF.columns
Remplacer le symbole ? utilisé pour les valeurs manquantes du fichier d’origine par np.nan :
pandasDF[pandasDF == '?'] = np.nan
pandasDF.info()
Les seules variables qui présentent des valeurs manquantes sont les variables nominales workclass, occupation et native.country. Nous estimons les valeurs manquantes par le mode (la valeur la plus fréquente) de chaque variable :
for col in ['workclass', 'occupation', 'native.country']:
    pandasDF[col].fillna(pandasDF[col].mode()[0], inplace=True)

pandasDF.info()
Question
Pouvons-nous faire la même opération directement dans Spark ? Regardez la documentation.
Correction
Oui, comme indiqué dans la documentation de Imputer de l’API Spark en Python. Il faudra convertir d’abord le dataframe Pandas en DataFrame Spark (voir plus loin).
Affichage de statistiques simples :
pandasDF.describe().T
Conversion du dataframe Pandas en DataFrame Spark (les noms de colonnes contenant un point sont renommés) :
columns = {"education.num": "educationnum",
           "marital.status": "maritalstatus",
           "capital.gain": "capitalgain",
           "capital.loss": "capitalloss",
           "hours.per.week": "hoursperweek",
           "native.country": "nativecountry"}
sparkDF = spark.createDataFrame(pandasDF)

for key, value in columns.items():
    sparkDF = sparkDF.withColumnRenamed(key, value)

sparkDF.printSchema()
sparkDF.show()
Formulation du problème et analyse des disparités présentes
Les données Adult ont été employées pour prédire si le revenu annuel d’un individu dépasse 50 k$ ou non. Afin de situer ces données dans un contexte d’analyse des disparités, nous considérerons qu’une institution financière cherche à développer un outil d’aide à la décision qui vise à prédire si un prêt serait remboursé ou non, en s’appuyant sur les données Adult : la variable income observée est assimilée au remboursement du prêt (income \(\geq 50k\$\) \(\leftrightarrow\) remboursement, income \(< 50k\$\) \(\leftrightarrow\) défaut) ; la valeur prédite par le modèle sert à prendre la décision d’accorder ou non le prêt.
Les variables génériques du cours correspondent à :
\(X\) : variables prédictives employées dans la modélisation ;
\(A\) : attribut protégé (ne doit pas avoir d’impact sur la prise de décision) ;
\(Y\) : variable cible, ici remboursement ou défaut (binaire) ;
\(\hat{Y}\) ou \(R\) : prédiction du modèle (binaire ou score).
Question
Parmi les variables présentes dans les données, lesquelles sont protégées suivant l”Equal Credit Opportunity Act (ECOA) ?
Correction
Les variables protégées suivant ECOA présentes dans les données Adult sont : age, maritalstatus, race, sex, nativecountry.
Nous faisons d’abord l’importation des bibliothèques nécessaires et l’indexation des variables nominales (chaque modalité est représentée par une valeur entière) :
from pyspark.ml.feature import VectorAssembler
from pyspark.ml.feature import StringIndexer, VectorIndexer
from pyspark.ml.classification import GBTClassifier
from pyspark.ml import Pipeline
from pyspark.ml.evaluation import MulticlassClassificationEvaluator
# Variables nominales
stringColumns = [c for c, t in sparkDF.dtypes if t.startswith('string')]
print(stringColumns)
# Indexation des variables nominales
for strCol in stringColumns:
    labelIndexer = StringIndexer(inputCol=strCol,
                                 outputCol='indexed'+strCol).fit(sparkDF)
    sparkDF = labelIndexer.transform(sparkDF)

sparkDF.printSchema()
Note
Ce type de codage (valeur entière par modalité) convient pour les méthodes à base d’arbres de décision (GBT, forêts aléatoires). Pour des méthodes comme les SVM ou les réseaux de neurones, il faudrait utiliser un codage one-hot.
Disparités dans les données
Avant d’examiner les disparités présentes dans les prédictions des modèles, regardons si des disparités sont présentes dans les données de départ, en examinant le taux de « positifs » (income >= 50k) pour les différentes valeurs des attributs protégés.
Pour l’attribut protégé sex :
sparkDF.groupBy("sex").count().show()
sparkDF.groupBy("sex").avg("indexedincome").show()
Question
La variable cible \(Y\) est-elle indépendante de l’attribut protégé sex ? Qu’est-ce que cela implique pour la satisfiabilité simultanée des critères d’équité ?
Correction
Non, le taux de income >= 50k est nettement différent pour Male et Female. C’est la situation habituelle (\(Y \not\!\perp\!\!\!\perp A\)), dans laquelle les critères d’indépendance, de séparation et de suffisance ne peuvent pas être satisfaits simultanément de façon stricte (voir le cours).
Pour l’attribut protégé race :
sparkDF.groupBy("race").count().show()
sparkDF.groupBy("race").avg("indexedincome").show()
Question
Examinez la relation entre la variable cible \(Y\) et chacun des attributs protégés maritalstatus et nativecountry. Que faudrait-il faire pour pouvoir traiter de la même façon la variable continue age ?
Correction
sparkDF.groupBy("maritalstatus").count().show()
sparkDF.groupBy("maritalstatus").avg("indexedincome").show()
sparkDF.groupBy("nativecountry").count().show()
sparkDF.groupBy("nativecountry").avg("indexedincome").show()
Pour age il est possible de définir des intervalles avec Bucketizer ou QuantileDiscretizer.
Modèle obtenu avec tous les attributs
Nous considérons d’abord un modèle prédictif obtenu avec toutes les variables, qui sera ensuite comparé à un modèle obtenu en excluant les variables protégées suivant ECOA.
featureAssemblerFull = VectorAssembler(
    inputCols=['age', 'indexedworkclass', 'fnlwgt',
               'indexededucation', 'educationnum',
               'indexedmaritalstatus', 'indexedoccupation',
               'indexedrelationship', 'indexedrace',
               'indexedsex', 'capitalgain', 'capitalloss',
               'hoursperweek', 'indexednativecountry'],
    outputCol='indexedFeaturesAll')
sparkDFassembledFull = featureAssemblerFull.transform(sparkDF)

(trainingDataFull, testDataFull) = sparkDFassembledFull.randomSplit([0.7, 0.3], 100)
La méthode Gradient Boosted Trees (GBT) est choisie car elle permet de mélanger directement variables quantitatives et nominales. Noter maxBins=42, nécessaire car la variable indexednativecountry possède 42 modalités.
gbt = GBTClassifier(labelCol="indexedincome", featuresCol="indexedFeaturesAll",
                    maxIter=100, maxBins=42)
pipeline = Pipeline(stages=[gbt])
fullGBTmodel = pipeline.fit(trainingDataFull)
predictionsFull = fullGBTmodel.transform(testDataFull)
evaluatorFull = MulticlassClassificationEvaluator(
    labelCol="indexedincome", predictionCol="prediction", metricName="accuracy")
accuracyFull = evaluatorFull.evaluate(predictionsFull)
print("Test accuracy with all features = %g" % (accuracyFull))
Modèle obtenu avec les seuls attributs ECOA-compatibles
Considérons maintenant un modèle développé sans les variables protégées par ECOA (donc sans age, maritalstatus, race, sex, nativecountry) :
featureAssemblerECOA = VectorAssembler(
    inputCols=['indexedworkclass', 'fnlwgt',
               'indexededucation', 'educationnum',
               'indexedoccupation', 'indexedrelationship',
               'capitalgain', 'capitalloss', 'hoursperweek'],
    outputCol='indexedFeaturesECOA')
sparkDFassembledECOA = featureAssemblerECOA.transform(sparkDF)

(trainingDataECOA, testDataECOA) = sparkDFassembledECOA.randomSplit([0.7, 0.3], 100)
gbt = GBTClassifier(labelCol="indexedincome", featuresCol="indexedFeaturesECOA",
                    maxIter=100, maxBins=42)
pipeline = Pipeline(stages=[gbt])
ecoaGBTmodel = pipeline.fit(trainingDataECOA)
predictionsECOA = ecoaGBTmodel.transform(testDataECOA)
evaluatorECOA = MulticlassClassificationEvaluator(
    labelCol="indexedincome", predictionCol="prediction", metricName="accuracy")
accuracyECOA = evaluatorECOA.evaluate(predictionsECOA)
print("Test accuracy with ECOA-complying features = %g" % (accuracyECOA))
On constate que la performance (accuracy) est proche de celle du modèle qui utilise toutes les variables.
Analyse des disparités
Examinons maintenant les disparités présentes dans les prédictions des deux modèles. Nous nous intéressons à deux critères observationnels :
Le critère d’indépendance (demographic parity) : la prédiction \(\hat{Y}\) est-elle indépendante de \(A\) ? Le taux de prédits positifs est-il le même pour toutes les valeurs de l’attribut protégé ?
Le critère de séparation (equalized odds) : la prédiction \(\hat{Y}\) est-elle indépendante de \(A\) conditionnellement à \(Y\) ? Y a-t-il le même taux de vrais positifs et le même taux de faux positifs pour toutes les valeurs de l’attribut protégé ?
Critère d’indépendance
Examinons le critère d’indépendance à travers le taux de parité démographique (rapport entre les taux de prédits positifs pour les différentes valeurs de l’attribut protégé) : si la parité était respectée, ce rapport devrait être égal à 1.
print("Disparités dans les données de test (indépendance entre A et Y) ?")
predictionsFull.groupBy("sex").avg("indexedincome").show()

print("Parité démographique — modèle avec toutes les variables :")
predictionsFull.groupBy("sex").avg("prediction").show()
pF = predictionsFull.groupBy("sex").avg("prediction").toPandas()
print("Taux de parité démographique (toutes variables) :",
      pF['avg(prediction)'][0] / pF['avg(prediction)'][1])

print("Parité démographique — modèle ECOA :")
predictionsECOA.groupBy("sex").avg("prediction").show()
pE = predictionsECOA.groupBy("sex").avg("prediction").toPandas()
print("Taux de parité démographique (ECOA) :",
      pE['avg(prediction)'][0] / pE['avg(prediction)'][1])
Aucun des deux modèles ne respecte la parité démographique. L’exclusion des attributs protégés n’améliore pas significativement le taux de parité démographique ici.
Critère de séparation
Pour le critère equalized odds nous calculons les taux de faux positifs (TFP) et de vrais positifs (TVP) pour chaque modalité de l’attribut protégé sex.
Pour le modèle qui emploie toutes les variables :
predictionAndLabelsM = predictionsFull.filter(predictionsFull.sex == 'Male') \
                                      .select('prediction', 'indexedincome')
predictionAndLabelsMnegs = predictionAndLabelsM.filter(predictionAndLabelsM.indexedincome == 0.0)
predictionAndLabelsMpos  = predictionAndLabelsM.filter(predictionAndLabelsM.indexedincome == 1.0)
fprM = predictionAndLabelsMnegs.filter(predictionAndLabelsMnegs.prediction == 1.0).count() \
       / predictionAndLabelsMnegs.count()
tprM = predictionAndLabelsMpos.filter(predictionAndLabelsMpos.prediction == 1.0).count() \
       / predictionAndLabelsMpos.count()
print("Taux de faux positifs pour Male =", fprM)
print("Taux de vrais positifs pour Male =", tprM)

predictionAndLabelsF = predictionsFull.filter(predictionsFull.sex == 'Female') \
                                      .select('prediction', 'indexedincome')
predictionAndLabelsFnegs = predictionAndLabelsF.filter(predictionAndLabelsF.indexedincome == 0.0)
predictionAndLabelsFpos  = predictionAndLabelsF.filter(predictionAndLabelsF.indexedincome == 1.0)
fprF = predictionAndLabelsFnegs.filter(predictionAndLabelsFnegs.prediction == 1.0).count() \
       / predictionAndLabelsFnegs.count()
tprF = predictionAndLabelsFpos.filter(predictionAndLabelsFpos.prediction == 1.0).count() \
       / predictionAndLabelsFpos.count()
print("Taux de faux positifs pour Female =", fprF)
print("Taux de vrais positifs pour Female =", tprF)
On constate que les TFP et TVP sont différents pour Male et Female : le critère equalized odds n’est pas respecté.
Visualisation dans le repère des courbes ROC (en abscisse le TFP, en ordonnée le TVP) :
import matplotlib.pyplot as plt
plt.title('Modèle qui emploie toutes les variables')
plt.xlabel('Taux de faux positifs')
plt.ylabel('Taux de vrais positifs')
plt.scatter(fprM, tprM, label='Male')
plt.scatter(fprF, tprF, label='Female')
plt.plot([0.0, 1.0], [0.0, 1.0], 'k--')
plt.legend()
Le résultat devrait ressembler à :
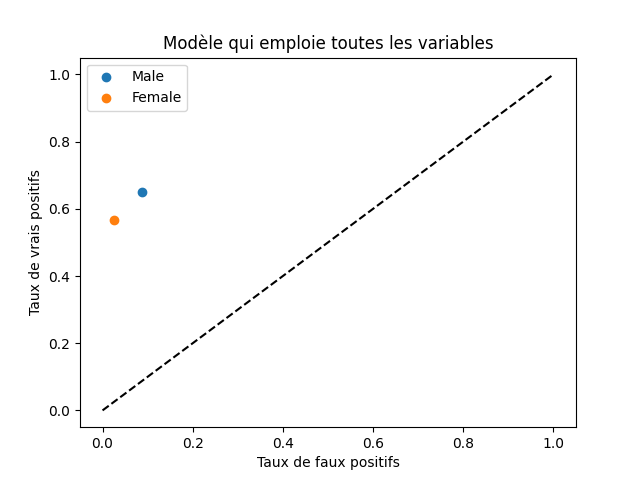
Fig. 113 Points dans le diagramme ROC pour le modèle qui emploie toutes les variables
Pour le modèle ECOA (sans les attributs protégés) :
predictionAndLabelsM = predictionsECOA.filter(predictionsECOA.sex == 'Male') \
                                      .select('prediction', 'indexedincome')
predictionAndLabelsMnegs = predictionAndLabelsM.filter(predictionAndLabelsM.indexedincome == 0.0)
nM  = predictionAndLabelsMnegs.count()
fpM_0 = predictionAndLabelsMnegs.filter(predictionAndLabelsMnegs.prediction == 1.0).count()
predictionAndLabelsMpos  = predictionAndLabelsM.filter(predictionAndLabelsM.indexedincome == 1.0)
pM  = predictionAndLabelsMpos.count()
tpM_0 = predictionAndLabelsMpos.filter(predictionAndLabelsMpos.prediction == 1.0).count()
fprM_0 = fpM_0 / nM
tprM_0 = tpM_0 / pM
print("Taux de faux positifs pour Male =", fprM_0)
print("Taux de vrais positifs pour Male =", tprM_0)

predictionAndLabelsF = predictionsECOA.filter(predictionsECOA.sex == 'Female') \
                                      .select('prediction', 'indexedincome')
predictionAndLabelsFnegs = predictionAndLabelsF.filter(predictionAndLabelsF.indexedincome == 0.0)
nF  = predictionAndLabelsFnegs.count()
fpF_0 = predictionAndLabelsFnegs.filter(predictionAndLabelsFnegs.prediction == 1.0).count()
predictionAndLabelsFpos  = predictionAndLabelsF.filter(predictionAndLabelsF.indexedincome == 1.0)
pF  = predictionAndLabelsFpos.count()
tpF_0 = predictionAndLabelsFpos.filter(predictionAndLabelsFpos.prediction == 1.0).count()
fprF_0 = fpF_0 / nF
tprF_0 = tpF_0 / pF
print("Taux de faux positifs pour Female =", fprF_0)
print("Taux de vrais positifs pour Female =", tprF_0)
plt.title('Modèle qui emploie les variables ECOA')
plt.xlabel('Taux de faux positifs')
plt.ylabel('Taux de vrais positifs')
plt.scatter(fprM_0, tprM_0, label='Male')
plt.scatter(fprF_0, tprF_0, label='Female')
plt.plot([0.0, 1.0], [0.0, 1.0], 'k--')
plt.legend()
Le résultat devrait ressembler à :
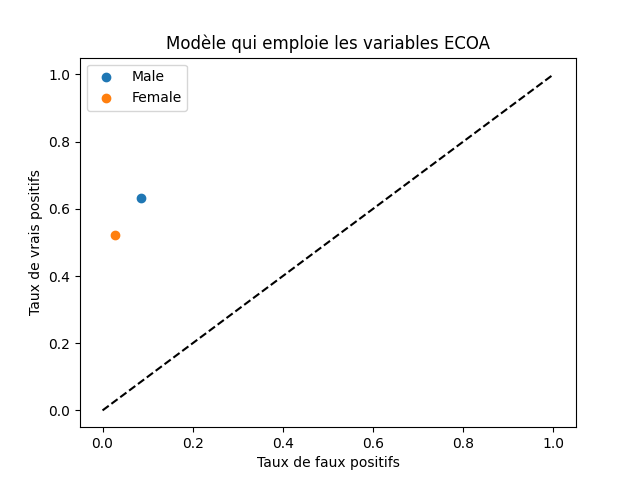
Fig. 114 Points dans le diagramme ROC pour le modèle qui emploie les variables ECOA
On constate que ni le modèle avec toutes les variables, ni le modèle ECOA, ne respectent le critère *equalized odds*. L’exclusion des attributs protégés ne suffit pas à garantir le respect des critères observationnels d’équité.
Question (bilan)
Comment expliquer que le modèle ECOA, qui n’utilise pas les attributs protégés, ne respecte pas non plus le critère equalized odds ? Quelles sont les deux explications possibles évoquées dans le cours ?
Correction
Deux mécanismes peuvent expliquer cela : (1) l’action par l’intermédiaire de variables proxy (les variables utilisées sont corrélées aux variables protégées) ; (2) l’action par l’intermédiaire de corrélations cumulées : chaque variable est peu corrélée à l’attribut protégé, mais leur combinaison permet de le prédire assez bien. La section suivante du TP (séance 15) explore précisément cette deuxième possibilité.
Pouvons-nous prédire des attributs protégés à partir des autres ?
Nous avons constaté lors de la séance précédente que l’exclusion des attributs protégés ne suffit pas à garantir le respect des critères observationnels d’équité. Une explication possible est que les attributs restants permettent de prédire implicitement les attributs protégés, même en l’absence de proxy évident. Le cours a présenté comment cumuler un nombre suffisant de variables légèrement corrélées à l’attribut protégé peut permettre de le prédire assez bien (voir la figure figMultiProxies du cours).
Examinons dans quelle mesure il est possible de prédire la valeur de l’attribut protégé race à partir des seuls attributs compatibles ECOA. Dans Spark, GBT est implémenté seulement pour la classification binaire ; nous utiliserons donc une forêt aléatoire (random forest) pour ce problème multi-classes.
from pyspark.ml.feature import VectorAssembler
from pyspark.ml.classification import RandomForestClassifier
from pyspark.ml import Pipeline
from pyspark.ml.evaluation import MulticlassClassificationEvaluator

featureAssemblerRPred = VectorAssembler(
    inputCols=['indexedworkclass', 'fnlwgt',
               'indexededucation', 'educationnum',
               'indexedoccupation', 'indexedrelationship',
               'capitalgain', 'capitalloss', 'hoursperweek'],
    outputCol='indexedFeaturesRPred')
sparkDFassembledRPred = featureAssemblerRPred.transform(sparkDF)
(trainingDataRPred, testDataRPred) = sparkDFassembledRPred.randomSplit([0.7, 0.3], 100)
rfc = RandomForestClassifier(labelCol="indexedrace", featuresCol="indexedFeaturesRPred",
                             numTrees=100, maxBins=42)
pipeline = Pipeline(stages=[rfc])
rPredRFmodel = pipeline.fit(trainingDataRPred)
predictionsRPred = rPredRFmodel.transform(testDataRPred)
evaluatorRPred = MulticlassClassificationEvaluator(
    labelCol="indexedrace",
    predictionCol="prediction",
    metricName="accuracy")
accuracyRPred = evaluatorRPred.evaluate(predictionsRPred)
print("Accuracy pour la prédiction de 'race' à partir des variables ECOA = %g" % (accuracyRPred))
Question
Comment interpréter ces résultats ? L’attribut race possède 5 modalités dans ces données. Comparez l”accuracy obtenue à celle d’un classifieur naïf (qui prédit toujours la classe majoritaire).
Correction
L’attribut protégé race possède 5 modalités avec des effectifs très déséquilibrés (la modalité « White » représente environ 85 % des données). L”accuracy d’un classifieur naïf qui prédit toujours « White » est déjà d’environ 0.85. Une accuracy de 0.76 en apparence moins bonne que ce classifieur naïf peut sembler décevante, mais il faut noter que la forêt aléatoire a appris avec les variables ECOA seulement (sans race) et que la modalité « White » étant dominante, le problème est très déséquilibré. Une métrique plus informative (ex. macro F1-score) confirmerait l’apprentissage réel d’une association entre les variables ECOA et race.
Question
Dans quelle mesure peut-on prédire l’attribut protégé sex à partir des attributs conformes ECOA ? sex étant binaire, GBT peut être utilisé à nouveau.
Correction
from pyspark.ml.classification import GBTClassifier

featureAssemblerSPred = VectorAssembler(
    inputCols=['indexedworkclass', 'fnlwgt',
               'indexededucation', 'educationnum',
               'indexedoccupation', 'indexedrelationship',
               'capitalgain', 'capitalloss', 'hoursperweek'],
    outputCol='indexedFeaturesSPred')
sparkDFassembledSPred = featureAssemblerSPred.transform(sparkDF)
(trainingDataSPred, testDataSPred) = sparkDFassembledSPred.randomSplit([0.7, 0.3], 100)
gbt = GBTClassifier(labelCol="indexedsex", featuresCol="indexedFeaturesSPred",
                    maxIter=100, maxBins=42)
pipeline = Pipeline(stages=[gbt])
sPredmodel = pipeline.fit(trainingDataSPred)
predictionsSPred = sPredmodel.transform(testDataSPred)
evaluatorSPred = MulticlassClassificationEvaluator(
    labelCol="indexedsex", predictionCol="prediction", metricName="accuracy")
accuracySPred = evaluatorSPred.evaluate(predictionsSPred)
print("Accuracy pour la prédiction de 'sex' à partir des variables ECOA = %g" % (accuracySPred))
Une accuracy nettement supérieure à 50 % (la proportion de la classe majoritaire) confirme que les variables ECOA permettent de prédire en partie l’attribut protégé sex, ce qui explique en partie les disparités observées dans les prédictions du modèle ECOA.
Réduction ou suppression des disparités dans un modèle
Nous présentons maintenant une méthode de post-traitement qui permet d’obtenir un modèle qui respecte le critère de séparation (equalized odds) à partir d’un modèle initial qui ne le respecte pas. La méthode a été proposée dans [HPS16] et cherche à maximiser la performance (accuracy) du modèle corrigé. Elle est générale : elle s’applique à un modèle qui fait des prédictions binaires, sans accès aux données d’apprentissage ni à la procédure d’apprentissage.
Rappel du principe
Pour le modèle ECOA initial, les TFP et TVP sont différents pour Male et Female. Pour corriger :
Pour
Female(groupe défavorisé) : on convertit aléatoirement une proportion \(propChangeF\) des prédictions négatives (0) en prédictions positives (1), ce qui augmente le TFP et le TVP pour ce groupe.Pour
Male(groupe favorisé) : on convertit aléatoirement une proportion \(propChangeM\) des prédictions positives (1) en prédictions négatives (0), ce qui réduit le TFP et le TVP pour ce groupe.
Le point cible [fpr, tpr] commun aux deux groupes est le point du domaine admissible le plus éloigné de la diagonale du diagramme ROC (performance maximale sous contrainte d”equalized odds).
Visualisation du domaine admissible
La région admissible est l’intersection de deux triangles définis dans le diagramme ROC par les points du modèle initial pour chaque groupe et les coins [0,0] et [1,1] :
import matplotlib.pyplot as plt
plt.title('Modèle qui emploie les variables ECOA')
plt.xlabel('Taux de faux positifs')
plt.ylabel('Taux de vrais positifs')
plt.fill([0.0, fprM_0, 1.0], [0.0, tprM_0, 1.0], label='Male',   color="r", alpha=0.2)
plt.fill([0.0, fprF_0, 1.0], [0.0, tprF_0, 1.0], label='Female', color="b", alpha=0.2)
plt.legend(loc='lower right')
Le résultat devrait ressembler à :
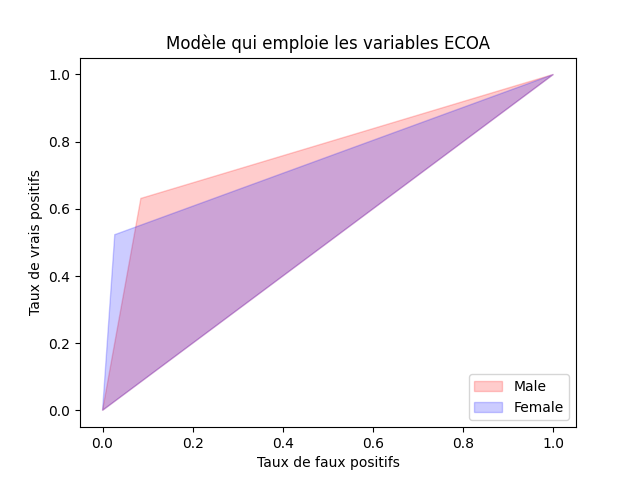
Fig. 115 Région admissible (intersection des deux zones colorées) pour le modèle ECOA
Recherche du point cible par optimisation linéaire
Dans le cas général, trouver le point optimal dans le domaine admissible revient à résoudre un problème d’optimisation linéaire avec linprog de Scipy.
Le problème se formule ainsi dans le plan [TFP, TVP] : on cherche le point \(\mathbf{x} = [\text{fpr}, \text{tpr}]\) qui minimise \(\mathbf{c}^T \mathbf{x}\) avec \(\mathbf{c} = [1, -1]\) (vecteur dirigé vers le coin bas à droite, donc minimiser \(\mathbf{c}^T\mathbf{x}\) revient à maximiser tpr - fpr, c’est-à-dire s’éloigner de la diagonale), sous les contraintes de rester dans le domaine admissible.
import numpy as np
from scipy.optimize import linprog

c = np.array([1.0, -1.0])
A = np.array([[-1.0, -1.0],
              [1.0 - fprM_0, 1.0 - tprM_0],
              [1.0 - fprF_0, 1.0 - tprF_0],
              [fprM_0, tprM_0],
              [fprF_0, tprF_0]])
Rm90 = np.array([[0.0, -1.0], [1.0, 0.0]])    # rotation +90°
A_ub = (Rm90.dot(A.transpose())).transpose()
penteM = (1.0 - tprM_0) / (1.0 - fprM_0)
penteF = (1.0 - tprF_0) / (1.0 - fprF_0)
b_ub = [0.0, 1 - penteM, 1 - penteF, 0.0, 0.0]
bounds = (0.0, 1.0)

res = linprog(c=c, A_ub=A_ub, b_ub=b_ub, bounds=bounds)
print(res.x, res.fun, res.message)
fpr, tpr = res.x[0], res.x[1]
Dans notre cas précis, ce point optimal est l’intersection entre les droites [(0;0)–(fprM;tprM)] et [(fprF;tprF)–(1;1)]. Nous pouvons également utiliser directement l’algèbre linéaire pour trouver ce point d’intersection, en résolvant le système :
où \(a\) est la pente de la droite [(0;0)–(fprM;tprM)] et \(b\) la pente de la droite [(fprF;tprF)–(1;1)] :
penteDiM = tprM_0 / fprM_0                    # pente a
penteDiF = (1.0 - tprF_0) / (1.0 - fprF_0)   # pente b
lignes = np.array([[penteDiM, -1.0],
                   [penteDiF, -1.0]])
intersection = np.linalg.solve(lignes, np.array([0.0, penteDiF - 1]))
fpr = intersection[0]
tpr = intersection[1]
print("Cible pour le modèle : TFP =", fpr, ", TVP =", tpr)
Visualisation du point cible :
plt.title('Modèle qui emploie les variables ECOA')
plt.xlabel('Taux de faux positifs')
plt.ylabel('Taux de vrais positifs')
plt.plot([0.0, fprM_0, 1.0], [0.0, tprM_0, 1.0], label='Male')
plt.plot([0.0, fprF_0, 1.0], [0.0, tprF_0, 1.0], label='Female')
plt.scatter([fpr], [tpr], color='black', zorder=5, label='Cible')
plt.legend(loc='lower right')
Le résultat devrait ressembler à :

Fig. 116 Droites reliant les points du modèle initial aux coins du diagramme ROC, et point cible (intersection)
Calcul des taux de conversion
Une fois le point cible [fpr, tpr] trouvé, nous calculons les proportions de prédictions à modifier dans chaque groupe :
Pour
Female: proportion \(propChangeF\) des prédictions négatives (0) à convertir en positives (1) ;Pour
Male: proportion \(propChangeM\) des prédictions positives (1) à convertir en négatives (0).
numFtestECOA = testDataECOA.filter(testDataECOA.sex == 'Female').count()
pnF_0 = numFtestECOA - (fpF_0 + tpF_0)
pnF_1 = numFtestECOA - ((fpr * fpF_0) / fprF_0 + (tpr * tpF_0) / tprF_0)
propChangeF = (pnF_0 - pnF_1) / pnF_0
print("propChangeF:", propChangeF)

ppM_0 = fpM_0 + tpM_0
ppM_1 = (fpr * fpM_0) / fprM_0 + (tpr * tpM_0) / tprM_0
propChangeM = (ppM_0 - ppM_1) / ppM_0
print("propChangeM:", propChangeM)
Application de la correction par randomisation
Pour obtenir le modèle corrigé, nous appliquons la randomisation au modèle GBT ECOA en fonction de la valeur de l’attribut protégé sex et d’un tirage aléatoire dans [0,1) :
from pyspark.sql.functions import rand, when

# Ajout des colonnes de prédiction corrigée et de valeur aléatoire
predictionsECOAadj = predictionsECOA \
    .withColumn("correctedPrediction", predictionsECOA.prediction) \
    .withColumn("random01", rand(seed=10))

# Randomisation Female : propChangeF des prédictions 0 → 1
# (accès obligatoire à l'attribut protégé !)
predictionsECOAadj = predictionsECOAadj.withColumn(
    "correctedPrediction",
    when((predictionsECOAadj.sex == 'Female') &
         (predictionsECOAadj.prediction == 0.0) &
         (predictionsECOAadj.random01 < propChangeF), 1.0)
    .otherwise(predictionsECOAadj.correctedPrediction))

# Randomisation Male : propChangeM des prédictions 1 → 0
# (accès obligatoire à l'attribut protégé !)
predictionsECOAadj = predictionsECOAadj.withColumn(
    "correctedPrediction",
    when((predictionsECOAadj.sex == 'Male') &
         (predictionsECOAadj.prediction == 1.0) &
         (predictionsECOAadj.random01 < propChangeM), 0.0)
    .otherwise(predictionsECOAadj.correctedPrediction))

print("Nombre de prédictions modifiées :",
      predictionsECOAadj.filter(
          predictionsECOAadj.prediction != predictionsECOAadj.correctedPrediction).count())

evaluatorECOAadj = MulticlassClassificationEvaluator(
    labelCol="indexedincome", predictionCol="correctedPrediction", metricName="accuracy")
accuracyECOAadj = evaluatorECOAadj.evaluate(predictionsECOAadj)
print("Accuracy avant correction =", accuracyECOA)
print("Accuracy après correction =", accuracyECOAadj)
La performance (accuracy) diminue suite à la correction par randomisation, mais cette diminution est faible dans notre exemple.
Vérification de l’effet de la correction
Calculons maintenant les TFP et TVP après correction :
predictionAndLabels = predictionsECOAadj.select('correctedPrediction', 'indexedincome')
predictionAndLabelsNegs = predictionAndLabels.filter(predictionAndLabels.indexedincome == 0.0)
n  = predictionAndLabelsNegs.count()
fp = predictionAndLabelsNegs.filter(predictionAndLabelsNegs.correctedPrediction == 1.0).count()
predictionAndLabelsPos = predictionAndLabels.filter(predictionAndLabels.indexedincome == 1.0)
p  = predictionAndLabelsPos.count()
tp = predictionAndLabelsPos.filter(predictionAndLabelsPos.correctedPrediction == 1.0).count()
fprAdj = fp / n
tprAdj = tp / p

predictionAndLabelsM = predictionsECOAadj.filter(predictionsECOA.sex == 'Male') \
                                         .select('correctedPrediction', 'indexedincome')
predictionAndLabelsMnegs = predictionAndLabelsM.filter(predictionAndLabelsM.indexedincome == 0.0)
nM  = predictionAndLabelsMnegs.count()
fpM = predictionAndLabelsMnegs.filter(predictionAndLabelsMnegs.correctedPrediction == 1.0).count()
predictionAndLabelsMpos  = predictionAndLabelsM.filter(predictionAndLabelsM.indexedincome == 1.0)
pM  = predictionAndLabelsMpos.count()
tpM = predictionAndLabelsMpos.filter(predictionAndLabelsMpos.correctedPrediction == 1.0).count()
fprM = fpM / nM
tprM = tpM / pM

predictionAndLabelsF = predictionsECOAadj.filter(predictionsECOA.sex == 'Female') \
                                         .select('correctedPrediction', 'indexedincome')
predictionAndLabelsFnegs = predictionAndLabelsF.filter(predictionAndLabelsF.indexedincome == 0.0)
nF  = predictionAndLabelsFnegs.count()
fpF = predictionAndLabelsFnegs.filter(predictionAndLabelsFnegs.correctedPrediction == 1.0).count()
predictionAndLabelsFpos  = predictionAndLabelsF.filter(predictionAndLabelsF.indexedincome == 1.0)
pF  = predictionAndLabelsFpos.count()
tpF = predictionAndLabelsFpos.filter(predictionAndLabelsFpos.correctedPrediction == 1.0).count()
fprF = fpF / nF
tprF = tpF / pF

print("Cible : TFP =", fpr, ", TVP =", tpr)
print("Résultat Male  : TFP =", fprM, ", TVP =", tprM)
print("Résultat Female : TFP =", fprF, ", TVP =", tprF)
Note
Vu que les changements de prédictions sont appliqués aléatoirement à des taux faibles, sur un échantillon limité (données de test ici), il ne faut pas s’attendre à une égalité parfaite entre les TFP et TVP des deux groupes après correction.
Question
Affichez un graphique permettant de vérifier visuellement si la correction a bien l’effet escompté.
Correction
plt.title('Modèle corrigé qui respecte le critère de séparation')
plt.xlabel('Taux de faux positifs')
plt.ylabel('Taux de vrais positifs')
plt.plot([0.0, fprAdj, 1.0], [0.0, tprAdj, 1.0], label='Tous')
plt.plot([0.0, fprM, 1.0],   [0.0, tprM, 1.0],   label='Male')
plt.plot([0.0, fprF, 1.0],   [0.0, tprF, 1.0],   label='Female')
plt.plot([0.0, 1.0], [0.0, 1.0], 'k--')
plt.legend(loc='lower right')
Le résultat devrait ressembler à :
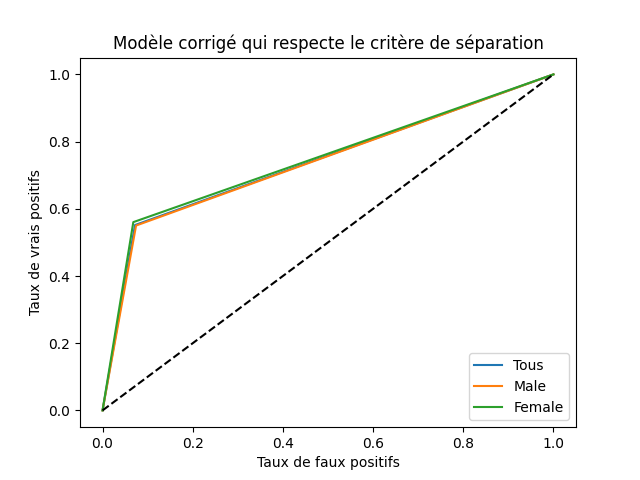
Fig. 117 Effet de la correction : les droites Male et Female convergent vers le point cible
Conclusion
Nous avons constaté, dans l’analyse et la modélisation des données Adult :
Les données contiennent des variables protégées suivant ECOA :
age,maritalstatus,race,sex,nativecountry. Un modèle construit avec toutes ces variables ne respecterait pas cette réglementation.En supprimant ces variables protégées de la modélisation, les performances ne se dégradent pas significativement. Cela montre que les informations contenues dans les variables protégées sont largement redondantes avec les autres variables.
Les modèles obtenus ne respectent pas les critères observationnels d’équité, même en supprimant les variables protégées. La suppression des variables protégées ne suffit pas à garantir le respect des critères d’équité : les variables restantes permettent de prédire en partie les attributs protégés (via des corrélations cumulées).
Un post-traitement permet de corriger un modèle pré-appris. La méthode de [HPS16] change les prédictions d’un modèle existant pour que le modèle corrigé respecte le critère equalized odds. La diminution de performance (accuracy) est faible dans notre exemple.
Pour corriger les prédictions, il est indispensable d’avoir accès à l’attribut protégé lors de la prédiction, même si le modèle initial a été développé sans lui.
Hardt, M., Price, E., Srebro, N. Equality of Opportunity in Supervised Learning. 2016. https://arxiv.org/abs/1610.02413