

Work in progress
Contenu rédigé à partir des diapositives coursDeep5.pdf et coursDeep6.pdf, faute de source préexistante pour cette séance. Susceptible d’être ajusté.
Les informations pratiques concernant le déroulement de l’unité d’enseignement RCP209 « Apprentissage, réseaux de neurones et modèles graphiques » au Cnam se trouvent dans ce préambule.
XII.1 - Cours#
[Diapositives du cours (Partie 1)] [Diapositives du cours (Partie 2)]
Modélisation décisionnelle sur des séquences#
Jusqu’à présent, les modèles étudiés (perceptrons multi-couches, réseaux convolutifs) prennent en entrée un vecteur ou un tenseur de dimension fixe. De nombreux problèmes concernent pourtant des données naturellement organisées en séquences : une séquence est une suite d’observations \(\{x_t\}\) pour \(t \in \{1, \dots, T\}\), avec \(\mathbf x_t \in \mathbb R^d\). En général, l’observation au pas de temps \(t\) peut dépendre des observations aux pas de temps antérieurs \(x_{t'}\) pour \(t' \leq t\) (on parle de causalité). Des exemples typiques de séquences sont les séries temporelles (mesures physiques, cours financiers), le texte (séquences de mots ou de caractères), l’ADN, ou encore les journaux d’événements (logs).
On cherche à construire une fonction \(f\) permettant de prédire une sortie \(y_t\) à partir de l’entrée \(x_t\) (et, potentiellement, de tout ou partie de son historique).
Limites des modèles déjà vus#
Perceptron multi-couche sur une fenêtre glissante. Comme pour les SVM ou les forêts aléatoires, on peut traiter une séquence à l’aide d’un PMC appliqué sur une fenêtre de taille fixe \(L\), c’est-à-dire que l’on prédit \(y_t = f(x_{t-L}, \dots, x_{t-1}, x_t)\). Cette approche souffre de plusieurs limites :
si le contexte temporel nécessaire est grand, \(L\) doit être grand, ce qui augmente fortement le nombre de paramètres du modèle,
les prédictions à deux pas de temps successifs sont indépendantes l’une de l’autre : le modèle n’a aucune « mémoire » de \(y_{t-1}\) lorsqu’il calcule \(y_t\),
il est impossible de traiter des séquences de longueur variable, sauf à les redécouper en fenêtres de taille fixe.
Réseau convolutif 1D. Une convolution à noyaux unidimensionnels sur une fenêtre de taille \(L\) réduit le nombre de paramètres par rapport au PMC (les poids sont partagés le long du temps) et extrait de l’information plus locale, mais souffre des deux mêmes limites : contexte borné par \(L\) et incapacité à traiter des séquences de longueur variable à cause de la dernière couche, qui reste entièrement connectée.
Modèles graphiques. Une prédiction structurée, modélisant explicitement les liens entre \(f(x_t)\) et les \(f(x_{t'})_{t' \leq t}\) (par exemple des chaînes de Markov ou des champs aléatoires conditionnels, CRF), permet de gérer des séquences de longueur variable, mais reste limitée à des prédicteurs linéaires et nécessite une procédure d’inférence complexe, en général non exacte, dès que l’on sort de l’hypothèse de Markov (le futur ne dépend que d’un nombre limité de valeurs passées).
Aucune de ces trois familles de modèles ne permet donc de traiter nativement des séquences de longueur arbitraire tout en conservant une mémoire de tout l’historique passé. C’est ce que vont permettre les réseaux de neurones récurrents [5GBC16].
Réseaux de neurones récurrents#
Cellule récurrente#
L’idée centrale des réseaux récurrents (Recurrent Neural Networks, RNN), introduits par Elman (1990), est d’introduire un état interne \(\mathbf h_t \in \mathbb R^l\), qui joue le rôle de mémoire du réseau, mis à jour à chaque pas de temps par une même fonction \(\phi\) :
Deux points sont essentiels dans cette définition :
il s’agit d’une récurrence : \(\mathbf h_t\) dépend de l’observation courante \(\mathbf x_t\) et de l’état interne précédent \(\mathbf h_{t-1}\), qui résume tout l’historique \(\mathbf x_1, \dots, \mathbf x_{t-1}\) ;
la fonction \(\phi\) est identique (« partagée ») pour tous les pas de temps \(t\), comme le sont les poids d’une couche convolutive le long de l’image. On peut se représenter la cellule récurrente soit sous sa forme repliée (un unique bloc qui se réinjecte lui-même), soit sous sa forme « dépliée » (unfolded) dans le temps, qui fait apparaître un état interne différent à chaque pas de temps \(\mathbf h_0, \mathbf h_1, \dots, \mathbf h_T\).
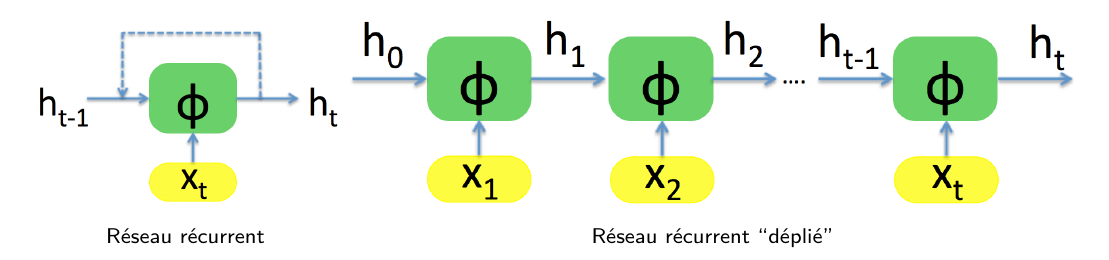
Fig. 111 La cellule récurrente sous sa forme repliée (à gauche) et sa forme « dépliée » dans le temps (à droite).#
Dans la formulation la plus courante, \(\phi\) est une projection linéaire de \(\mathbf x_t\) et de \(\mathbf h_{t-1}\) suivie d’une non-linéarité :
où, si l’on choisit une dimension \(l\) pour l’état caché \(\mathbf h_t\), \(\mathbf U\) est une matrice \((l \times d)\), \(\mathbf W\) est une matrice \((l \times l)\), \(\mathbf b_h\) est un vecteur de biais de longueur \(l\), et \(f\) est une fonction d’activation non-linéaire, généralement \(\tanh\).
Pour produire une sortie à chaque pas de temps, on ajoute une couche entièrement connectée entre l’état interne et la sortie :
où \(f'\) peut être l’identité (pour une tâche de régression) ou une activation softmax (pour une tâche de classification). Les matrices \(\mathbf U\), \(\mathbf W\), \(\mathbf V\) et les biais \(\mathbf b_h\), \(\mathbf b_y\) sont les paramètres appris du réseau ; ils sont, comme \(\phi\), partagés par tous les pas de temps.
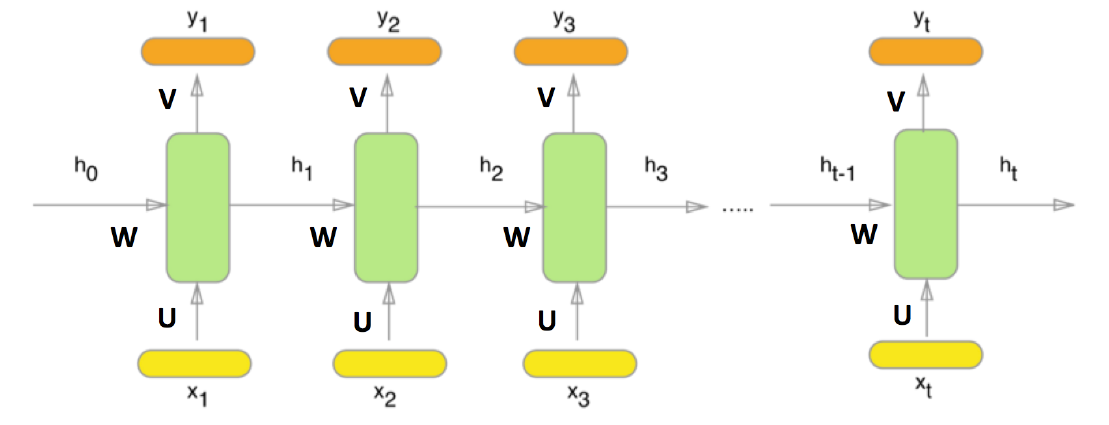
Fig. 112 Réseau récurrent complet : les matrices \(\mathbf U\), \(\mathbf W\), \(\mathbf V\) sont identiques (partagées) à chaque pas de temps.#
Capacités de modélisation#
De même que les réseaux entièrement connectés sont des approximateurs universels de fonction, les RNN bénéficient de résultats théoriques similaires sur les transformations entre séquences \(\{\mathbf x_t\}\) et \(\{\mathbf y_t\}\) : les RNN sont des approximateurs universels de programme (ils peuvent approximer n’importe quelle fonction calculable, un résultat proche des machines de Turing, Siegelmann et Sontag, 1995) et peuvent approcher n’importe quelle transformation séquence-à-séquence mesurable (Hammer, 2000).
Entraînement : rétropropagation à travers le temps#
Comme pour les réseaux de neurones classiques, on entraîne un RNN en comparant la sortie prédite \(\{\mathbf y_t\}_{t \in \{1;T\}}\) à une vérité de terrain (supervision) \(\{\mathbf y_t^*\}\). On définit une erreur à chaque pas de temps \(\mathcal L_t(\mathbf y_t, \mathbf y_t^*)\) (par exemple l’entropie croisée pour une tâche de classification), et l’erreur totale est la somme de ces erreurs sur toute la séquence :
Pour optimiser le modèle par descente de gradient, on applique la rétropropagation sur la vue « dépliée » du réseau récurrent (Werbos, 1988), en la considérant comme un unique réseau entièrement connecté très profond, à poids partagés entre les différentes couches (les différents pas de temps). Cet algorithme est appelé rétropropagation à travers le temps (Back-Propagation Through Time, BPTT).
La difficulté propre au BPTT, par rapport à la rétropropagation classique, est que les paramètres \(\mathbf W\), \(\mathbf U\), \(\mathbf V\) étant partagés pour tous les pas de temps, le gradient par rapport à, par exemple, \(\mathbf W\), dépend de tout l’historique passé :
Le terme \(\frac{\partial \mathbf h_t}{\partial \mathbf h_k}\) se calcule, par la règle de dérivation en chaîne, comme un produit de jacobiennes le long de tout le chemin entre \(k\) et \(t\) :
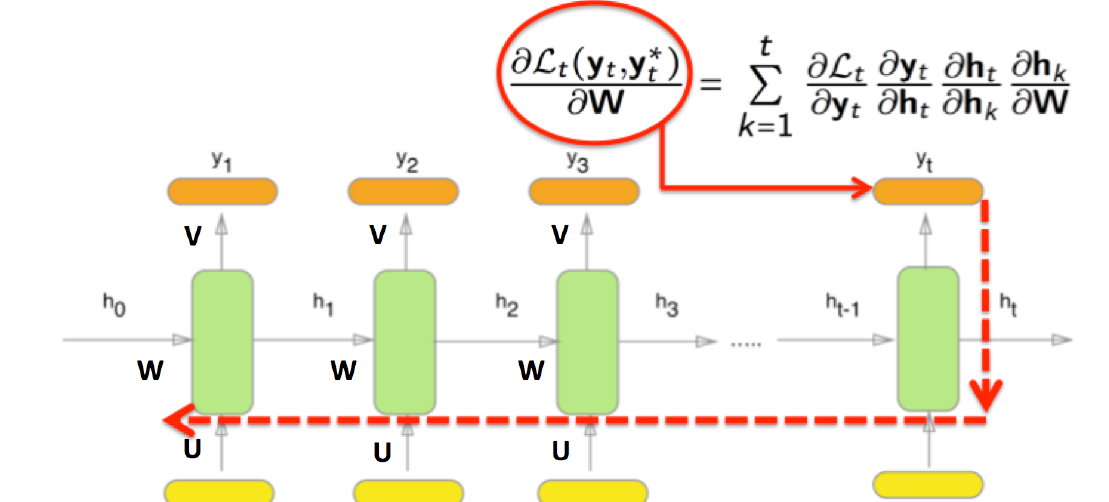
Fig. 113 Le gradient de l’erreur au temps \(t\) par rapport à \(\mathbf W\) (chemin rouge) doit remonter jusqu’à chaque pas de temps \(k \leq t\) du réseau déplié.#
Si la séquence \(T\) est grande, le réseau déplié est très profond et la rétropropagation devient coûteuse en mémoire et en temps de calcul. En pratique, on évite souvent de rétropropager sur tout le graphe en tronquant l’algorithme à une fenêtre de \(k\) pas de temps : on parle de BPTT tronquée.
Gradients explosifs et évanescents#
Le produit de jacobiennes ci-dessus se majore par
où \(\beta_h\) dépend de l’activation utilisée (\(\beta_h = 1\) pour \(\tanh\), \(\beta_h = 0{,}25\) pour la sigmoïde) et \(\beta_w\) dépend de la plus grande valeur propre de \(\mathbf W\). On distingue alors deux cas :
si \(\beta_h \cdot \beta_w > 1\), le gradient croît exponentiellement avec \(t\) : c’est le phénomène de gradient explosif (exploding gradient) ;
si \(\beta_h \cdot \beta_w < 1\), le gradient décroît exponentiellement avec \(t\) : c’est le phénomène de gradient évanescent (vanishing gradient).
Ce phénomène concerne en réalité tous les réseaux profonds (voir le cours sur les algorithmes modernes de descente de gradient), mais il est fortement exacerbé par la « profondeur » propre aux RNN : un même facteur multiplicatif \(\mathbf W^T \mathrm{diag}[f'(\cdot)]\) est répété à chaque pas de temps, si bien que même une séquence de longueur modeste (quelques dizaines de pas de temps) correspond déjà à un réseau extrêmement profond une fois déplié.
Les gradients explosifs sont relativement faciles à détecter (la fonction de coût diverge ou devient NaN) et à corriger :
tronquer la BPTT, au prix d’une capacité réduite à modéliser des dépendances temporelles longues,
régulariser les poids, par exemple via une pénalité \(\lVert \mathbf W \rVert_2\),
appliquer un gradient clipping : pour un gradient \(\mathbf g\) et un seuil \(\tau\), si \(\lVert \mathbf g \rVert > \tau\), alors \(\mathbf g \leftarrow \frac{\tau}{\lVert \mathbf g \rVert} \mathbf g\).
Les gradients évanescents sont plus problématiques, car plus difficiles à diagnostiquer (l’entraînement semble simplement ne plus progresser). Les solutions possibles sont, par ordre de préférence croissant :
tronquer la BPTT (même limite que ci-dessus),
utiliser une activation ReLU plutôt que \(\tanh\) ou la sigmoïde,
utiliser des optimiseurs de quasi-second ordre, plus coûteux et plus lents à converger,
et, surtout, utiliser une architecture de cellule récurrente spécifique, conçue pour laisser le gradient circuler sans encombre à travers le temps – c’est l’objet de la section suivante.
Architectures récurrentes profondes#
LSTM#
L’architecture LSTM (Long Short-Term Memory, Hochreiter et Schmidhuber, 1997) modifie la cellule récurrente classique en ajoutant un second état, la cellule mémoire \(\mathbf C_t\), qui transite directement d’un pas de temps à l’autre par une succession d’opérations élément-par-élément (pas de multiplication matricielle par \(\mathbf W\)). Le gradient peut ainsi circuler sur ce chemin sans être répété à multiplier par \(\mathbf W^T\) à chaque pas de temps, exactement comme les connexions résiduelles d’un ResNet permettent au gradient de « sauter » certaines couches.
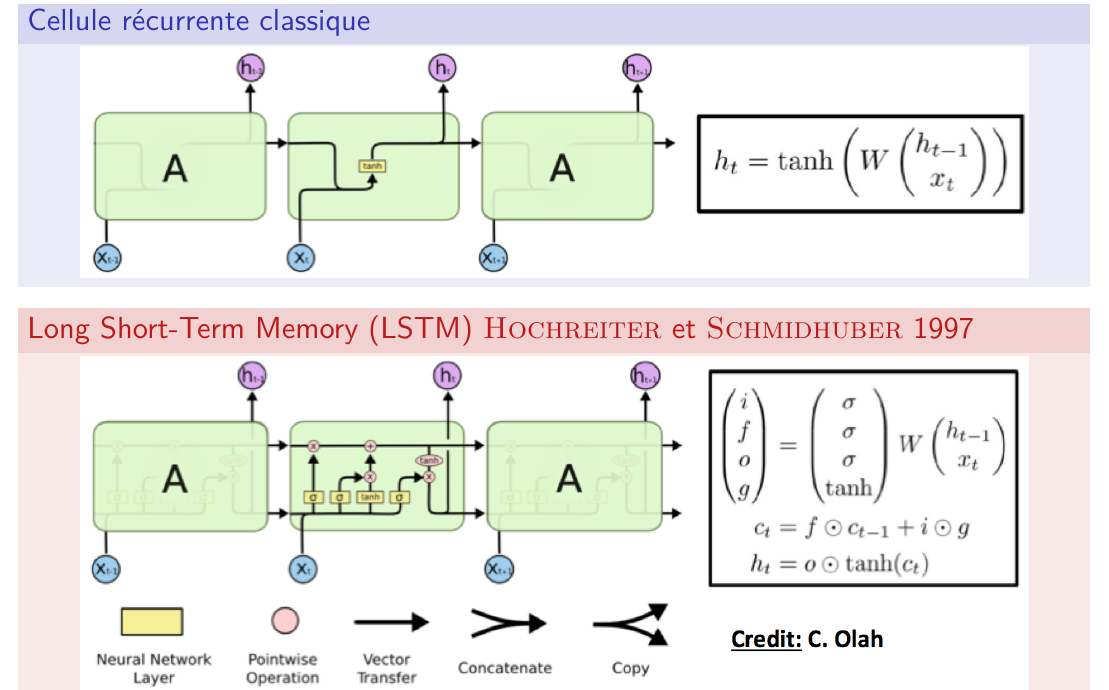
Fig. 114 Cellule récurrente classique (en haut) et cellule LSTM (en bas) : la cellule mémoire \(\mathbf C_t\) (ligne horizontale du haut) transite d’un pas de temps à l’autre par de simples opérations élément-par-élément. Illustration : C. Olah, Understanding LSTM Networks.#
La cellule LSTM lit ou efface l’information de son état interne \(\mathbf C_t\) à l’aide de trois portes (gates), chacune une projection linéaire suivie d’une sigmoïde (qui produit une valeur dans \([0,1]\), interprétable comme un commutateur continu) :
la porte d’oubli (forget gate) \(\mathbf f_t\), qui contrôle la conservation ou l’effacement de la cellule :
\[\mathbf f_t = \sigma(\mathbf W_f \cdot [\mathbf h_{t-1}, \mathbf x_t] + \mathbf b_f)~;\]la porte d’entrée (input gate) \(\mathbf i_t\), qui contrôle si la cellule est mise à jour, combinée à un candidat de mise à jour \(\tilde{\mathbf C}_t\) :
\[\mathbf i_t = \sigma(\mathbf W_i \cdot [\mathbf h_{t-1}, \mathbf x_t] + \mathbf b_i)~, \qquad \tilde{\mathbf C}_t = \tanh(\mathbf W_C \cdot [\mathbf h_{t-1}, \mathbf x_t] + \mathbf b_C)~;\]la porte de sortie (output gate) \(\mathbf o_t\), qui contrôle la part de l’état interne exposée à la sortie :
\[\mathbf o_t = \sigma(\mathbf W_o \cdot [\mathbf h_{t-1}, \mathbf x_t] + \mathbf b_o)~.\]
La cellule mémoire est alors mise à jour en effaçant, via \(\mathbf f_t\), une partie de son contenu précédent et en y ajoutant, via \(\mathbf i_t\), le nouveau candidat \(\tilde{\mathbf C}_t\) :
et le nouvel état caché (exposé aux couches suivantes et au pas de temps suivant) est une version filtrée, par la porte de sortie, de la cellule mémoire :
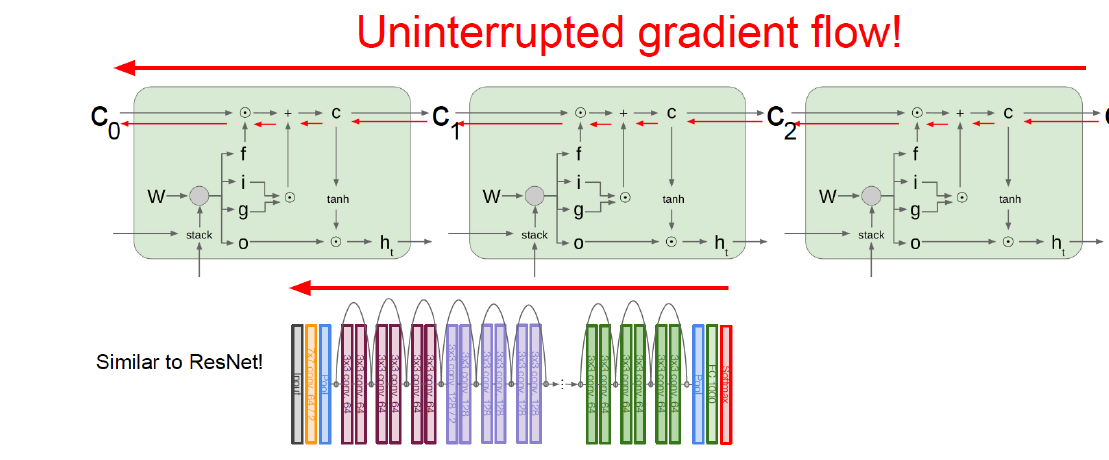
Fig. 115 La cellule mémoire ne subissant que des opérations élément-par-élément (pas de produit par \(\mathbf W\)), le gradient peut y circuler sans être atténué ni amplifié – même intuition que les connexions résiduelles d’un ResNet.#
GRU#
Le GRU (Gated Recurrent Unit, Cho et al., 2014) est une variante simplifiée du LSTM, à moins de paramètres : elle fusionne la porte d’oubli et la porte d’entrée en une unique porte de mise à jour \(\mathbf z_t\), et se passe d’état de cellule séparé – il n’y a plus qu’un seul état, \(\mathbf h_t\), jouant à la fois le rôle de mémoire et de sortie.
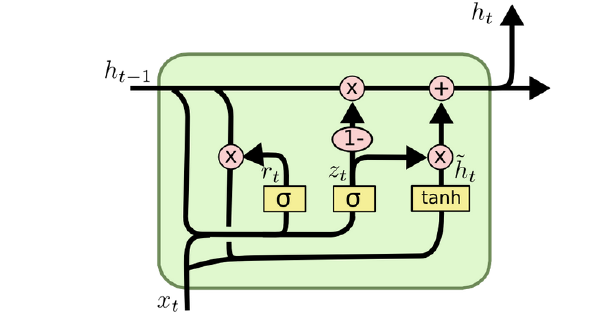
Fig. 116 Cellule GRU : un seul état \(\mathbf h_t\), deux portes (\(\mathbf r_t\), \(\mathbf z_t\)).#
La porte de réinitialisation (reset gate) \(\mathbf r_t\) contrôle la part de l’état précédent utilisée pour calculer le candidat \(\tilde{\mathbf h}_t\), et la porte de mise à jour \(\mathbf z_t\) interpole entre l’ancien état et ce candidat – un rôle analogue à celui, combiné, des portes d’oubli et d’entrée du LSTM.
Le GRU est plus simple à implémenter et plus rapide à entraîner qu’un LSTM (moins de portes, donc moins de paramètres), mais ses performances sont généralement légèrement inférieures à celles d’un LSTM de capacité équivalente. En pratique, les deux architectures sont couramment comparées empiriquement sur la tâche considérée, comme dans le TP de cette séance.
RNN profonds et bidirectionnels#
Comme pour les réseaux entièrement connectés ou convolutifs, on peut empiler plusieurs couches récurrentes (RNN, LSTM ou GRU) les unes sur les autres : la séquence des états cachés produits par la première couche sert de séquence d’entrée à la deuxième couche, et ainsi de suite. On parle de RNN (ou LSTM, GRU) profond. Cela permet d’apprendre des représentations de complexité croissante, comme la profondeur le permet pour les réseaux convolutifs.
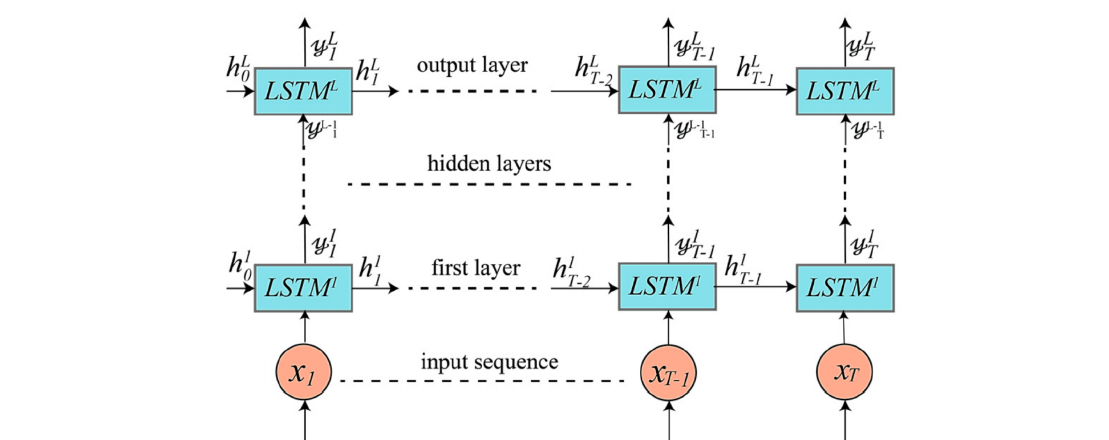
Fig. 117 Un RNN (ici, LSTM) profond : la sortie de chaque couche sert de séquence d’entrée à la couche suivante.#
Pour certains problèmes, l’hypothèse de causalité (la sortie au temps \(t\) ne dépend que du passé) n’est pas justifiée : par exemple, pour la traduction automatique, le sens d’un mot dépend souvent aussi des mots qui le suivent. On peut alors utiliser un RNN bidirectionnel, qui applique en parallèle deux RNN indépendants – l’un lisant la séquence dans l’ordre croissant du temps, l’autre dans l’ordre décroissant – puis concatène leurs états internes respectifs :
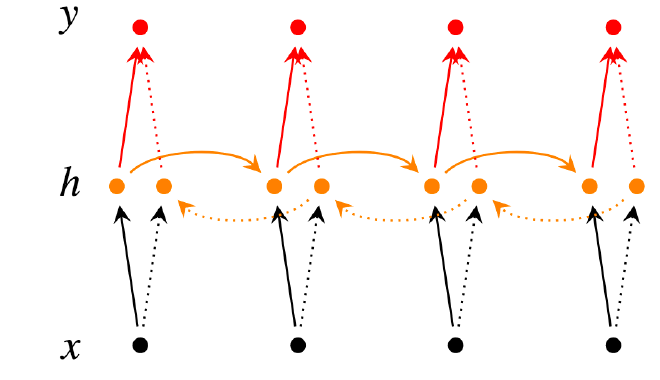
Fig. 118 RNN bidirectionnel : un état \(\overrightarrow{\mathbf h}_t\) calculé de gauche à droite (orange plein) et un état \(\overleftarrow{\mathbf h}_t\) calculé de droite à gauche (orange pointillé), concaténés en \(\mathbf h_t\).#
L’état \(\mathbf h_t\) ainsi obtenu résume à la fois le passé et le futur autour de la position \(t\). Un RNN bidirectionnel n’a en revanche de sens que si la séquence complète est disponible au moment de la prédiction : il est par construction inutilisable pour prédire le futur d’une séquence (comme dans le TP de cette séance), puisque cela nécessiterait de connaître déjà les observations futures.
Applications#
Les problèmes séquentiels se répartissent en quelques grandes familles, selon la façon dont les longueurs des séquences d’entrée et de sortie se correspondent :
many-to-one : une séquence en entrée, une unique valeur en sortie (par exemple, classer un texte, ou prédire une unique valeur future à partir d’un historique – c’est le cas du TP de cette séance) ;
one-to-many : une entrée unique, une séquence en sortie (par exemple, générer la légende d’une image) ;
many-to-many : une séquence en entrée, une séquence en sortie, les deux pouvant être de longueurs différentes (par exemple, la traduction automatique) ;
many-to-many parallèle : une séquence en entrée, une séquence de sortie synchronisée pas à pas avec l’entrée (par exemple, prédire à chaque instant \(t\) la valeur à \(t+1\)).
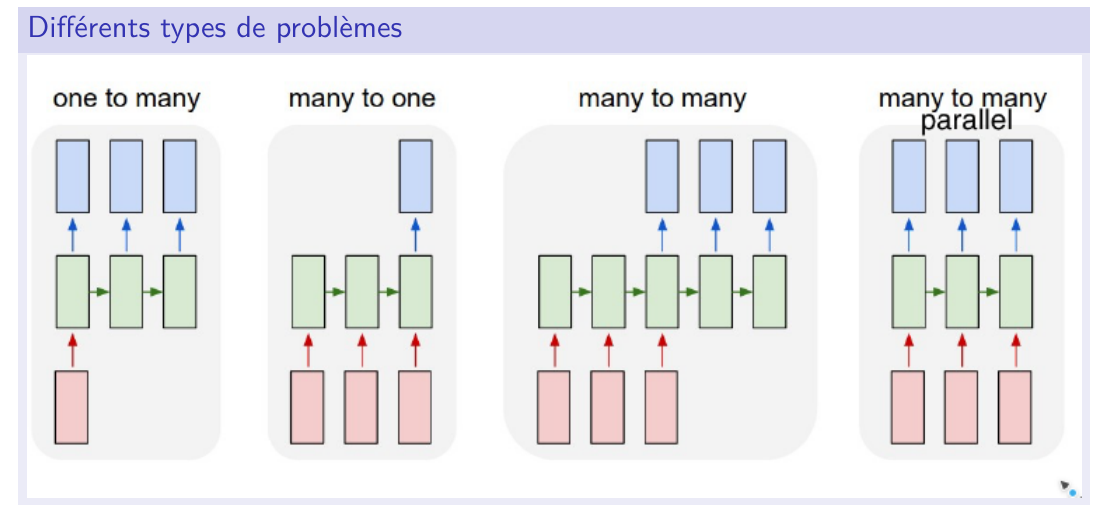
Fig. 119 Les quatre grandes familles de problèmes séquentiels (en rose, l’entrée ; en vert, l’état interne ; en bleu, la sortie).#
Prédiction de séries temporelles#
C’est le cas d’application étudié dans le TP de cette séance : prédiction (mono- ou multi-variée) de séries temporelles, en général sous la forme d’un problème many-to-one (prédire une valeur future à partir d’un historique de longueur fixe), avec comparaison empirique entre cellule RNN classique et cellules à portes (GRU, LSTM).
Une extension notable concerne les données spatio-temporelles (par exemple des séquences vidéo), qui combinent une structure spatiale (comme les images) et une structure temporelle. Des architectures hybrides comme le ConvLSTM (Shi et al., 2015) remplacent les projections linéaires du LSTM par des convolutions, pour tirer parti à la fois de la structure spatiale locale (comme un CNN) et de la mémoire temporelle (comme un LSTM).
Traitement automatique du langage#
Bien que ce TP ne porte pas sur le traitement du langage, les RNN (et en particulier les LSTM/GRU) en ont longtemps été l’outil de référence, avant l’avènement des Transformers (voir le cours de la séance suivante). Pour mémoire, quelques exemples d’applications typiques :
encodage du texte : un texte doit d’abord être représenté numériquement, par exemple en tokens (mots ou caractères) encodés en one-hot, ou, mieux, par un plongement lexical (word embedding, par exemple Word2vec ou GloVe) appris de sorte que la similarité entre deux vecteurs reflète la similarité sémantique entre les mots correspondants (les architectures Transformer, dont BERT, ont depuis largement remplacé ces approches, voir le cours suivant) ;
classification de texte (many-to-one) : par exemple, prédire le sentiment (positif/négatif) exprimé dans un avis ;
traduction automatique (many-to-many, modèles dits séquence à séquence) : un premier RNN encode la phrase source en un état interne résumé, un second RNN décode cet état en une phrase dans la langue cible ;
description d’images (one-to-many) : un CNN encode l’image en un vecteur, qui initialise l’état interne d’un RNN chargé de générer une légende en langage naturel, mot par mot.
Ian Goodfellow, Yoshua Bengio, and Aaron Courville. Deep Learning. MIT Press, 2016.