

X.2 - Travaux pratiques#
L’objectif de cette séance de travaux pratiques est de découvrir la bibliothèque PyTorch et ses fonctionnalités pour la création et l’apprentissage de réseaux de neurones profonds. En particulier, nous allons reprendre les deux modèles vus précédemment (régression logistique et perceptron) pour montrer comment les implémenter avec PyTorch. Nous verrons également un premier modèle simple de réseau de neurones profonds convolutif.
Importation de PyTorch#
PyTorch est une bibliothèque logicielle open-source pour l’apprentissage profond, développée par Meta AI. Elle implémente les briques de base (opérations tensorielles, couches, fonctions de transfert, différentiation automatique) et gère notamment la possibilité d’exécuter un réseau de neurones sur le processeur (CPU) ou sur accélérateur graphique matériel (GPU).
import torch
from torch import nn

# Graine aléatoire, pour la reproductibilité (initialisation des poids, ordre des batches)
torch.manual_seed(42)
Contrairement à Keras, qui automatise l’apprentissage d’un modèle à l’aide des méthodes .compile()
et .fit(), PyTorch expose directement la boucle d’apprentissage (calcul de la prédiction, de l’erreur,
des gradients, puis mise à jour des paramètres). C’est un peu plus verbeux à écrire, mais cela permet de
garder le contrôle total sur ce qui se passe à chaque itération — ce qui nous sera utile dans les séances
suivantes.
PyTorch intègre, via le sous-module torchvision, des utilitaires pour charger et manipuler un certain
nombre de jeux de données populaires, comme MNIST :
from torchvision import datasets

# Chargement du jeu de données MNIST (téléchargé puis mis en cache dans ./data)
mnist_train = datasets.MNIST(root='data', train=True, download=True)
mnist_test = datasets.MNIST(root='data', train=False, download=True)

# Redimensionnement des images 28x28 en vecteurs d=784
X_train = mnist_train.data.reshape(-1, 784).float()
X_test = mnist_test.data.reshape(-1, 784).float()
y_train = mnist_train.targets
y_test = mnist_test.targets

# Normalisation entre 0 et 1
X_train /= 255
X_test /= 255
Note
Contrairement à Keras, qui attend des étiquettes au format one-hot encoding pour les fonctions de coût
de classification, PyTorch attend directement l’indice entier de la classe (ici, y_train et y_test
restent des vecteurs d’entiers entre 0 et 9). C’est la fonction de coût nn.CrossEntropyLoss elle-même
qui se charge, en interne, de comparer cet indice à la distribution prédite.
Enfin, pour parcourir les données par batch pendant l’apprentissage, PyTorch fournit les classes
TensorDataset et DataLoader :
from torch.utils.data import TensorDataset, DataLoader

train_dataset = TensorDataset(X_train, y_train)
train_loader = DataLoader(train_dataset, batch_size=300, shuffle=True)
train_loader peut ensuite être parcouru dans une boucle for batch_X, batch_y in train_loader: pour
obtenir successivement chaque batch d’exemples.
Régression logistique avec PyTorch#
PyTorch propose plusieurs façons différentes de définir un réseau de neurones. La façon la plus simple pour
les réseaux à propagation avant (feedforward), qui empilent les couches de façon séquentielle, est
d’utiliser la classe nn.Sequential (voir sa documentation),
un équivalent direct de la classe Sequential de Keras :
model = nn.Sequential(
    nn.Linear(784, 10),
)
nn.Linear(784, 10) définit une couche entièrement connectée (l’équivalent de Dense sous Keras), qui
projette un vecteur d’entrée de dimension 784 vers un vecteur de sortie de dimension 10.
Note
On ne place pas ici d’activation softmax explicite en sortie du modèle : nn.CrossEntropyLoss
(utilisée plus bas) applique elle-même un log_softmax en interne, de façon numériquement plus stable
que d’enchaîner un softmax puis un logarithme séparément. Le modèle renvoie donc directement des scores
bruts (logits), pas des probabilités.
On peut visualiser l’architecture du réseau en affichant simplement le modèle, et compter le nombre de paramètres à l’aide d’une petite fonction utilitaire :
print(model)

n_params = sum(p.numel() for p in model.parameters())
print(f"Nombre de paramètres : {n_params}")
Question
Quel modèle de prédiction reconnaissez-vous ? Vérifier le nombre de paramètres du réseau.
Correction
Il s’agit d’une régression logistique. Le nombre total de paramètres est bien de 7850 (784 x 10 poids, plus 10 biais).
En plus de la définition de l’architecture, nous avons encore besoin de spécifier deux éléments avant
d’entraîner notre modèle : une fonction de coût (loss) et une méthode d’optimisation. Nous allons utiliser
l’entropie croisée (nn.CrossEntropyLoss) comme fonction de coût et la descente de gradient stochastique
(stochastic gradient descent, torch.optim.SGD) :
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.5)
Question
À l’aide de la documentation de SGD, déterminer à quoi correspond le paramètre lr=.
Correction
lr (learning rate) est le pas d’apprentissage utilisé par la descente de gradient, c’est-à-dire
le coefficient \(\eta\) par lequel les gradients sont multipliés avant d’être soustraits aux paramètres.
Contrairement à Keras, où la boucle d’apprentissage est entièrement automatisée par la méthode .fit(),
avec PyTorch on écrit explicitement, pour chaque batch, les quatre étapes suivantes : (1) calculer la
prédiction du modèle, (2) calculer l’erreur par rapport aux étiquettes, (3) calculer les gradients de
l’erreur par rapport aux paramètres (rétropropagation), (4) mettre à jour les paramètres avec l’optimiseur.
n_epochs = 10

for epoch in range(n_epochs):
    for batch_X, batch_y in train_loader:
        # 1) Calcul de la prédiction (forward)
        outputs = model(batch_X)
        # 2) Calcul de l'erreur
        loss = criterion(outputs, batch_y)
        # 3) Calcul des gradients (backward)
        optimizer.zero_grad()
        loss.backward()
        # 4) Mise à jour des paramètres
        optimizer.step()
    print(f"Epoch {epoch}: loss = {loss.item():.4f}")
batch_size(passé plus haut àDataLoader) correspond au nombre d’exemples utilisé pour estimer le gradient de la fonction de coût.n_epochsest le nombre d’époques (i.e. passages sur l’ensemble des exemples de la base d’apprentissage) lors de la descente de gradient.optimizer.zero_grad()est nécessaire car PyTorch accumule par défaut les gradients à chaque appel de.backward(); il faut donc explicitement les remettre à zéro avant de calculer ceux du batch courant.
L’évaluation des performances du modèle sur le jeu de test se fait en calculant nous-mêmes la métrique
souhaitée, à l’intérieur d’un bloc torch.no_grad() (qui désactive le calcul, inutile ici, des gradients) :
with torch.no_grad():
    outputs = model(X_test)
    test_loss = criterion(outputs, y_test)
    accuracy = (outputs.argmax(dim=1) == y_test).float().mean()
print(f"Erreur de test : {test_loss.item()*100:.2f}")
print(f"Accuracy de test : {accuracy.item()*100:.2f}")
Question
Comparer les performances obtenues par cette régression logistique implémentée avec PyTorch avec celles obtenues lors du premier TP. Conclure.
Perceptron avec PyTorch#
Nous pouvons maintenant enrichir ce modèle de régression logistique en insérant une couche de neurones cachés complètement connectée ainsi qu’une fonction d’activation non linéaire de type sigmoïde entre la couche d’entrée et la couche de sortie. Ce nouveau modèle va ainsi correspondre au réseau de neurones à une couche cachée (perceptron) vu précédemment.
Question
Créer un nouveau modèle model = nn.Sequential(...) et le compléter en lui
ajoutant :
une couche entièrement connectée avec 100 neurones cachés,
une activation sigmoide (
nn.Sigmoid()),une couche entièrement connectée avec 10 neurones de sortie,
de sorte à retrouver le multi-layer perceptron du TP précédent. On rappelle qu’aucune activation
n’est nécessaire après la dernière couche (voir la note plus haut sur nn.CrossEntropyLoss).
model = ... # À compléter
Correction
model = nn.Sequential(
    nn.Linear(784, 100),
    nn.Sigmoid(),
    nn.Linear(100, 10),
)
Question
Combien ce modèle a-t-il de paramètres ? Justifier le calcul et vérifier à l’aide du décompte des paramètres du modèle.
Correction
Ce modèle a \(784 \times 100 + 100\) paramètres pour la première couche cachée puis \(100 \times 10 + 10\) paramètres pour la couche de sortie, soit un total de 79510 paramètres à optimiser.
L’entraînement de ce nouveau modèle s’effectue de façon strictement identique à ce que nous avons vu
précédemment : PyTorch ne fait aucune différence entre les modèles une fois qu’ils sont construits, la boucle
d’apprentissage manipule n’importe quel nn.Sequential de la même façon.
Question
Recréer un optimiseur SGD pour ce nouveau modèle, puis l’entraîner sur la base d’apprentissage de MNIST. On utilisera la même fonction de coût et le même pas d’apprentissage que pour la régression logistique.
Correction
optimizer = torch.optim.SGD(model.parameters(), lr=0.5)

n_epochs = 10
for epoch in range(n_epochs):
    for batch_X, batch_y in train_loader:
        outputs = model(batch_X)
        loss = criterion(outputs, batch_y)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    print(f"Epoch {epoch}: loss = {loss.item():.4f}")
Question
Évaluer les performances du perceptron multi-couche sur le jeu de test de MNIST et comparer à celles obtenues lors du précédent TP. Conclure.
Correction
with torch.no_grad():
    outputs = model(X_test)
    accuracy = (outputs.argmax(dim=1) == y_test).float().mean()
print(f"Accuracy de test : {accuracy.item()*100:.2f}")
Question
À l’aide de la documentation de PyTorch, déterminer comment sont initialisés les paramètres du modèle pour les couches entièrement connectées.
Correction
Par défaut, nn.Linear initialise ses poids selon une loi uniforme de Kaiming (une variante de l’initialisation de Glorot, adaptée aux non-linéarités de type ReLU), et ses biais selon une loi uniforme calculée à partir du nombre d’entrées de la couche.
Une fonctionnalité utile de PyTorch est la possibilité de sauvegarder des modèles sur le disque pour les
partager ou les réutiliser plus tard. On sauvegarde en général uniquement les paramètres du modèle
(son state_dict), pas son architecture :
torch.save(model.state_dict(), 'MLP.pt')
Il est possible de recharger un modèle sur le disque, à condition de recréer d’abord une instance du même modèle (l’architecture, elle, n’est pas sauvegardée) :
model = nn.Sequential(
    nn.Linear(784, 100),
    nn.Sigmoid(),
    nn.Linear(100, 10),
)
model.load_state_dict(torch.load('MLP.pt'))
Réseaux de neurones convolutifs avec PyTorch#
Pour cette dernière partie, nous allons passer du réseau entièrement connecté à un modèle convolutif. En effet, les réseaux de neurones convolutifs profonds (Convolutional Neural Networks ou CNN) sont particulièrement adaptés à la reconnaissance d’images.
Les réseaux convolutifs manipulent des images multi-dimensionnelles en entrée (des tenseurs). Comme nous avions initialement transformé nos images en vecteurs, nous allons les redimensionner sous forme d’image.
Note
Contrairement à Keras, qui place par convention le nombre de canaux en dernière position (\(H \times L \times C\), channels-last), PyTorch place le nombre de canaux juste après la dimension de batch (\(C \times H \times L\), channels-first). Pour MNIST (images en niveaux de gris, un seul canal), cela donne :
X_train_img = X_train.reshape(-1, 1, 28, 28)
X_test_img = X_test.reshape(-1, 1, 28, 28)
Par rapport aux réseaux complètement connectés, les réseaux convolutifs utilisent les briques élémentaires suivantes :
Des couches de convolution, qui transforment un tenseur d’entrée de taille \(p \times n_x \times n_y\) en un tenseur de sortie \(n_H \times n_{x'} \times n_{y'}\), où \(n_H\) est le nombre de filtres choisi.
PyTorch implémente bien entendu par défaut les couches convolutives. Il s’agit de la classe nn.Conv2d.
Par exemple, une couche de convolution pour traiter les images d’entrée de MNIST peut être créée de la
manière suivante :
nn.Conv2d(in_channels=1, out_channels=32, kernel_size=5, padding='same')
Dans l’instanciation de cette classe, on retrouve de nombreux arguments :
in_channels=1correspond au nombre de canaux de l’image d’entrée (1 pour une image en niveaux de gris).out_channels=32correspond au nombre de filtres souhaité pour cette couche convolutive.kernel_size=5est la taille (5x5) du noyau de convolution de chacun des filtres.padding='same'ajoute des 0 à l’image d’entrée de sorte à conserver la même taille spatiale en sortie qu’en entrée.
Note
Contrairement à Keras, où la non-linéarité peut être passée directement en argument de la couche de
convolution (activation=...), PyTorch garde les couches de convolution et les fonctions d’activation
séparées : on les enchaîne explicitement dans le nn.Sequential (par exemple nn.Conv2d(...) suivie
de nn.Sigmoid()).
Des couches d’agrégation spatiale (pooling), afin de permettre une invariance aux translations locales. Elles sont implémentées par la classe
nn.MaxPool2d:
nn.MaxPool2d(kernel_size=2)
kernel_size=2est la taille spatiale (2x2) sur laquelle l’opération d’agrégation est effectuée.
Ces deux briques élémentaires peuvent être ajoutées à n’importe quel modèle séquentiel PyTorch, comme les couches entièrement connectées.
Question
Implémenter un réseau de neurones convolutif reprenant l’architecture suivante, similaire à celle du modèle historique LeNet5, illustré ci-dessous :
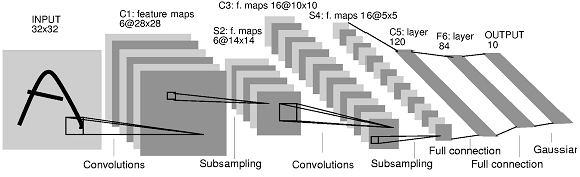
Une couche de convolutions avec 16 filtres de taille \(5 \times 5\) (
padding='same'), suivie d’une non-linéarité sigmoïde puis d’une couche de max pooling \(2 \times 2\).Une couche de convolutions avec 32 filtres de taille \(5 \times 5\) (
padding='same'), suivie d’une non-linéarité sigmoïde puis d’une couche de max pooling \(2 \times 2\).Une seconde couche de convolution avec 64 filtres de taille \(5 \times 5\) (
padding='same'), suivie d’une non linéarité sigmoïde puis d’une couche de max pooling \(2 \times 2\).Comme dans le réseau LeNet, on considérera la sortie du second bloc convolutif comme un vecteur, ce que revient à « mettre à plat » les couches convolutives précédentes (
nn.Flatten()).Une couche complètement connectée de taille 100, suivie d’une sigmoide.
Une couche complètement connectée de taille 10.
On rappelle que MNIST fait \(28\times28\) pixels : après trois poolings \(2\times2\) successifs, la taille spatiale est divisée par \(2^3=8\), soit des cartes de taille \(28/8=3,5\), arrondi à \(3\times3\) par PyTorch. Le nombre d’éléments en entrée de la première couche entièrement connectée est donc \(64 \times 3 \times 3\).
model = nn.Sequential(
    # ...
)
Correction
model = nn.Sequential(
    nn.Conv2d(1, 16, kernel_size=5, padding='same'),
    nn.Sigmoid(),
    nn.MaxPool2d(kernel_size=2),
    nn.Conv2d(16, 32, kernel_size=5, padding='same'),
    nn.Sigmoid(),
    nn.MaxPool2d(kernel_size=2),
    nn.Conv2d(32, 64, kernel_size=5, padding='same'),
    nn.Sigmoid(),
    nn.MaxPool2d(kernel_size=2),
    nn.Flatten(),
    nn.Linear(64 * 3 * 3, 100),
    nn.Sigmoid(),
    nn.Linear(100, 10),
)
Question
Créer un optimiseur, puis entraîner le modèle sur le jeu d’apprentissage de MNIST (au format image, X_train_img). On reprendra la même fonction de coût que précédemment.
Note
Avec un réseau aussi profond (3 couches convolutives) et une non-linéarité sigmoïde, la descente de gradient stochastique classique (SGD), même avec momentum, a tendance à rester bloquée près de son initialisation : les gradients deviennent trop faibles dans les premières couches pour s’en échapper (un symptôme du problème de disparition du gradient, vanishing gradient). On utilisera donc ici l’optimiseur Adam, dont la normalisation adaptative du pas d’apprentissage par paramètre le rend bien plus robuste à ce problème.
Correction
train_dataset = TensorDataset(X_train_img, y_train)
train_loader = DataLoader(train_dataset, batch_size=300, shuffle=True)

optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

n_epochs = 10
for epoch in range(n_epochs):
    for batch_X, batch_y in train_loader:
        outputs = model(batch_X)
        loss = criterion(outputs, batch_y)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    print(f"Epoch {epoch}: loss = {loss.item():.4f}")
torch.save(model.state_dict(), 'LeNet.pt')
Question
Évaluer les performances du modèle sur le jeu de test de MNIST (au format image, X_test_img). Vous devriez obtenir un score proche de 99% pour ce modèle.
Correction
with torch.no_grad():
    outputs = model(X_test_img)
    accuracy = (outputs.argmax(dim=1) == y_test).float().mean()
print(f"Accuracy de test : {accuracy.item()*100:.2f}")
Accélération par GPU#
Avec PyTorch, l’exécution sur GPU se fait en déplaçant explicitement le modèle et les tenseurs de données
sur le périphérique voulu, à l’aide de la méthode .to() :
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model = model.to(device)
# Dans la boucle d'apprentissage, déplacer aussi chaque batch :
# batch_X, batch_y = batch_X.to(device), batch_y.to(device)
Question
(pour aller plus loin) Combien de temps de calcul dure une époque avec ce modèle convolutif ? Comparer sur votre propre machine dotée d’une carte graphique (GPU), sur JupyterHub GPU ou sur Google Colab.
[LBD+89] Yann LeCun, Bernhard Boser, John S Denker, Donnie Henderson, Richard E Howard, Wayne Hubbard, and Lawrence D Jackel. Backpropagation applied to handwritten zip code recognition. Neural computation, 1(4):541–551, 1989.